AI 技术分享
AI 教程、使用技巧与开发经验,帮你把 AI 真正用起来
用户体验ROI的十个数据铁律
UX不是美化,而是增长引擎。十个数据事实证明:设计阶段修错的成本仅为上线后的1/100,性能每慢一秒都可能带来20%转化损失。用数据说服决策者,让UX成为企业生存的核心竞争力。
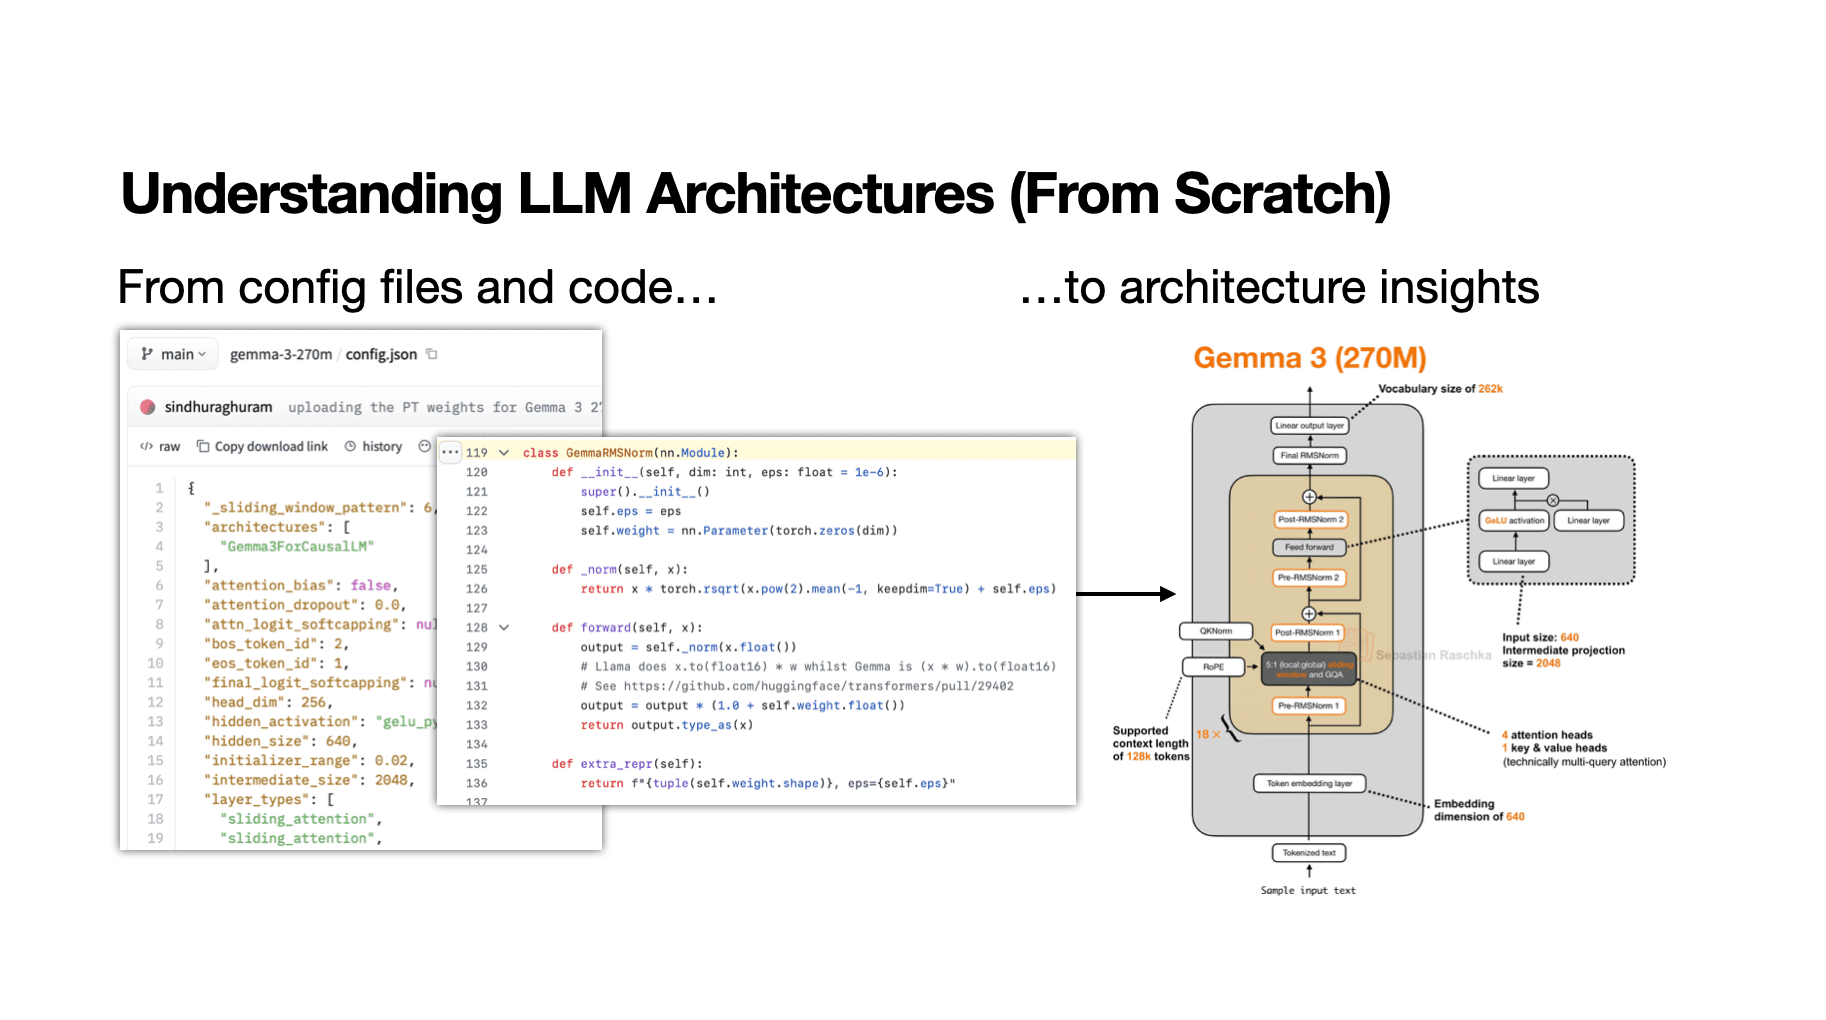
开源大模型架构分析实战指南
面对日益简略的技术报告,开发者如何通过 Hugging Face 和 Transformers 库深入理解开源 LLM 的内部结构?本文分享了一套实用的手动分析工作流。
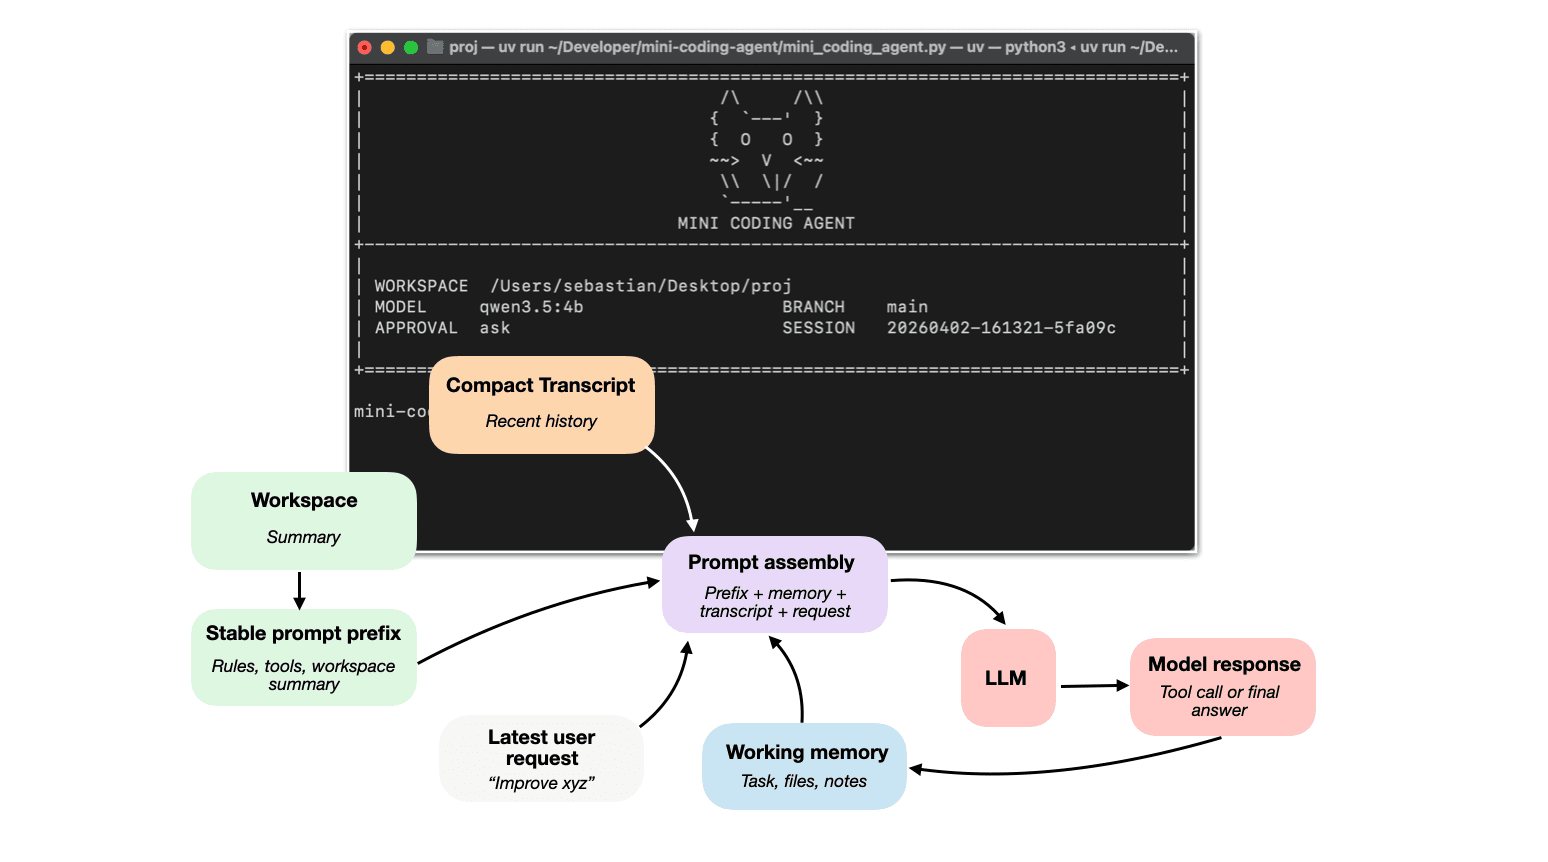
编码智能体的六大核心组件深度解析
本文系统梳理了编码智能体的架构设计,厘清LLM、推理模型与智能体之间的层级关系,帮助开发者理解Claude Code等工具为何比裸模型更强,以及如何在实践中构建自己的编码代理。
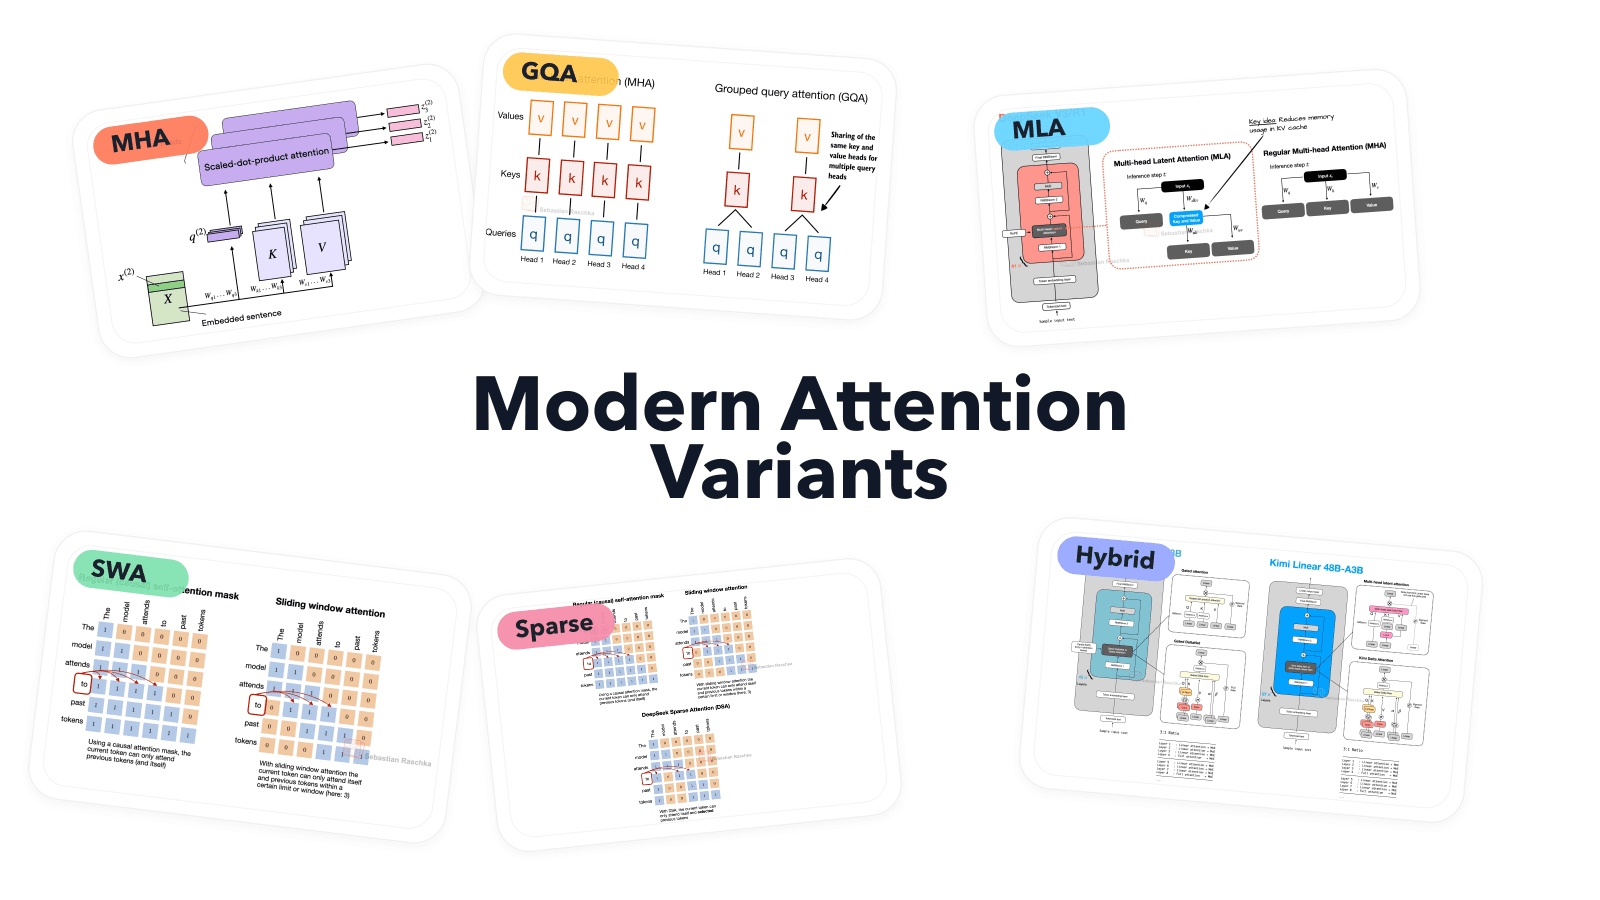
现代LLM注意力机制演进:从MHA到新型架构
作者整理了45种LLM架构,发布可视化画廊与海报,并深入解析了包括MHA在内的核心注意力机制演变及其在翻译任务中的历史背景。
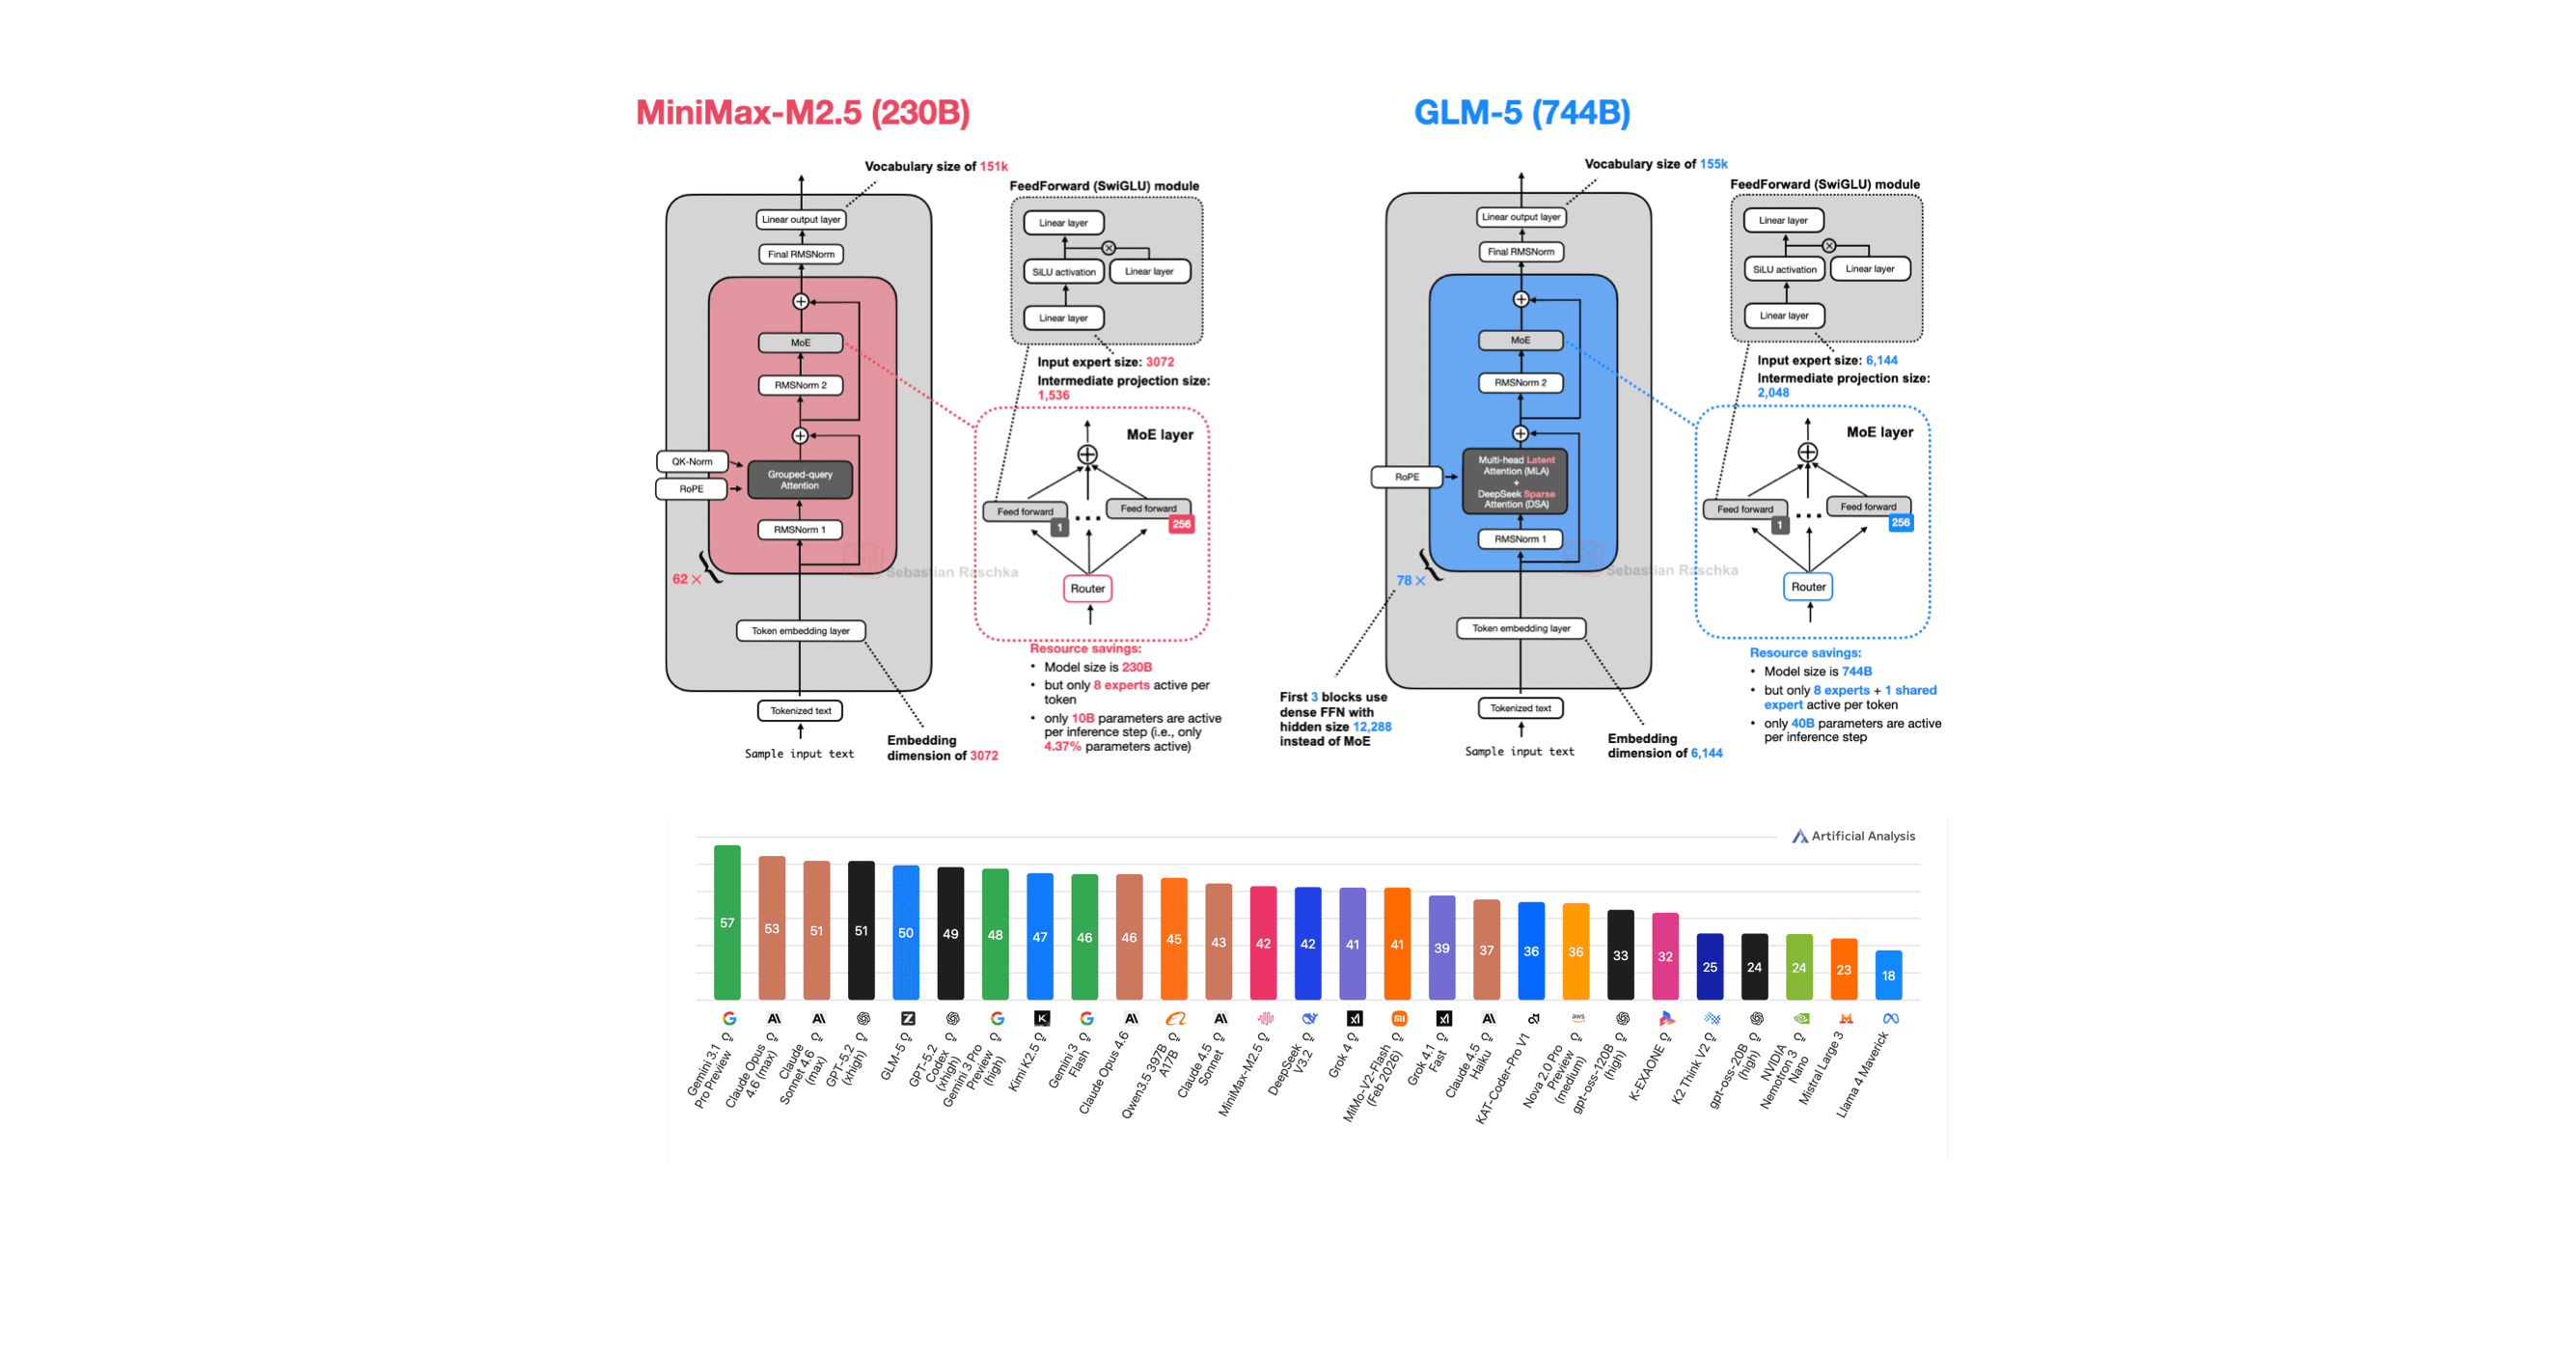
2026 年初开放权重 LLM 架构全景梳理
2026 年 1-2 月密集发布了十余款开放权重大模型,本文梳理其架构共性趋势:MoE 成为标配、滑动窗口注意力走向主流、门控机制与 QK-Norm 提升训练稳定性,帮助开发者快速把握选型方向。
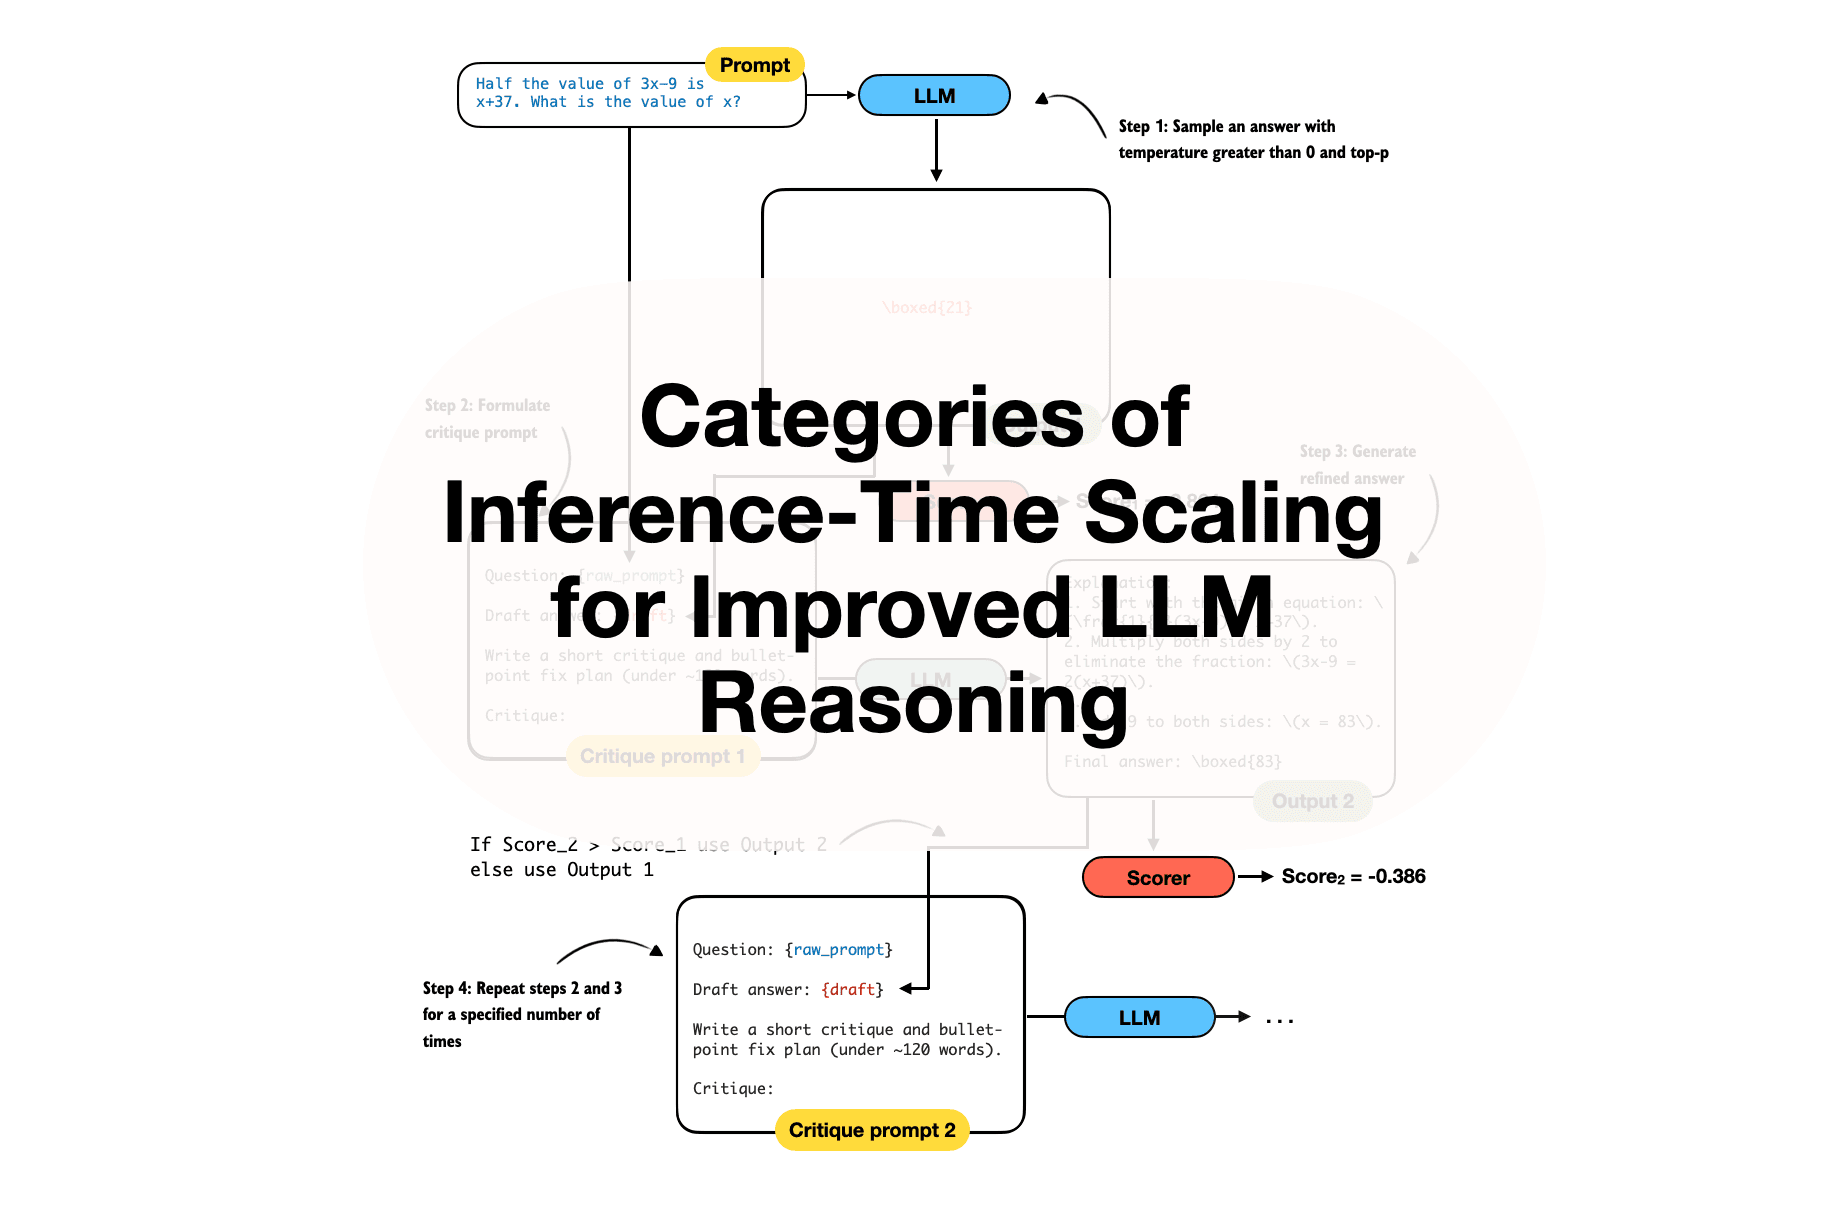
推理时扩展:提升大模型推理能力的五大策略
探索推理时扩展技术,通过增加推理阶段的计算资源来提升大模型准确率,无需重新训练模型。

2025年LLM格局:推理模型、RLVR与DeepSeek时刻
2025年大语言模型迎来推理能力爆发,DeepSeek R1开源模型刷新成本认知,RLVR与GRPO算法为后训练开辟新路径。本文梳理关键进展并解读开发者实用价值。
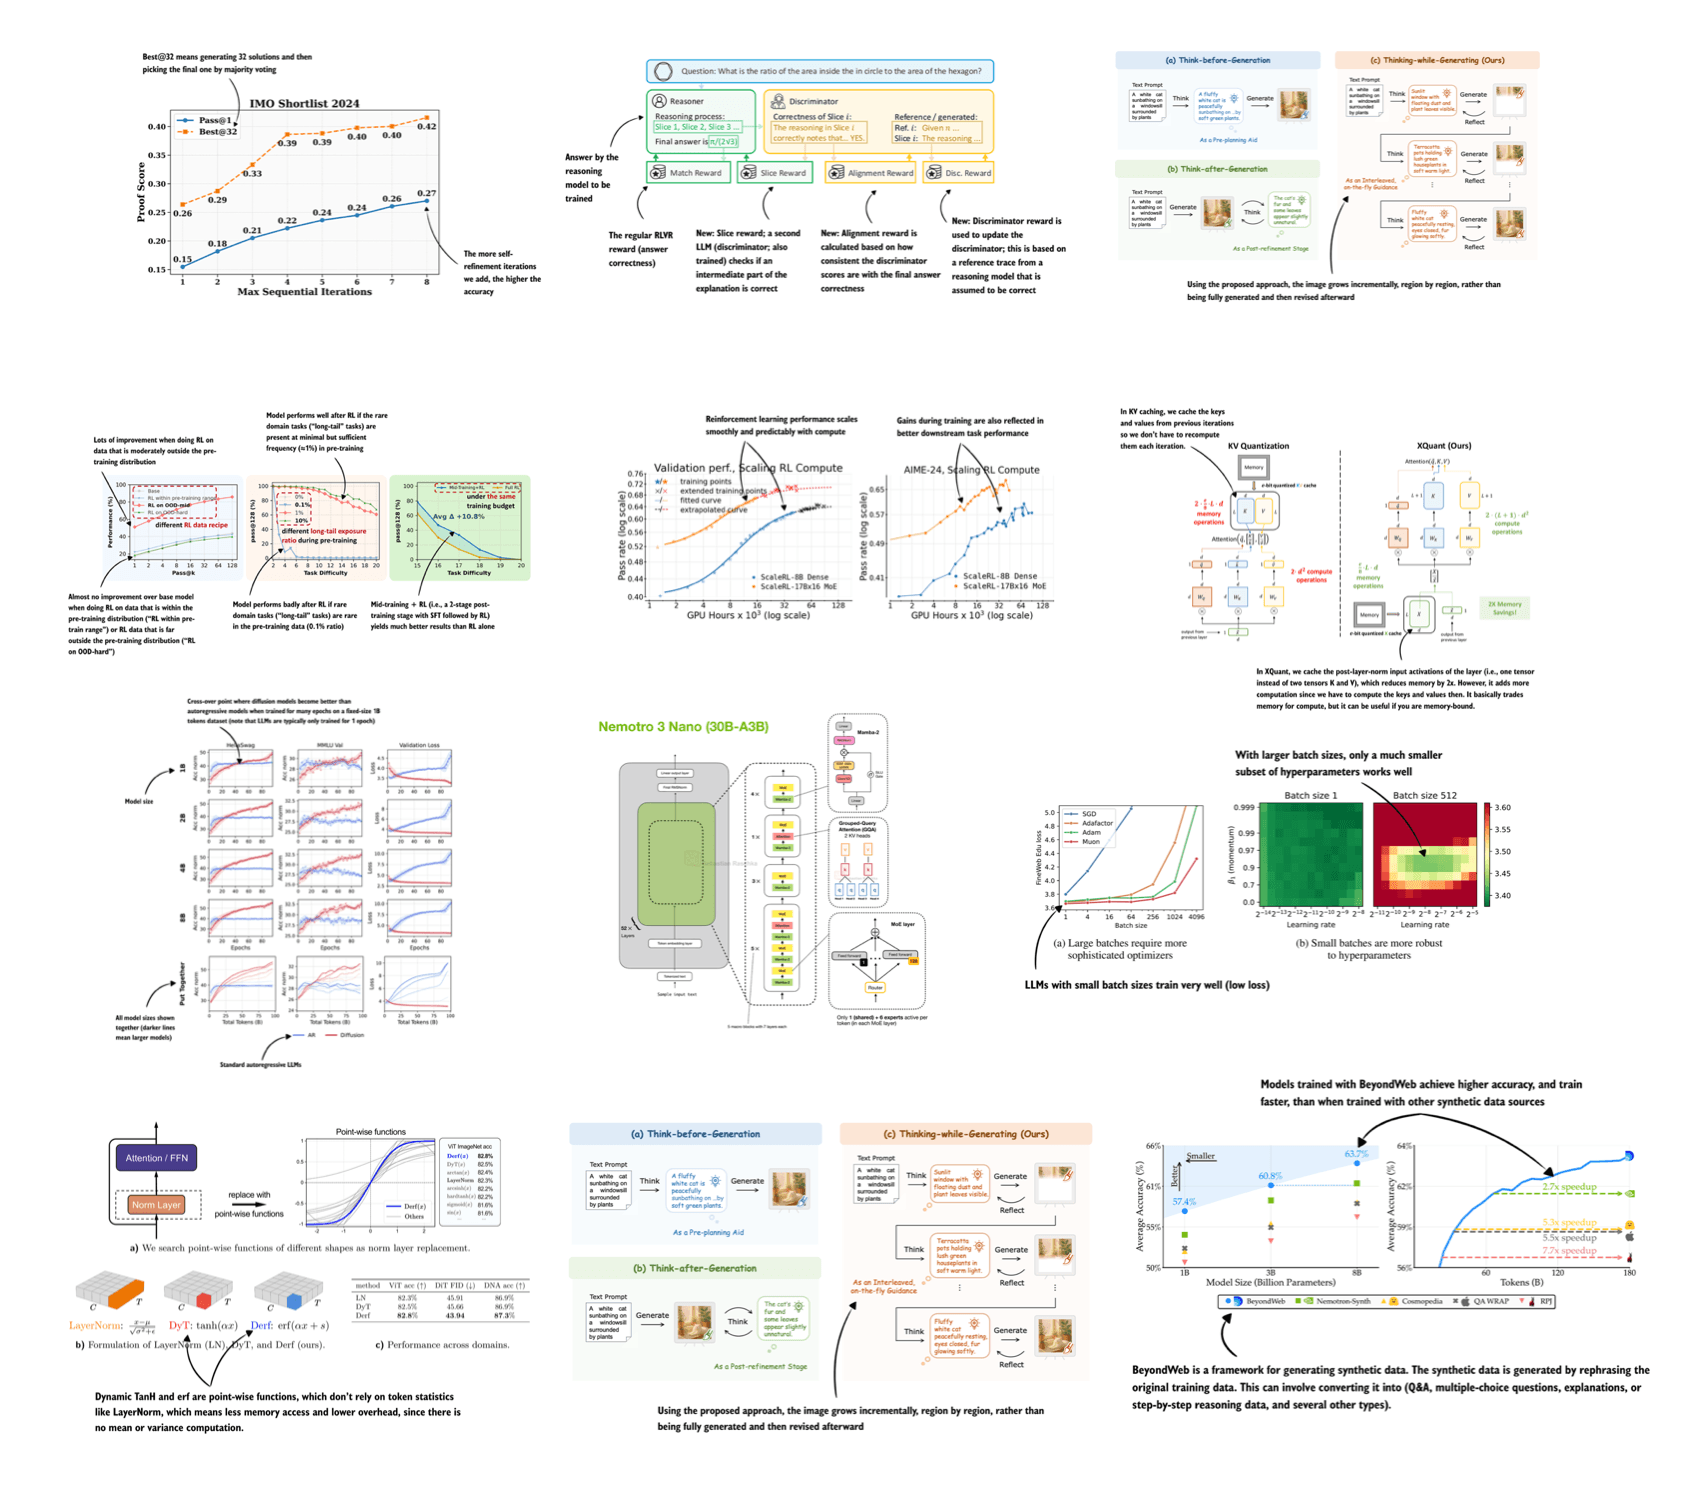
2025下半年LLM论文精选:推理优化与多模态前沿
本文整理了2025年7月至12月期间备受关注的LLM研究论文,涵盖推理模型、强化学习、多模态等关键领域,为开发者和研究者提供高效的技术参考。

DeepSeek V3到V3.2:稀疏注意力与RL架构演进
深度解析DeepSeek从V3到V3.2的架构升级路径,涵盖稀疏注意力机制、推理模型训练流程与开源生态建设,为开发者提供实用参考。
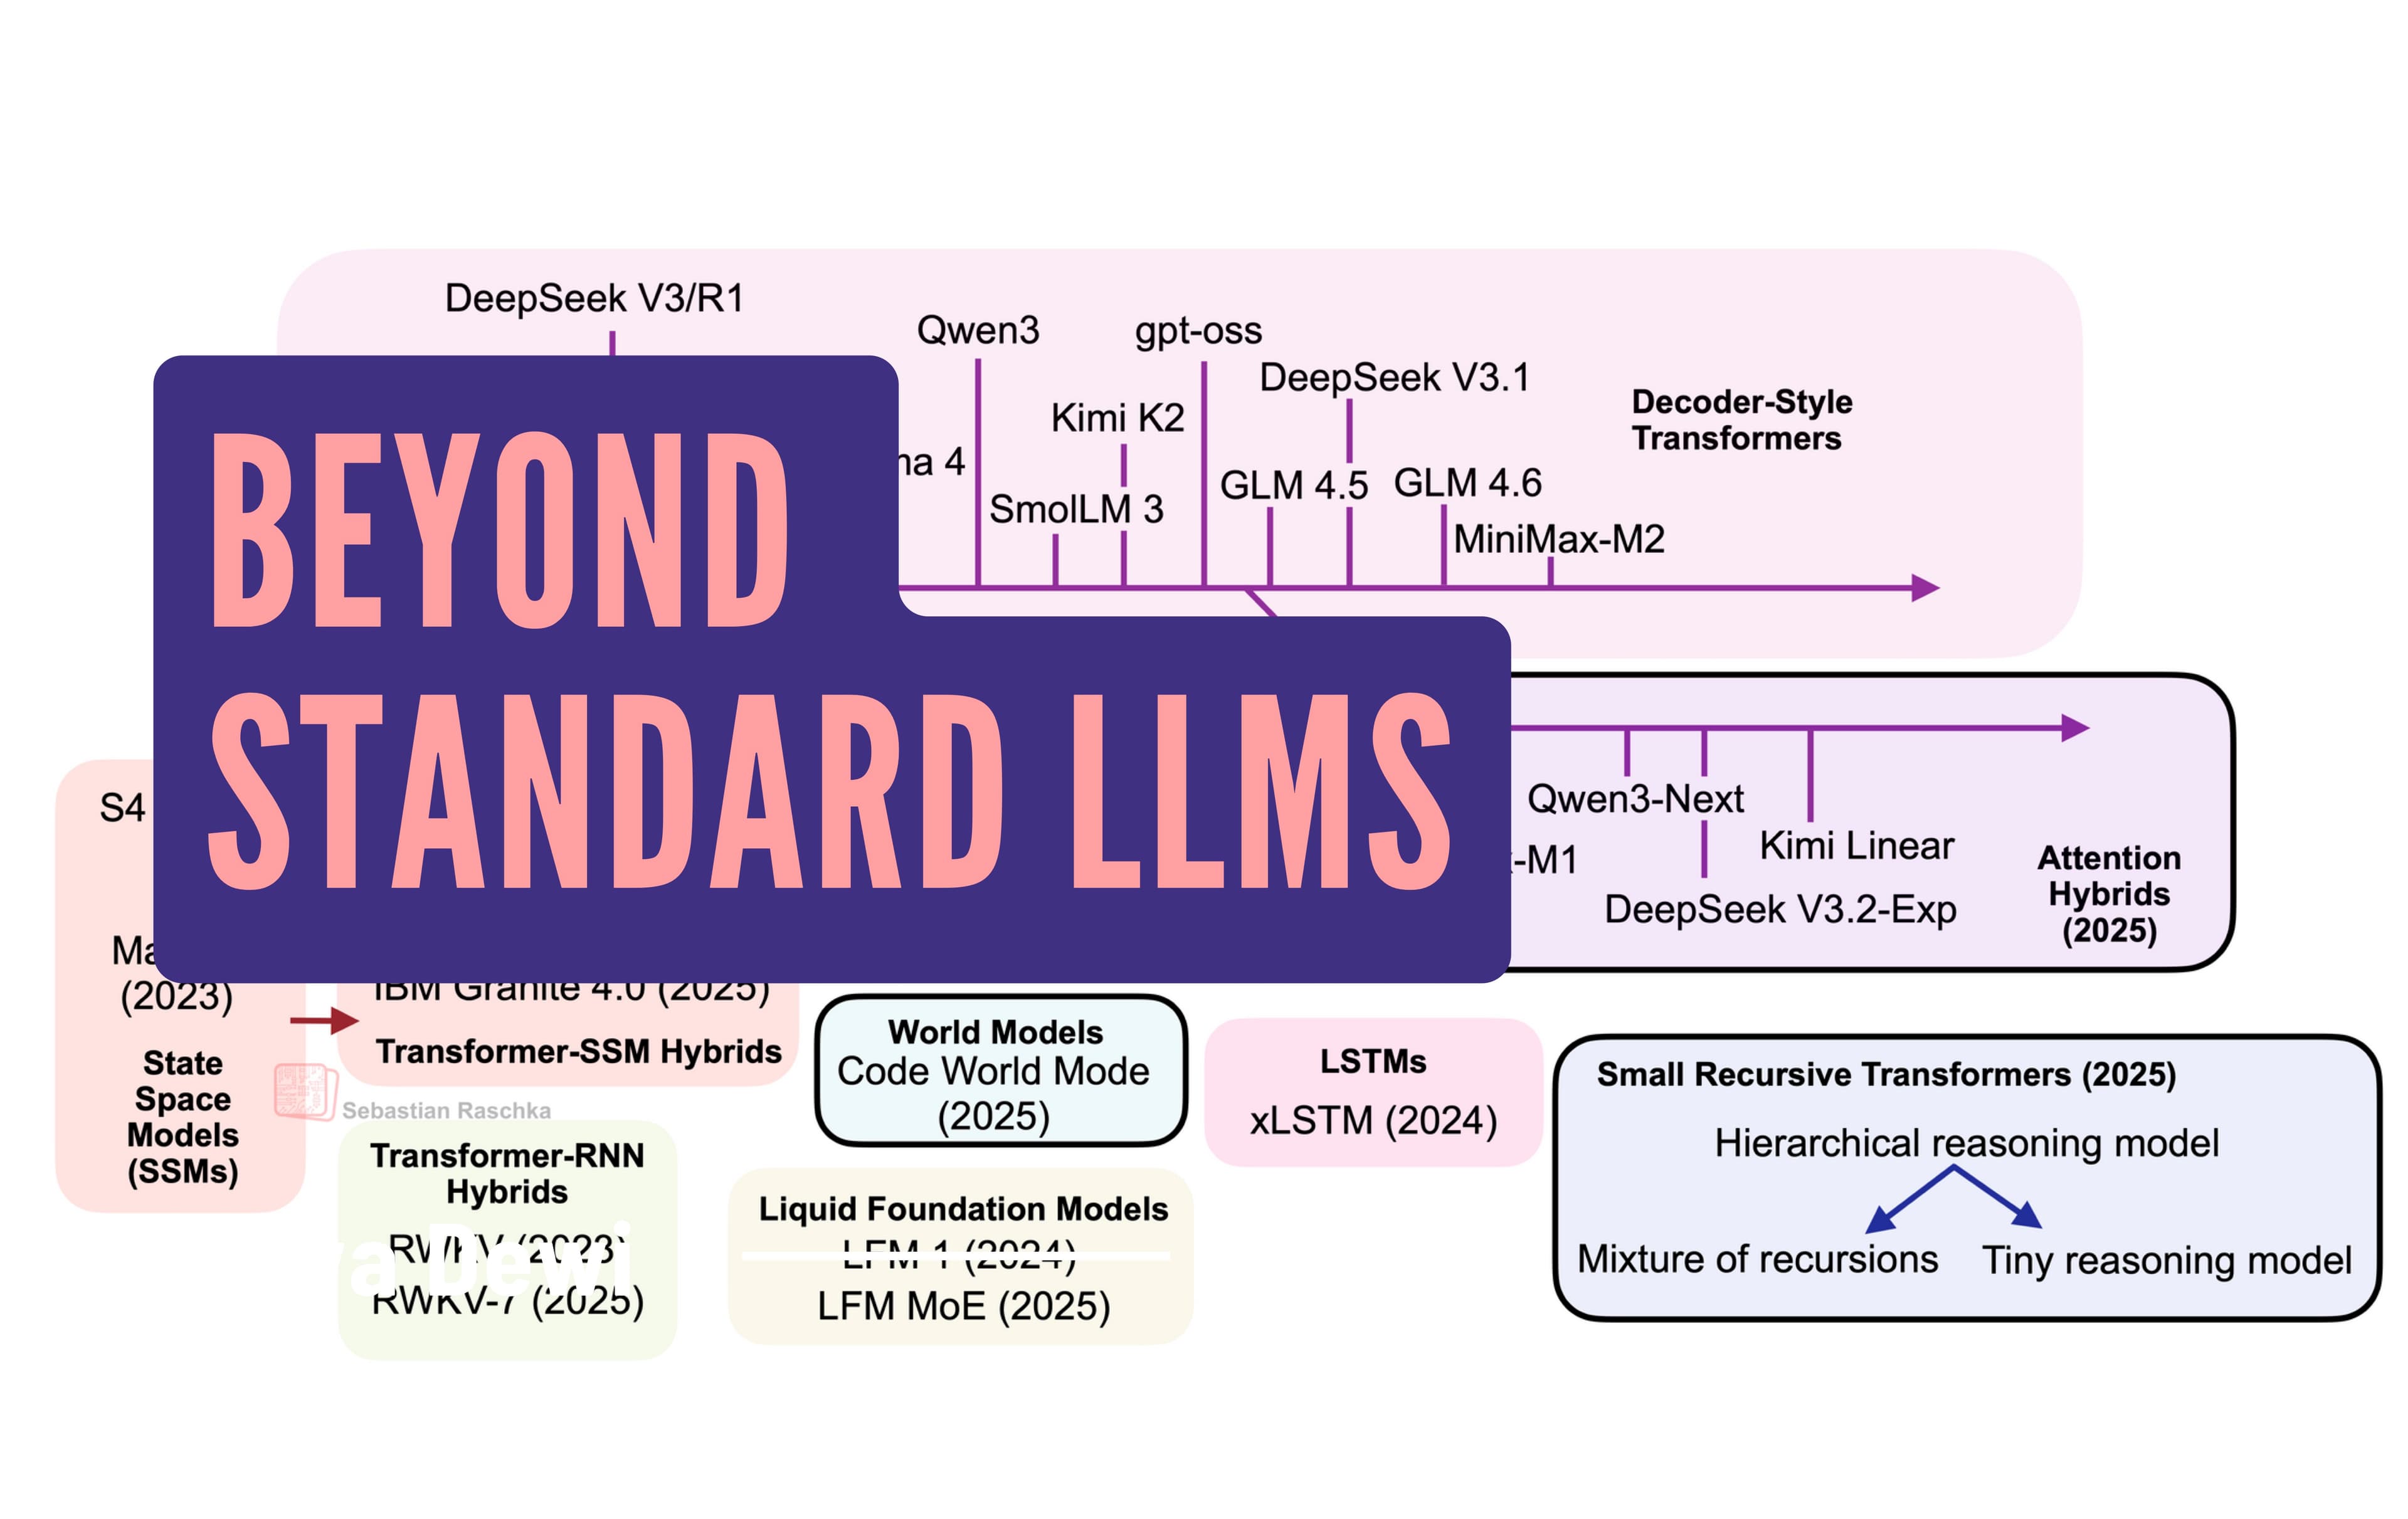
超越标准Transformer的LLM架构探索
当前主流LLM仍基于Transformer,但线性注意力混合、文本扩散、代码世界模型等替代架构正在涌现,本文梳理各方向特点与开发者选型建议。
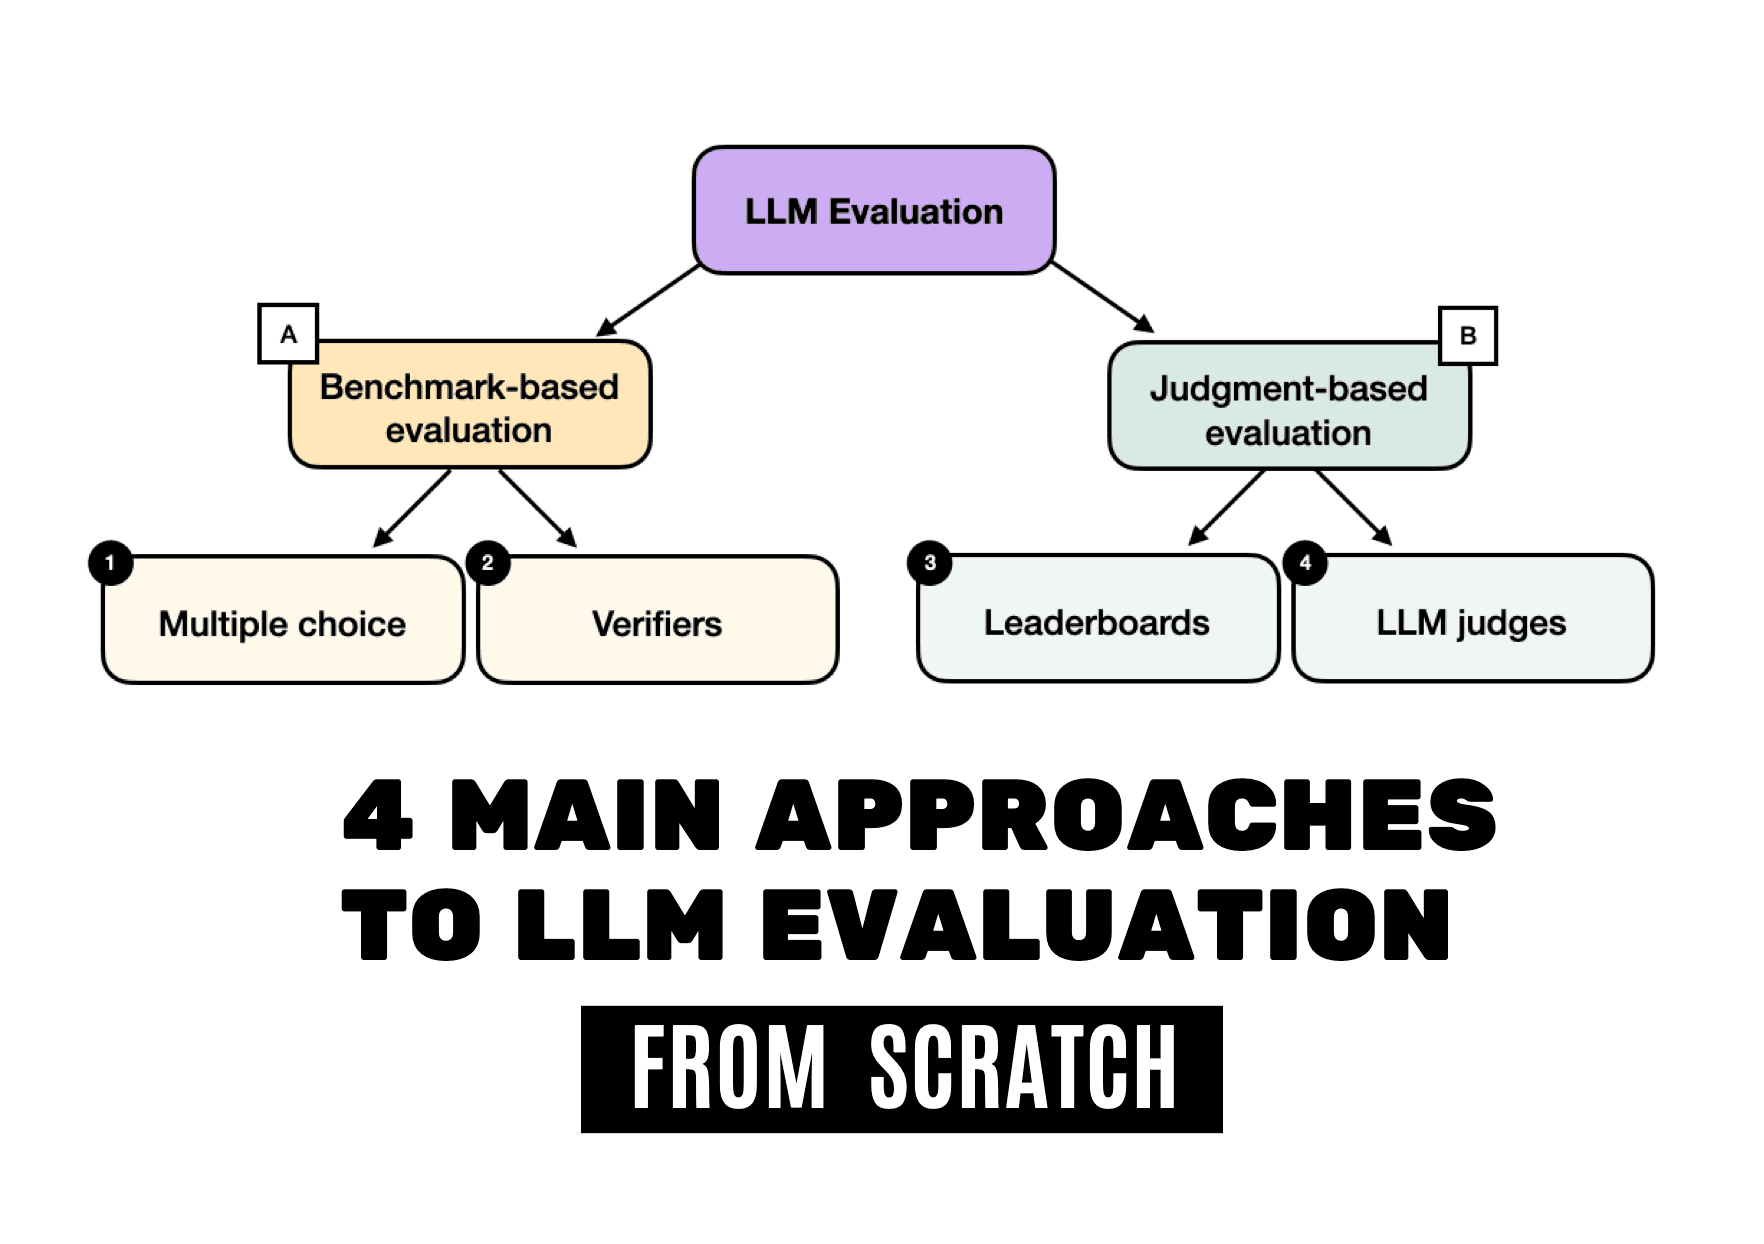
LLM 评估的四大主流方法:从基准到自评
本文解析 Sebastian Raschka 提出的 LLM 评估四大途径,包括多选题、验证器、排行榜和 LLM 评判员,帮助开发者建立评估心智模型。
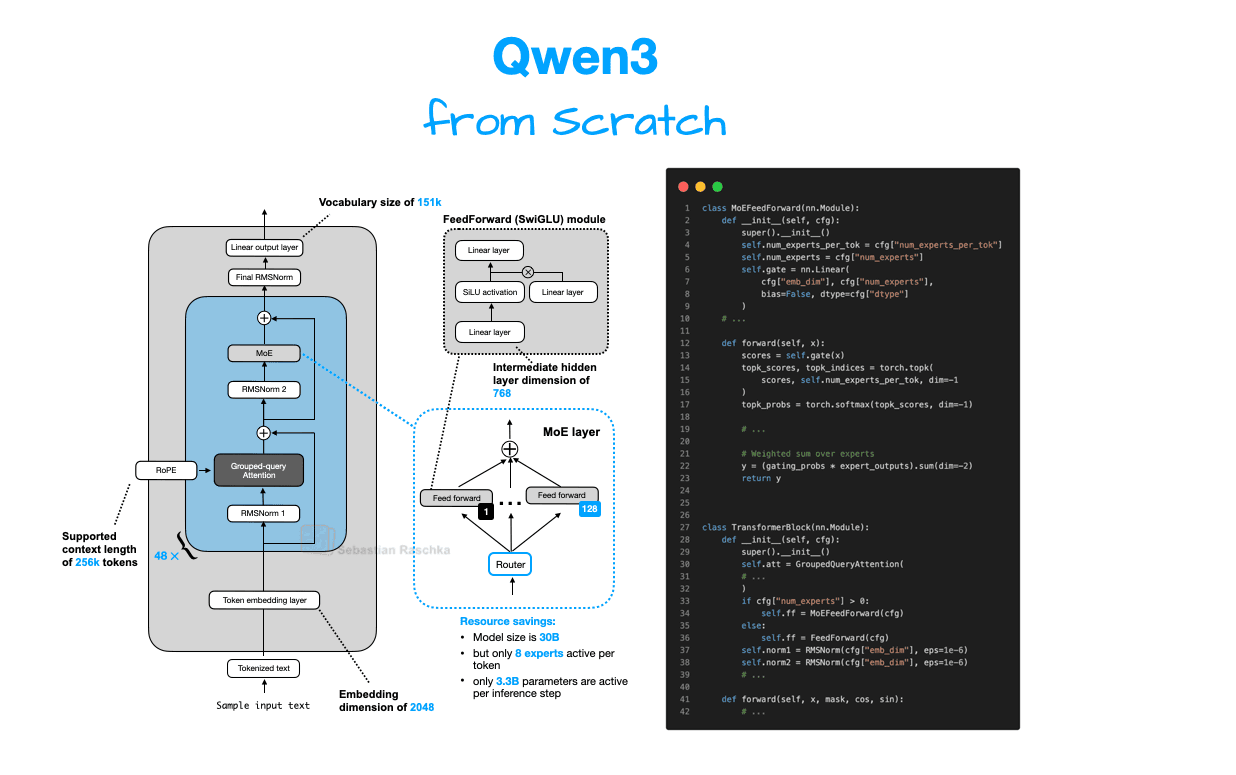
从零实现 Qwen3:深度解析架构与代码
本文深入剖析 Qwen3 架构,通过纯 PyTorch 从零构建模型,解析其开源优势、性能表现及设计细节。