英伟达AI优势已超越GPU
从GPU到系统级优势
过去几年,关于英伟达的主流叙事是:在AI热潮初期,它是先进GPU的唯一来源,随着行业扩张而获利丰厚。但近些年,亚马逊、谷歌等超大规模云厂商开始自研芯片,英伟达不再一家独大,投资者因此担忧其优势的持久性。这一叙事基本属实——2023年初到2025年中,英伟达市值增长10倍,但此后一年股价走势趋于平缓,正是GPU竞争担忧所致。
然而,自周三财报发布后,一种新叙事正在成形:英伟达的优势远不止GPU。随着AI算力迈向吉瓦级规模,编排(orchestration)任务变得愈发复杂。英伟达已构建了处理这一任务所需的大量先进硬件,使其在GPU周边系统上占据巨大优势,即便GPU本身面临更激烈的竞争。
尽管业界常说算力正在商品化,但要高效运营超大规模数据中心依然极其困难——而且随着部署规模更大、速度更快,这一挑战只会加剧。
机架背后的秘密
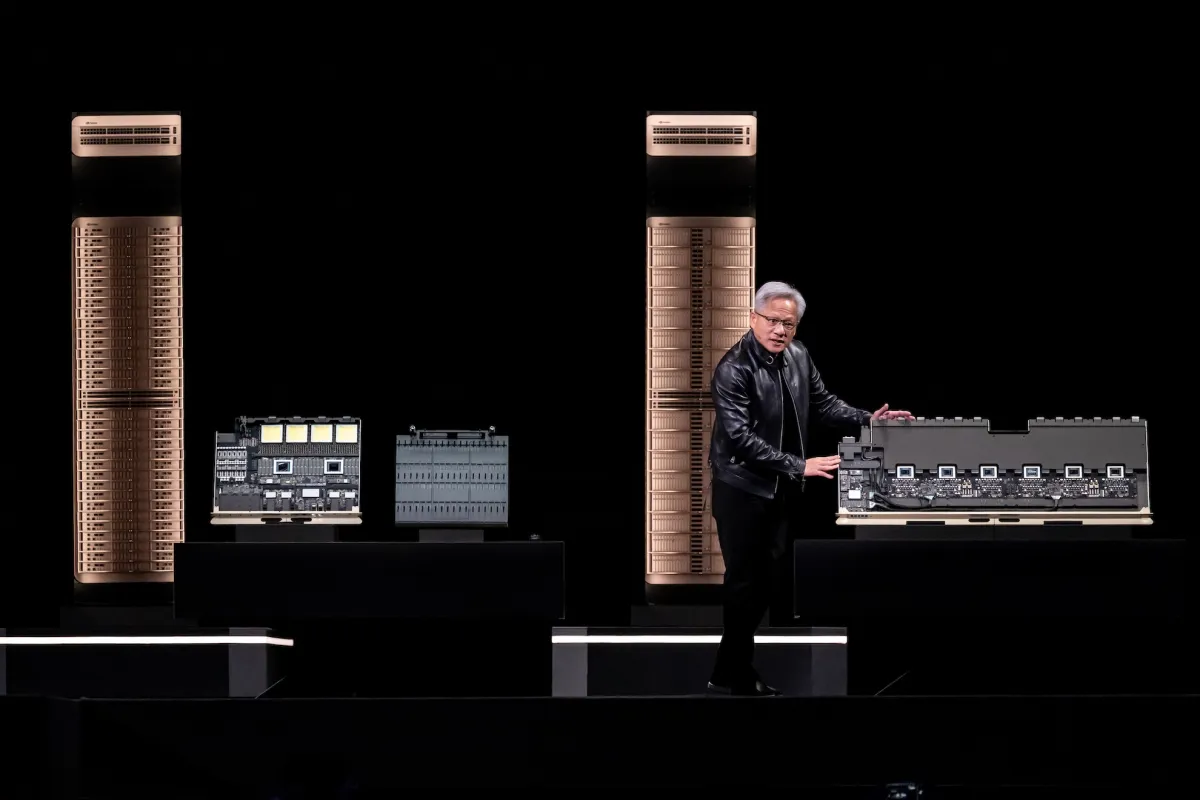
从英伟达实际销售的产品细节中,可以窥见这一趋势。公司目前正在推广其Vera Rubin架构,将Rubin GPU与一系列其他单元搭配,包括Vera CPU、Groq 3 LPX推理加速器,以及用于存储和网络的类似机架。
这些系统与Rubin GPU一样高度专用,但它们并不处理token,而是确保GPU之外的一切尽可能高效运转。如果GPU是引擎,这些就是汽车的其他部分。
Vera CPU尤其专注于数据编排问题。英伟达存储技术副总裁Jason Hardy表示:“Vera很重要,因为单个服务器或任何计算平台能容纳的内存有限。”随着数据中心算力扩展,内存容量也随之增长,这正是美光等公司在基础设施第二波浪潮中获利的原因。但要在正确的时间将数据送达GPU并不简单——随着企业追求更低的每瓦token数,它们正意识到这种流量调度的重要性。
Hardy说:“我们看到这些操作提升了高达3倍,Vera CPU实现了加速。现在我们可以充分发挥闪存的潜力,因为能从中获得全部性能而不产生瓶颈。”
数据移动成为新战场
英伟达之外也能看到类似问题的不同解法。OpenAI开发Jalapeño芯片时,重点是通过最小化需要移动的数据量来完全规避这些挑战。该公司在本月早些时候的博客中表示:“我们设计Jalapeño是为了最小化数据移动和通信延迟。其大域设计允许整个工作负载保留在一个连接系统内,减少数据移动,帮助完整请求从头到尾保持快速高效。”
这是另一种思路:通过在一个集成芯片内完成工作负载来完全避免数据移动。但整体逻辑相同——用更智能的流量控制而非更多处理器周期来提升效率。这反过来为企业开辟了全新的基础设施竞争层面。
优势并非自动延续
对数据编排的新关注并不会自动让英伟达获胜。公司仍需与竞争对手芯片制造商和超大规模云厂商竞争,正如它在GPU领域一样。但至少目前,英伟达在GPU周边系统上的布局,为其在AI基础设施下一阶段提供了新的护城河。