谷歌Genie 4发布:120秒可交互世界
谷歌Genie 4发布:120秒可交互世界
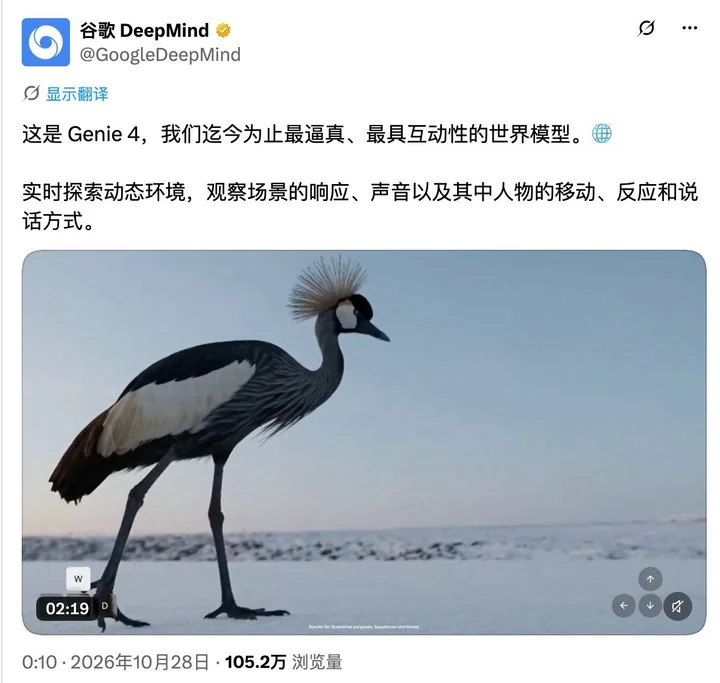
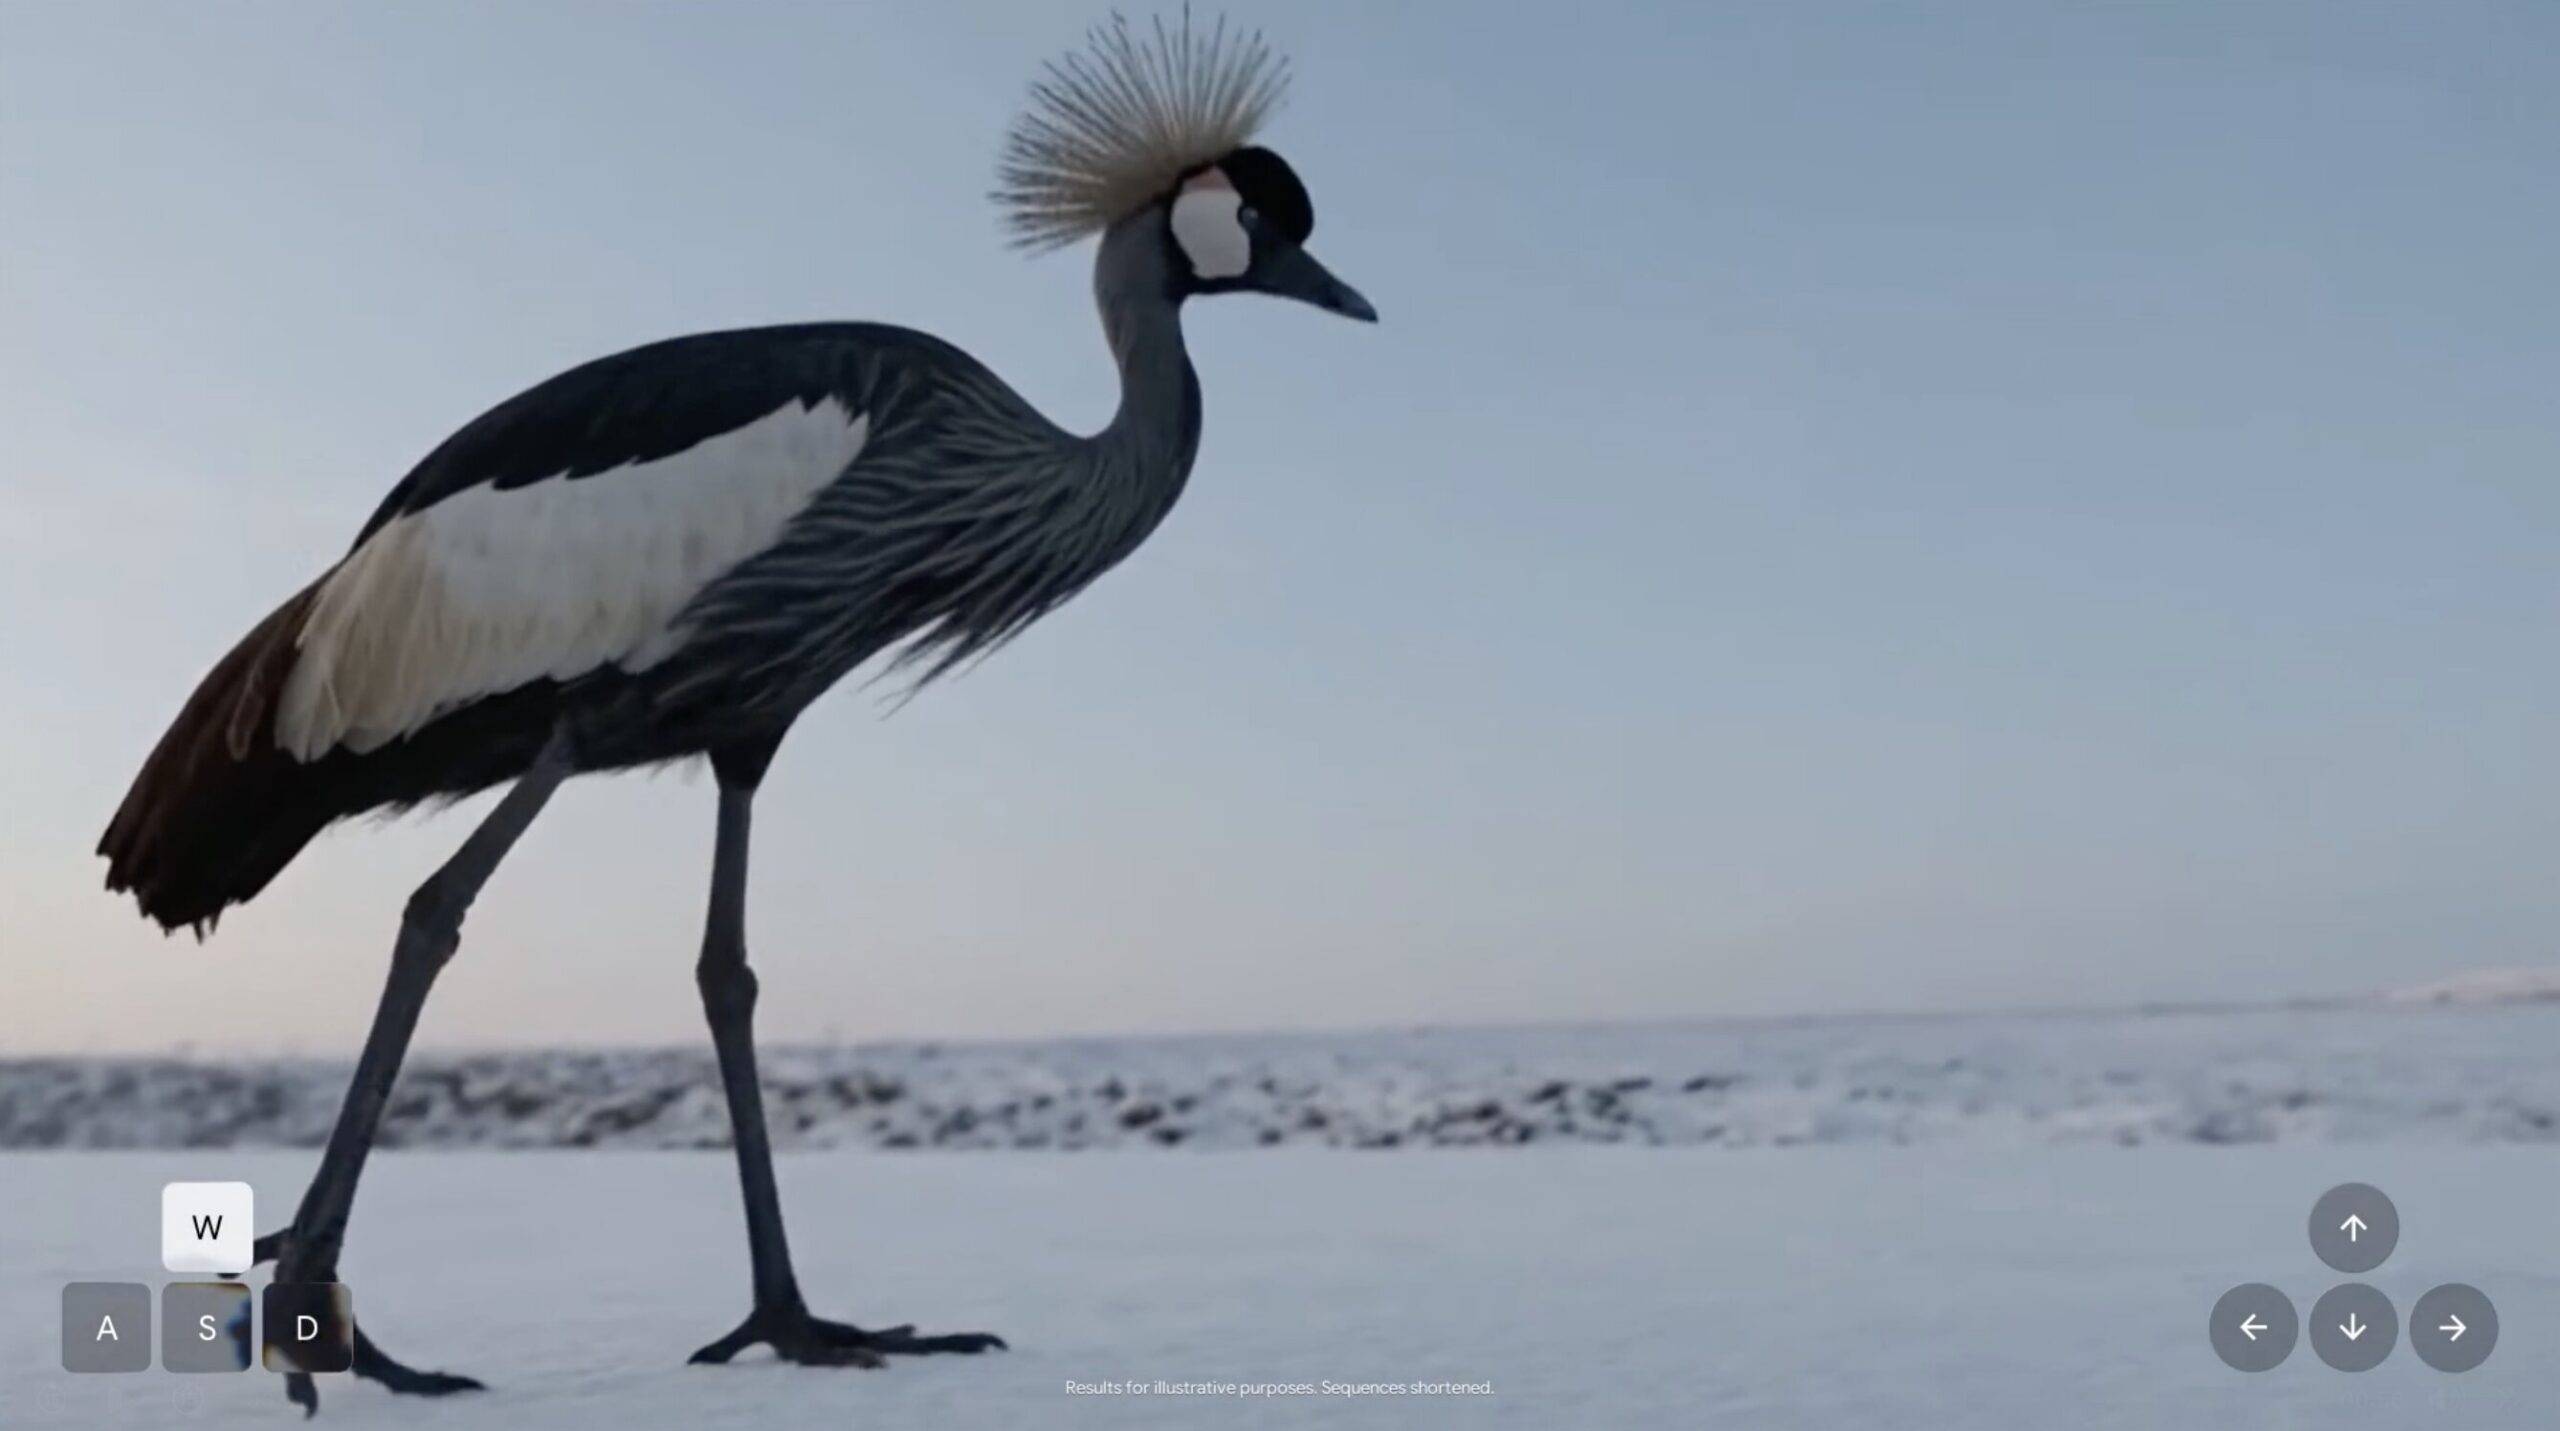
Google DeepMind刚刚正式发布了新一代世界模型 Genie 4,AI生成的虚拟世界又向现实迈进了一大步。相比上一代,Genie 4不仅让画面更加逼真,还能实时生成声音、模拟物理规律,甚至让用户直接走进AI创造的世界,随时改变天气、添加人物,与虚拟角色对话。
更重要的是,谷歌将 Gemini 引入世界模拟,让大语言模型负责规划行动,Genie 4负责实时生成环境。过去只能观看的AI视频,正在变成一个可以自由探索、持续互动的虚拟世界。
从观看走向探索
早在2024年,Google DeepMind就推出了Genie 1,尝试从视频中学习动作与环境变化之间的关系。随后Genie 2将能力扩展到可探索的三维环境,2025年发布的Genie 3则实现了实时生成、实时交互。如今,Genie 4在真实感、物理模拟和交互能力上再次升级,单次模拟时长也从约一分钟延长至两分钟。
根据谷歌公布的演示,用户只需输入一段文字,就能生成可以探索的虚拟世界,通过键盘控制角色移动、调整镜头,甚至在运行过程中继续输入提示词,改变整个场景。例如,在一个漂浮于湖面的小平台上,一名身穿棕色西装的男子正在演奏萨克斯,用户可以自由移动镜头,观察演奏者的动作和湖面变化,甚至临时改变天气、添加人物或物体。Gemini会结合当前环境理解指令,帮助Genie 4维持场景的连贯性。
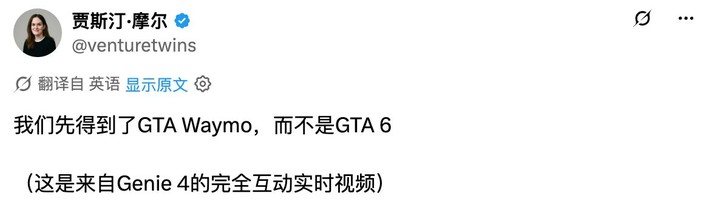
提前体验Genie 4的沃顿商学院教授伊桑·莫利克,只用一句「一座由机器人和马匹居住的新哥特式粗野主义城市」,便在一分钟内生成了一座虚拟城市,随后又实时加入了巨龙和一只友善的水獭NPC。a16z投资人贾斯汀·摩尔也展示了一段被他戏称为「GTA Waymo」的演示,在完全由AI实时生成的城市环境中自由探索,整个过程都可以直接交互。
Genie 4的特别之处在于,整个过程不需要预先制作三维地图,也没有固定的场景演出,AI会根据用户的操作持续生成接下来发生的事情。在物理模拟方面,谷歌还展示了西瓜受到冲击、枫树种子从空中飘落,以及拥挤的乡村火车站等案例,呈现碰撞、空气动力学、重力作用和复杂人群行为。
世界终于有声音了
Genie 4的另一项重要升级,是首次支持原生音频生成。此前Genie系列主要围绕画面和动作交互展开,如今可以在生成世界的同时,实时生成环境声音、音乐和人物对话。海边会有海浪声,树林里会有风声,骑着巨龙穿越山谷时,还能听见翅膀拍打空气、狂风呼啸以及远处的火山活动。
更值得关注的是,Genie 4开始让虚拟人物拥有实时对话能力。传统游戏中的NPC通常依赖预先设计的对白和行为逻辑,而Genie 4可以根据用户输入和场景中发生的事情,动态生成角色的语言与反应。这意味着未来玩家有机会走进一个AI创造的世界,与里面的人物自由交流,甚至通过自己的行动改变故事发展。不过,Genie 4目前仍存在音频准确性和长期一致性方面的问题,距离真正支撑大型开放世界游戏还有不小的技术距离。
Gemini当导演,AI理解世界如何运转
如果说画面和声音让Genie 4更加接近现实,那么Gemini的加入,则让世界模型开始具备复杂的推理和规划能力。根据Google DeepMind的介绍,Genie 4融合了Gemini家族的多项能力:Gemini Omni为模拟提供现实世界的外观与行为基础,而Gemini 3.8 Flash则充当实时引导智能体,持续观察生成画面,将任务分解为多个步骤,并判断每一步是否成功。
Genie 4负责生成虚拟世界,Gemini则负责规划接下来应该发生什么。 例如,用户要求机器人完成一项复杂任务,Gemini可以将任务分解成多个动作,观察机器人在模拟环境中的表现,并根据执行结果调整下一步计划。即使用户临时改变要求,或者周围环境发生变化,Gemini也可以实时修改行动方案。
谷歌还展示了一项结合Gemini 4 Argon与Genie 4的研究实验,将任务分解为连续步骤,实时模拟Apptronik旗下Apollo人形机器人下跳棋的过程。对于机器人训练来说,这项能力很有价值:现实中的机器人训练需要大量设备、场地和实验,一些危险或成本高昂的场景也很难反复测试。如果世界模型能够准确模拟物理环境,机器人就有机会在虚拟世界中提前练习,再将学到的能力迁移到现实。
Google DeepMind研究主管Tejas Kulkarni表示,未来的重要方向是混合世界模型,将语言模型的结构化推理能力与世界模型的感官模拟能力结合起来。Gemini负责规划和组织复杂事件,Genie则将这些规划转化为实时变化的画面、声音和物理环境。AI开始尝试在自己创造的世界中,预测并验证行动可能带来的结果。
世界模型的野心不止于游戏
目前,Google DeepMind已邀请电影、游戏、新闻、教育和工程等行业的测试者,探索Genie 4的实际应用。
- 电影制作:创作者可以通过文字生成可探索的虚拟场景,直接进入其中调整镜头、灯光、人物动作和对白,快速尝试不同的拍摄方案。
- 游戏开发:开发者可以通过提示词创造游戏环境,直接测试美术风格、材质表现和基础互动玩法,再决定是否投入资源正式开发。
- 新闻与教育:一些摄影记者正在尝试将二维历史照片转化为可探索的动态场景,或者通过模拟展示洪水、野火等事件的发展过程。不过,AI根据历史照片推断出的画面,并不能直接视为对历史事实的准确重建。
- 企业端:世界模型也可能用于工业仿真、机器人研发和复杂环境测试,减少部分真实试验所需的时间与成本。
随着应用前景逐渐清晰,世界模型也成为AI巨头争夺的新方向。除了谷歌,Runway已推出支持实时音频和交互的GWM Worlds 2,而李飞飞创立的World Labs则选择了另一条空间智能路线,更强调三维环境的重建、编辑和长期一致性。今年9月,AMD宣布以约82亿美元收购World Labs,也足以说明世界模型的价值已经从内容生成延伸到了机器人和AI算力基础设施。
120秒的世界,通向AI的未来
尽管Genie 4展示了令人印象深刻的能力,但距离真正完整的数字世界仍有很长一段路。目前,模型能够维持的交互模拟时长约为两分钟。随着模拟时间延长,物体细节可能发生变化,场景也可能出现前后不一致的问题。如果用户连续修改提示词,或者在较大环境中不断探索,模型也可能逐渐失去对早期场景信息的准确把握。此外,复杂物理交互、空间准确性、音频生成,以及画面中文字的可读性,都还有待改进。
目前,Genie 4已向部分受邀测试者开放研究预览,未来将通过Project Genie向Google AI Ultra订阅用户开放,并逐步提供给Gemini API和Google AI Studio的早期合作伙伴。
回看过去几年的生成式AI,从文字到图片,从图片到视频,再到如今可以实时探索、拥有声音和人物行为的虚拟环境,AI生成内容的边界正在不断扩大。而Genie 4真正值得关注的地方,是世界模型开始与大语言模型的推理能力深度结合。过去,AI可以告诉你一个人推开门后可能看到什么,也能生成一段推门的视频。未来,它还需要理解门为什么会打开,门后的人会如何反应,以及接下来的一连串行动会产生什么结果。
对于走向现实世界的AI Agent和机器人来说,能够预测行动后果,并在虚拟环境中反复尝试,可能比生成一段漂亮的视频更加重要。当大语言模型正在让AI学会思考,世界模型则试图让AI理解行动的后果。或许,未来AI理解现实世界的重要方式之一,就是先在自己创造的无数个世界中,反复学习现实究竟如何运转。