AI 研究的黄金时代:从算法灵感到系统工程的跨越
AI 研究的黄金时代:从算法灵感到系统工程的跨越
在最近的 MLSys 会议主题演讲中,一位资深专家分享了关于 AI 系统研究的深刻见解。他认为,我们正处于一个系统研究的“黄金时代”。这并非仅仅因为技术进步,更源于AI 研究范式正在发生根本性的转变——从单纯追求算法创新,转向必须解决系统层面的挑战。
从“纸上谈兵”到“硬核现实”
作者回顾了自己的职业生涯轨迹。起初,他在加州大学圣地亚哥分校专注于计算机理论,那时的 AI 虽有趣但并未真正改变世界。然而,当 OpenAI 推出 OpenAI Five 并在 DOTA 2 游戏中击败人类顶尖玩家时,他深受震撼。这让他意识到,要让 AI 在实际场景中取得卓越表现,必须深入理解底层系统。
为了追求更好的计算性能,他加入了 Graphcore 并接触了 IPU(智能处理单元)。这种编译器优先的架构要求开发者思考如何调度计算图,而非直接编写内核。这让他深刻体会到,想要在 AI 领域取得突破,光有算法灵感和理论是不够的,必须自动化系统。
PyTorch 的崛起与“易用性陷阱”
在 AI 研究领域,框架的选择至关重要。为什么 PyTorch 最终战胜了其他框架?作者认为核心原因在于其Eager Execution(即时执行)模式。
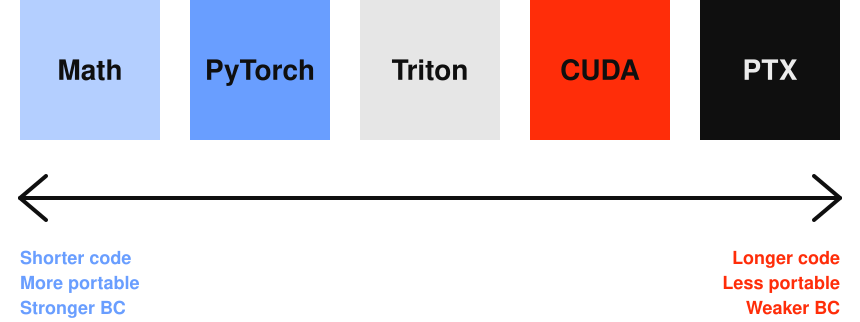
PyTorch 的前端设计深受 NumPy 的影响,它定义了数百个高层算子,支持如 torch.mm 和 torch.tanh 这样的线性代数操作。更重要的是,它允许开发者像编写普通 Python 代码一样逐行执行代码,并直接使用 print() 语句调试。
对于研究人员来说,这种直观的调试体验至关重要。他们可以在 GPU 内存分配后立即打印张量,观察数据流,而无需等待整个计算图运行完毕。这种开发体验极大地降低了入门门槛,使得 PyTorch 迅速占领了 AI 研究市场。
算法自由与硬件效率的博弈
然而,这种对“易用性”的追求给系统工程师带来了巨大的挑战。
在系统工程师的理想模型中,AI 架构应该像是一个简单的矩阵乘法循环,结构规整,便于在 GPU 上进行大规模并行计算。相比之下,AI 研究人员则提出了截然不同的需求:他们渴望不规则形状、自回归解码、动态控制流,以及大量的小型内核启动。
这导致了著名的“性能悖论”:研究人员希望代码写得随意、灵活(甚至通过猴子补丁动态修改模型),但系统工程师则希望架构高度固定、高效。在很长一段时间里,研究人员的意见主导了框架的设计,而系统层面的优化则被忽视。
物理定律倒逼系统优化
幸运的是,情况正在发生变化。随着 AI 模型的规模越来越大,单纯靠改进算法已经难以突破性能瓶颈。作者指出,物理定律正在迫使研究人员产生同理心。
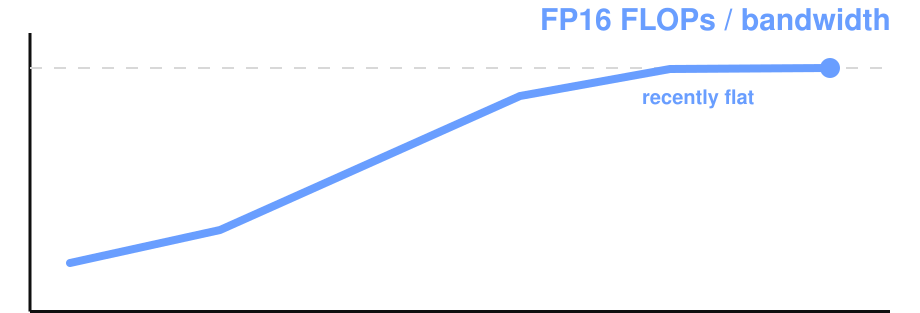
虽然内存带宽和计算能力在提升,但提升速度远跟不上模型增长的步伐。当算法创新遇到墙角,研究人员不得不开始关注那些曾经被他们忽略的系统问题——例如如何减少内存访问开销、如何优化调度策略。
对开发者的启示
这一趋势对开发者意味着什么?
- 关注硬件特性:未来的 AI 开发将越来越依赖对硬件特性的理解。不同的加速器(如 GPU、TPU、IPU)有不同的优势,选择合适的硬件和框架组合至关重要。
- 系统思维:开发者不能只关注模型层的 Loss 下降,还需要关注底层执行效率。理解代码在硬件上的执行路径,是写出高性能 AI 系统的关键。
- 工具链的重要性:像 PyTorch 这样的工具,通过平衡易用性和性能,极大地加速了研究进程。未来,能够自动将研究代码优化为高效系统代码的工具将是行业刚需。
随着物理限制的逼近,AI 系统工程不再是辅助角色,而是决定 AI 能走多远的核心引擎。