中美开源模型力量对比:中国已实现反超

近期,Nathan Lambert 在为美国国会准备的一份简报中,详细阐述了中美在开放模型领域的力量对比。作为资深科技编辑,我们有必要梳理这一趋势,因为这直接关系到全球开发者如何选择技术栈和部署方案。
什么是“开放”与“封闭”?
在深入竞争格局前,我们需要先厘清模型开放程度的定义。这并非非黑即白,而是处于一个连续的光谱上。
- Open-weight models(开放权重模型): 这是最常见的形式,指模型的权重参数公开发布,允许开发者进行二次使用或本地部署。例如 Meta 的 Llama、阿里巴巴的 Qwen、Google 的 Gemma 以及 DeepSeek 的模型。这类模型通常受特定许可证约束。
- Open-source models(开源模型): 这是最严格的定义。除了权重和推理代码外,还必须包含完整的训练代码和训练数据。目前美国在该领域仍处于领先地位,代表项目包括 Allen Institute for AI 的 Olmo、OpenAthena 的 Marin 以及 EleutherAI 的 Pythia。
- Closed models(封闭模型): 仅通过 API 或产品界面(如 ChatGPT、Claude)提供服务,开发者无法获取底层权重。
此外,Nvidia 的 Nemotron 模型提供了一个有趣的中间地带:它在数据公开程度上远超普通 open-weight 模型,但并非完全开源。
中美竞争格局的逆转
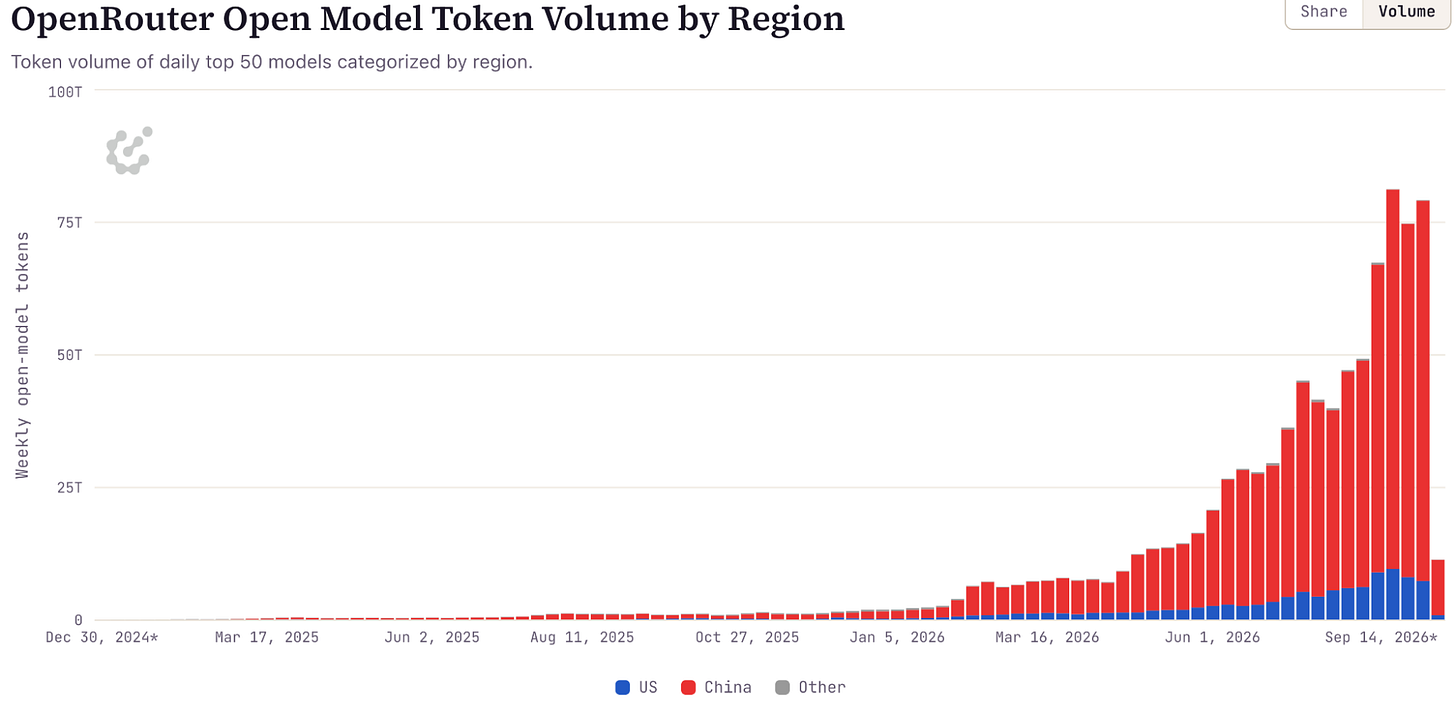
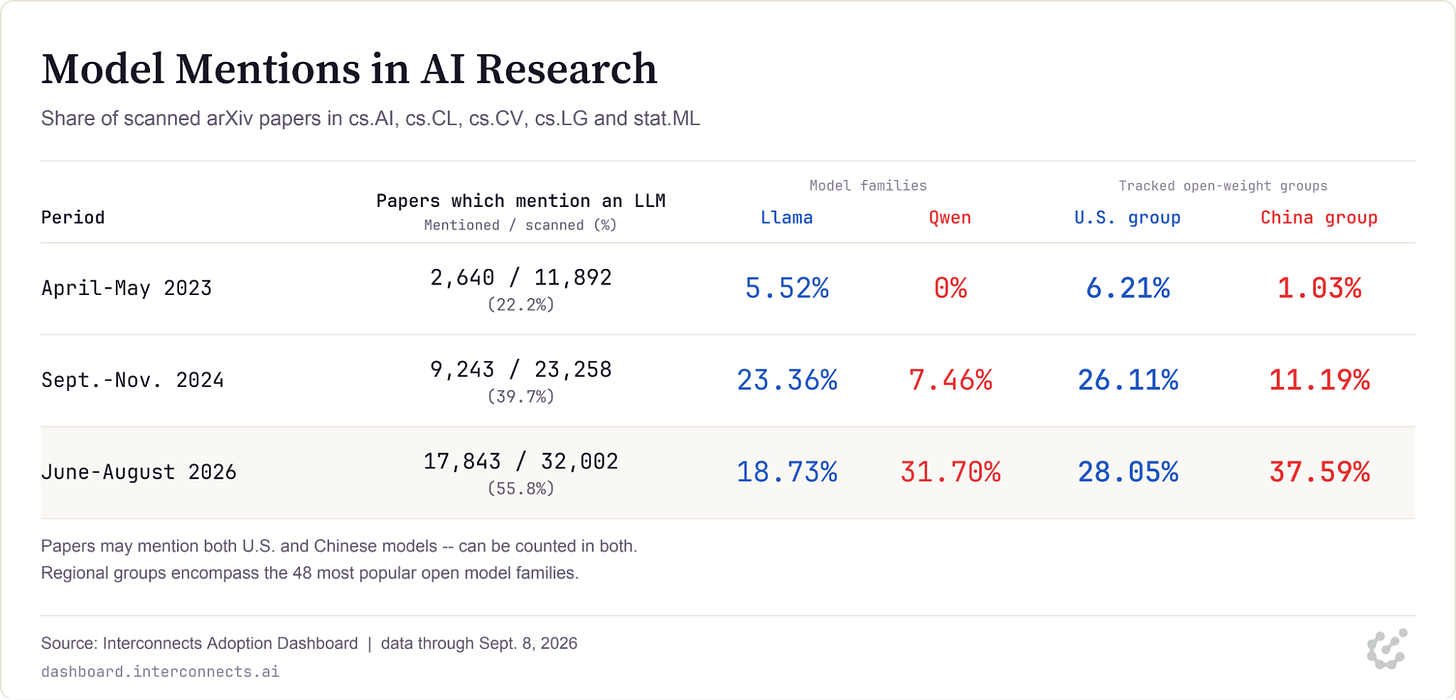
美国曾凭借 Meta 的 Llama 系列在开放模型领域占据早期主导地位。然而,竞争态势在约 18 个月前发生了根本性逆转。
1. 下载量的绝对优势
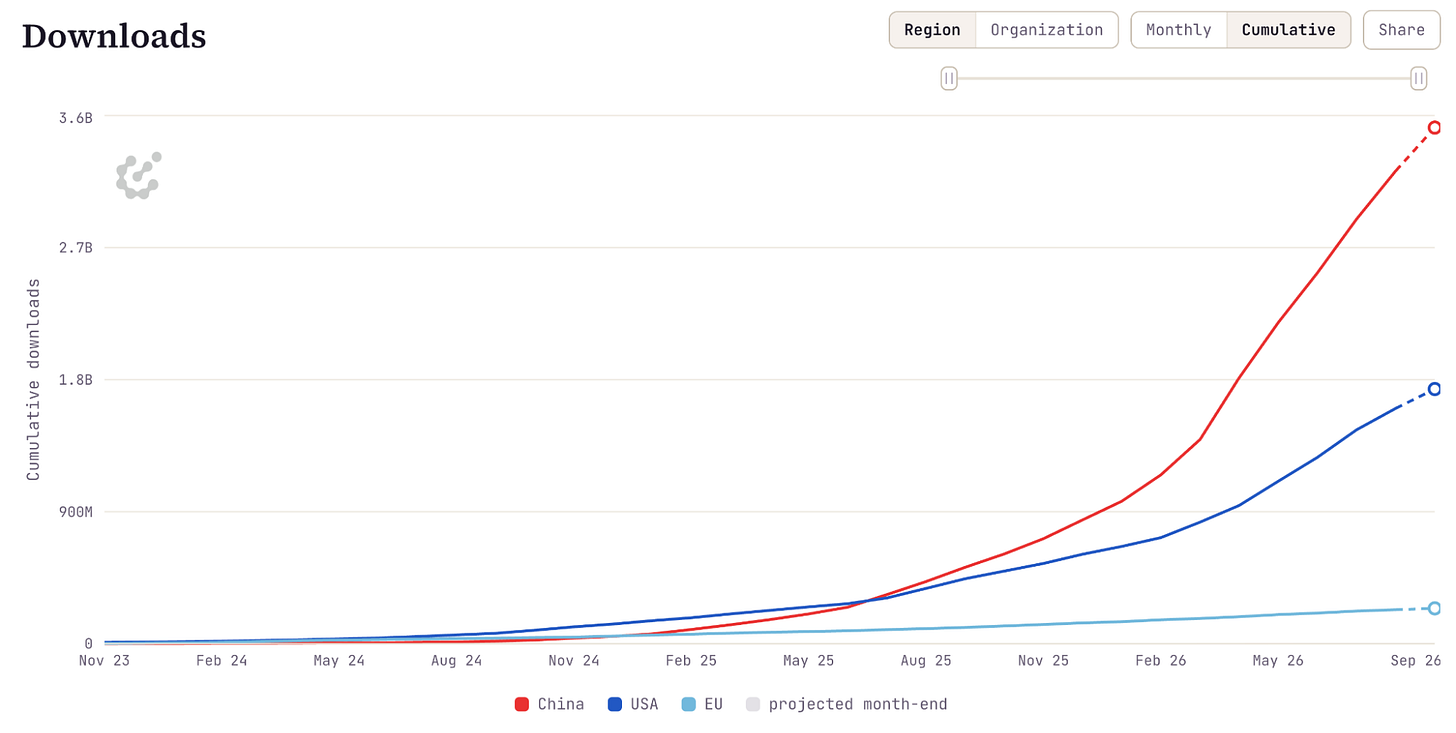
根据 Hugging Face 的统计数据,中国在 open-weight 模型的下载量上已遥遥领先。数据显示,中国相关模型的下载量已达到 32 亿,而美国仅为 16 亿。Nathan Lambert 个人维护的追踪工具(ATOM 项目)也证实了这一趋势,中国对美国的下载量领先优势已扩大至约 1.6 亿。
2. 技术与商业能力的突破
最新的中国模型,如 Z.ai 的 GLM-5.2 和 Moonshot AI 的 Kimi K3,在商业可行性和代理能力上取得了“质变”,跨越了类似 Anthropic Claude Code 在 2025 年 12 月达到的技术门槛。
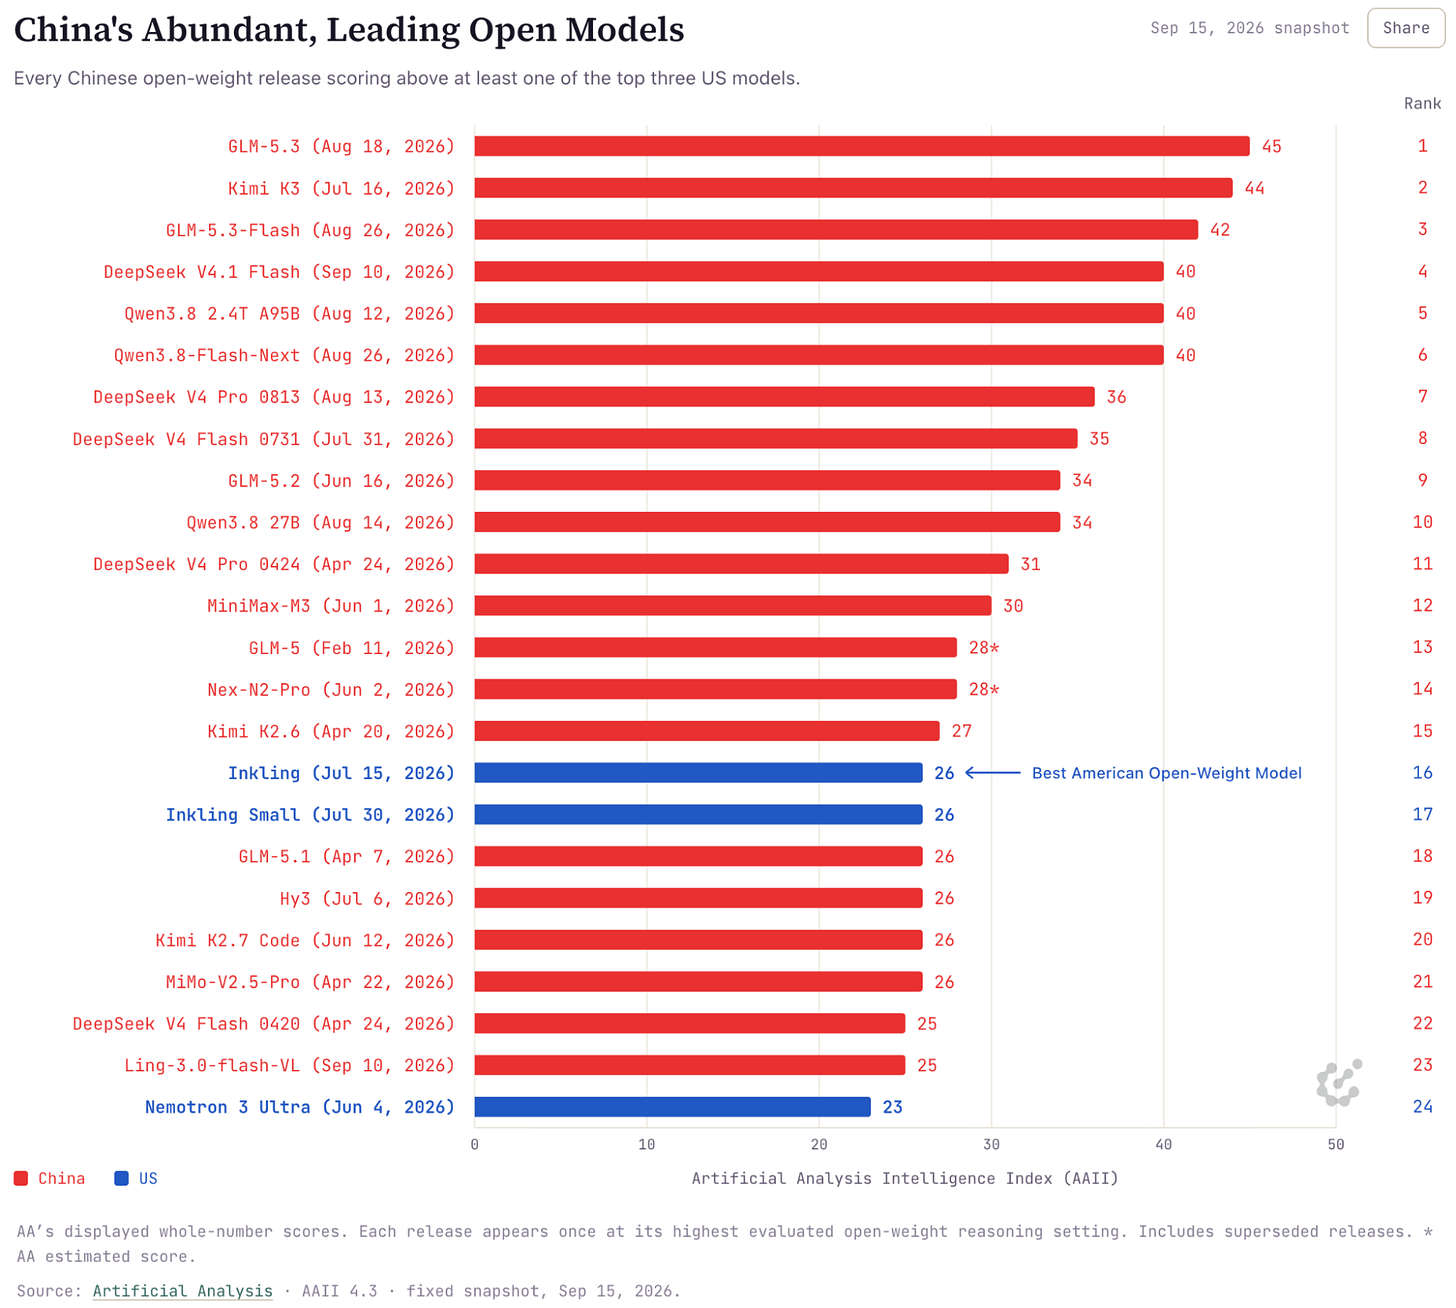
在行业公认的基准测试(如 Artificial Analysis Intelligence Index, AAII)中,中国的前三大模型——GLM-5.3、GLM-5.3-Flash 和 Kimi K3——均表现优异,在各项指标上对美国的同行构成了明显压力。
给开发者的实用建议
对于开发者和 AI 使用者而言,这一数据意味着什么?
- 关注国产开源模型: 在选择模型时,除了传统的 Llama 系列外,应将 GLM 系列和 Kimi K3 等中国开源模型纳入考量。它们在性能和可用性上已具备极强的竞争力。
- 利用 Open-weight 生态: 利用 Transformers、VLLM 或 SGLANG 等推理库,开发者可以基于这些开源权重在本地或私有云环境中构建应用,这比单纯依赖 API 具有更高的数据安全性和可控性。
- 理解光谱选择: 根据需求选择。如果需要完全透明的训练流程,关注 Open-source 项目;如果只需快速部署和微调,Open-weight 模型是更务实的选择。
总而言之,开源模型领域的“单极世界”正在向中美双强格局转变,中国正凭借庞大的应用落地和模型迭代速度,确立其在新一轮技术竞赛中的主导地位。