智谱GLM-5.3发布:小参数量如何吊打GPT-5.6?
智谱GLM-5.3发布:小参数量如何吊打GPT-5.6?
就在2026年8月14日,智谱AI(Zhipu AI)宣布了备受瞩目的GLM-5.3模型。对于开发者和大模型爱好者来说,这不仅仅是一个新模型,更是一个打破参数规模迷信的案例。
性能炸裂:参数少一半,实力却更强
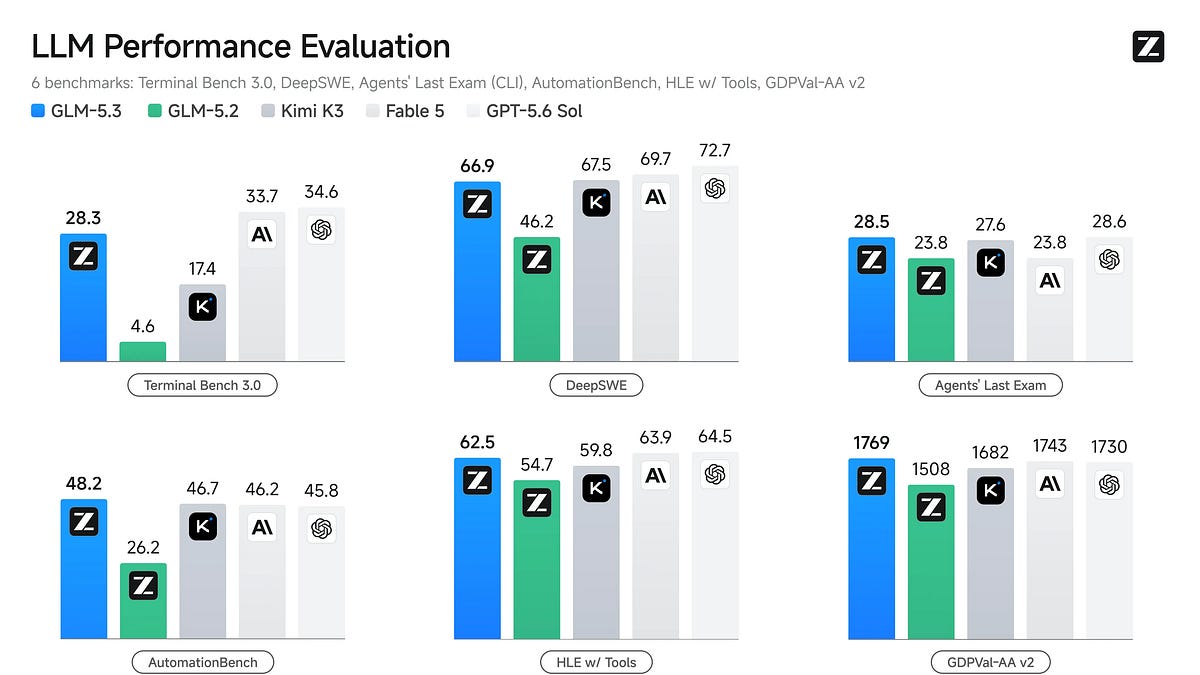
GLM-5.3目前的参数量约为750B,仅是Moonshot AI的Kimi K3的三分之一,但其在多项基准测试中的表现却令人咋舌:
- 超越竞品:在许多评测中,GLM-5.3不仅超越了Moonshot AI的Kimi K3,甚至在某些指标上超越了Claude Fable 5和GPT-5.6-Sol。
- 前沿定位:该模型目前处于智能体编码(Agentic Coding)基准测试的最前沿水平。
- 开源计划:模型目前仅在智谱的coding计划中提供,预计两周后将开源权重至Hugging Face,开发者可以期待第一时间获取并本地部署。
核心解析:成功的秘诀并非“蒸馏”
面对如此高的性能表现,业界普遍存在疑问:中国实验室是如何在资源有限的情况下保持如此竞争力的?最主流的猜测是蒸馏,但智谱AI的官方博客给出了截然不同的答案。
智谱AI在博客中直言不讳:“Scaling post-training is all we did for GLM-5.3。”(GLM-5.3仅进行了扩展的后训练)。
这意味着,GLM-5.3并非全新的基础模型,而是基于GLM-5.2进行大幅度的后训练迭代。文章指出,与Kimi更侧重于预训练不同,智谱AI在后训练领域有着深厚的积累。
为什么不是蒸馏?
知名科技编辑Nathan Lambert分析认为,蒸馏并不是主要原因。
虽然近期有论文展示了从前沿模型中提取推理轨迹(Reasoning Traces)的简单方法,但这更多是针对推理过程的微调,而非对整个训练生态的复制。要实现智谱AI描述的“更多环境、更多样化的任务和更多算力投入”,这涉及到复杂的强化学习(RL)基础设施和算法混合,这些是难以通过简单的蒸馏手段复制的。
历史积淀:长期主义的胜利
GLM-5.3的爆发并非偶然,而是智谱AI长期技术路线的必然结果。从2019年成立至今,智谱AI在大模型领域的布局从未中断:
- 2019年:智谱AI成立。
- 2021-2022年:发布GLM-130B,奠定技术基础。
- 2023年:推出ChatGLM系列,推动中文对话模型普及。
- 2024年:GLM-4发布,标志着通用大模型的成熟。
- 2026年2月:GLM-5发布,随后在6月发布的GLM-5.2便因其速度和稳定性获得了研究社区的广泛好评。
GLM-5.2在发布后甚至被许多AI研究者用于内部集群部署,以获得比公共API更快的推理速度和更稳定的系统表现。
给开发者的实用建议
GLM-5.3的发布为我们提供了重要的技术启示:
- 关注后训练:单纯扩大参数规模并非唯一出路。数据质量、任务多样性以及强化学习环境的构建,同样是提升模型性能的关键杠杆。
- 重视开源生态:像GLM-5.3这样即将开源的模型,为本地部署、私有化微调以及研究提供了宝贵的资源。开发者应密切关注Hugging Face上的更新。
- 打破规模迷信:高性能并不总是需要万亿级参数。通过精细化的后训练,小参数模型也能达到前沿水平,这对算力受限的开发者而言是个好消息。
GLM-5.3的横空出世,证明了在激烈的大模型竞争中,持续的技术积累和精细化的训练策略同样能够产生惊人的效果。
本文目录(5 节)
本文基于 Interconnects 的公开内容,由 AI 辅助整理改写后发布。
原标题:GLM-5.3: How Chinese labs keep stride with the frontier
阅读原文