实体解析实战:确定性清洗如何比模糊匹配更高效
实体解析实战:确定性清洗如何比模糊匹配更高效
在处理企业级业务数据时,实体解析 是一个棘手但至关重要的环节。它指的是识别不同数据源中描述的是同一个实体(例如同一个供应商或同一个人)的过程。本文将以一家通过 API 同步外部市场数据的代理机构为例,展示如何利用确定性清洗阶段解决 76% 的重复记录问题。
引言:一个花钱的“不体面”问题
对于许多公司来说,维护一个包含 10,000 多家供应商的列表是家常便饭。然而,当这个列表混乱不堪时,成本会直线上升。拼写错误、子域名差异、大小写不一致以及追踪参数(如 ?utm_source=...)会导致同一家供应商出现多个记录。这不仅是技术问题,更是金钱问题:重复付款、价格历史记录断裂,以及难以追踪已协商的费率。
数据合成:复现真实的混乱
为了验证解决方案,我们构建了一个模拟环境。我们生成了 7,000 个虚构的出版商品牌,并通过人为方式注入了常见的“数据病态”:
- 表面变体:约 2,429 个变体,包括
http://、www.前缀、随机大小写、路径和追踪参数。 - 子域名:888 个子域名记录(如
blog.、m.)。 - 国家域名:529 个不同国家后缀的变体(如
brand.de)。 - 拼写错误:505 个单键位输入错误。
- 陷阱数据:故意插入 180 个邻近域名,以测试系统的鲁棒性。
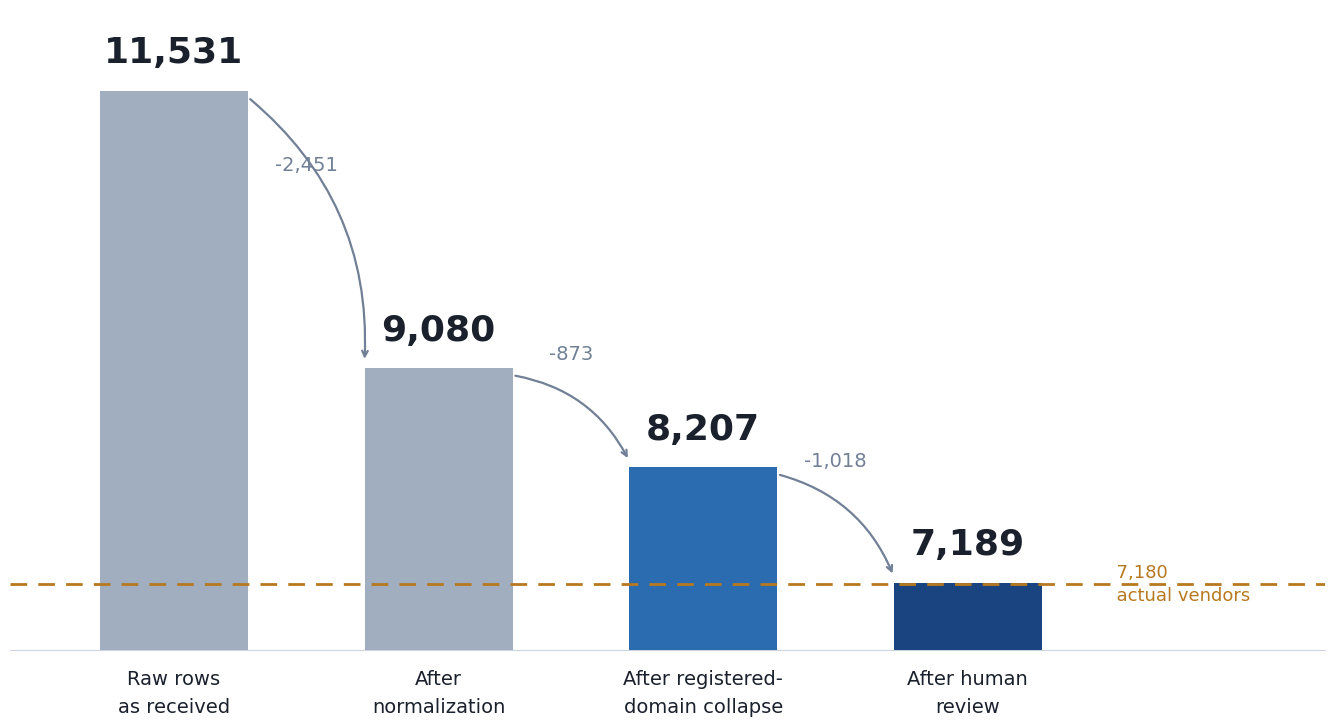
最终得到 11,531 行数据,实际覆盖 7,180 个供应商。所有测试在 Python 3.12 环境下,使用 RapidFuzz 和 tldextract 库完成,单核 CPU 即可运行。
第一阶段:低成本的“傻瓜式”清洗
在处理实体解析时,最有效的第一步往往是最简单的。规范化 是消除表面差异的关键。
我们编写了一个简单的 Python 函数,执行以下操作:
- 统一大小写:将所有字符串转为小写。
- 移除协议:去除
http://或https://前缀。 - 剥离路径和参数:只保留域名部分,忽略
/path或?query。 - 移除
www.:统一处理标准前缀。 - 去尾点:去除域名末尾的点。
结果:仅用 0.03 秒,我们就将列表从 11,531 行压缩到了 9,080 个唯一主机,直接移除了 2,451 个重复项。这个过程不需要模型,不需要评分,成本几乎为零。
import re

def norm_host(raw: str) -> str:
    s = raw.strip().lower()
    # 移除协议
    s = re.sub(r"^[a-z]+://", "", s)
    # 只保留域名部分(拆分路径和查询字符串)
    s = s.split("/")[0].split("?")[0]
    # 移除 www. 前缀
    if s.startswith("www."):
        s = s[4:]
    return s.rstrip(".")
第二阶段:子域名折叠的威力
规范化虽然有效,但无法处理子域名差异。例如,blog.solartravelmag.com 和 solartravelmag.com 显然是同一个网站。
这里我们需要利用 公共后缀列表。这个列表维护了所有公众可以注册的域名后缀(如 .com, .co.uk)。通过分析注册域名,我们可以将子域名“折叠”为主域名。
核心逻辑:
使用 tldextract 库提取注册域名,将所有子域名(如 m., blog.)合并为单一的顶级实体。这步操作进一步清理了数据,为后续的精确匹配做好了准备。
模糊匹配的局限性
经过上述两个确定性阶段,76% 的重复项已被移除。剩下的 24% 则是真正的“硬骨头”。这时,许多人会转向模糊匹配算法(如 RapidFuzz)。
我们使用 RapidFuzz 对剩余数据进行了测试:
- 计算量:在 2 秒内评估了 3,370 万对字符串。
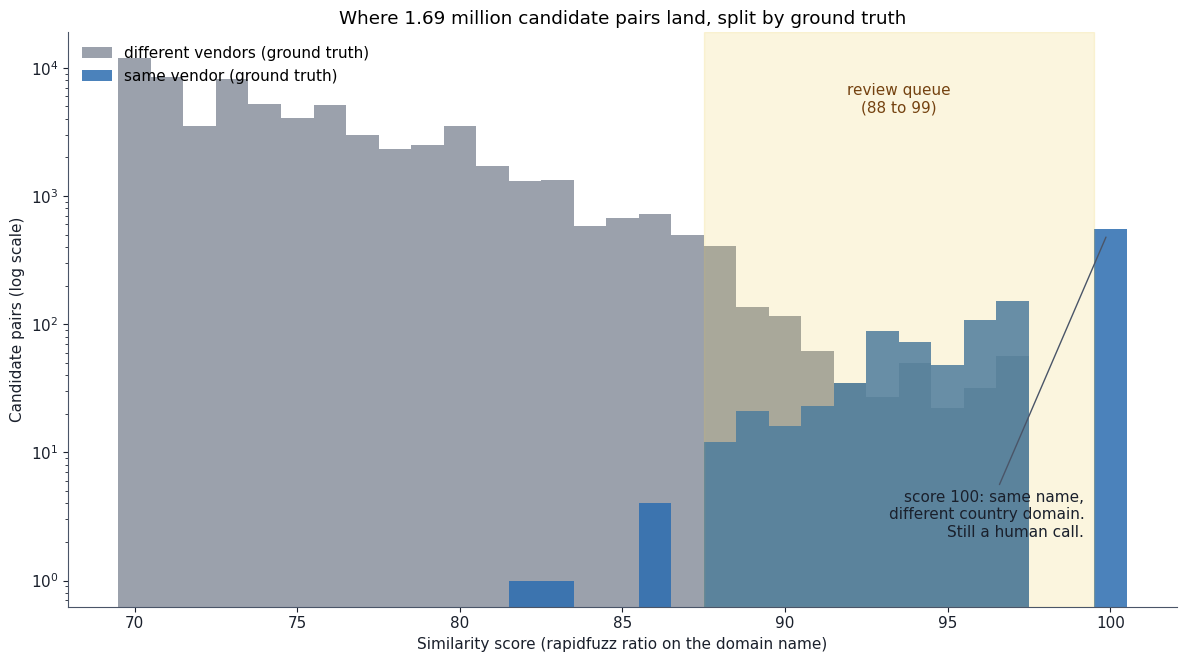
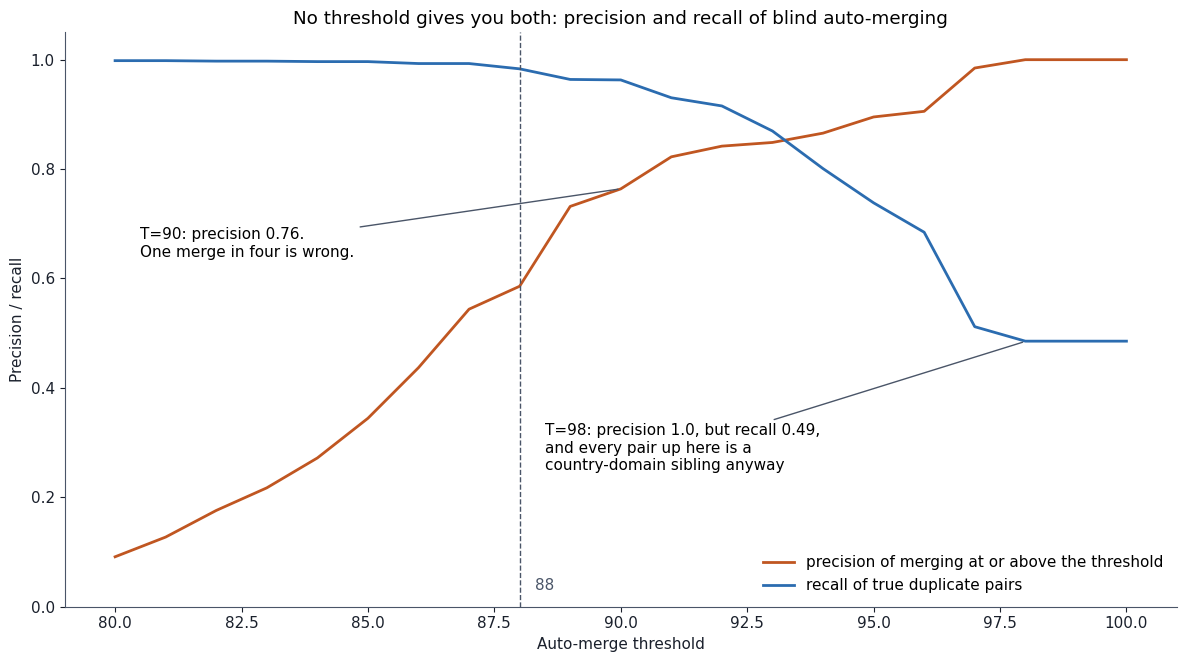
- 结果:算法能给出相似度评分,但不存在一个完美的阈值能安全地合并剩余的所有记录。
开发者启示: 模糊匹配算法擅长计算“相似度”,但它无法理解业务逻辑。字符串匹配只是简单部分,决定“是否合并”的阈值设定才是真正的难点。对于开发者而言,先通过确定性规则清洗掉大部分数据,再处理剩余的模糊数据,是最高效的策略。
总结
在实体解析项目中,不要急于引入复杂的机器学习模型。两个简单的确定性清洗阶段(规范化 + 子域名折叠)就能解决 76% 的问题。模糊匹配应被视为处理残留数据的工具,而非初始解决方案。通过逻辑规则优先,算法辅助的方式,我们可以以极低的成本获得高质量的数据清洗效果。
本文目录(6 节)
本文基于 Towards Data Science 的公开内容,由 AI 辅助整理改写后发布。
原标题:One Vendor, Four Spellings: How Deterministic Stages Beat Similarity Scores
阅读原文