如何用AI不变量终结逐行代码审查
为什么逐行代码审查正在被淘汰
传统的逐行代码审查(line-by-line code review)依赖人工逐行阅读代码,找出潜在问题。这种方式虽然细致,但存在明显瓶颈:审查速度慢、人力成本高、且容易因疲劳而遗漏缺陷。随着软件规模扩大和交付节奏加快,逐行审查已难以满足持续集成/持续部署(CI/CD)的需求。
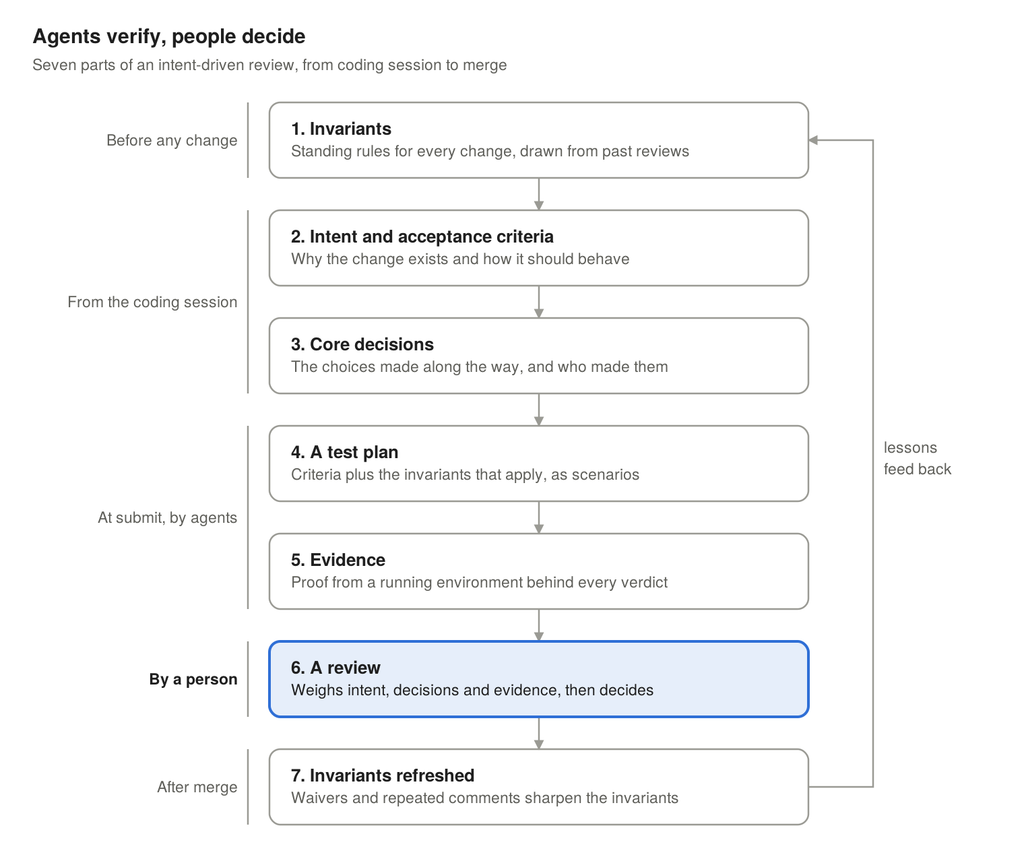
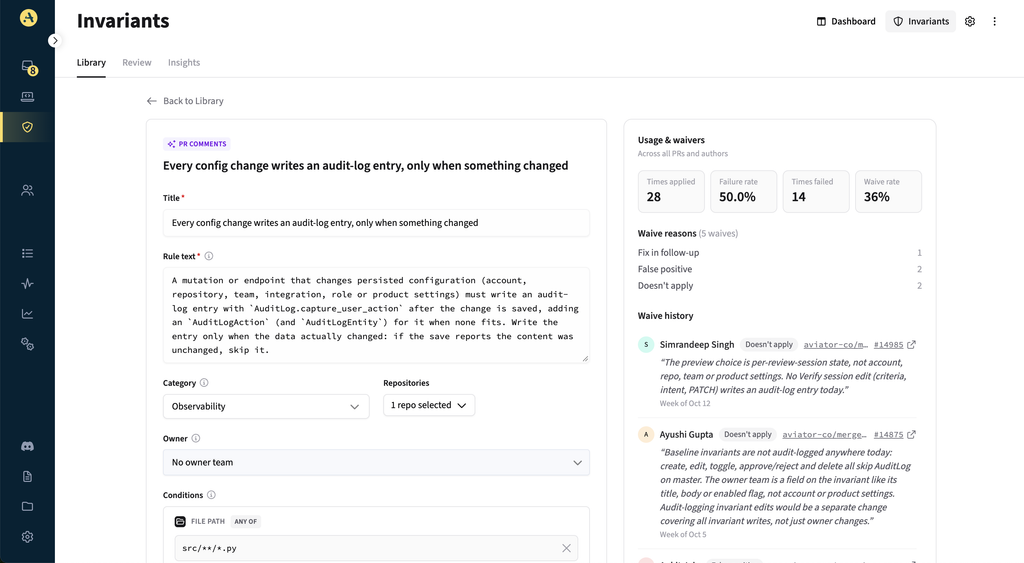
与此同时,AI代码审查工具正在改变这一局面。它们不再只是“找语法错误”,而是能理解代码的语义、架构和业务逻辑。但要让AI真正替代人工逐行审查,关键不在于“让AI读代码”,而在于定义一套可验证的“不变量”(invariants)——即代码必须始终满足的规则或约束。
什么是AI代码审查不变量
不变量是代码在生命周期内必须保持的属性。例如:
- 风格不变量:命名规范、缩进规则、注释格式等;
- 安全不变量:禁止硬编码密钥、禁止SQL拼接、必须使用参数化查询;
- 架构不变量:模块依赖方向、禁止循环依赖、公共API必须保持向后兼容;
- 性能不变量:不允许在循环中发起网络请求、必须使用批量操作。
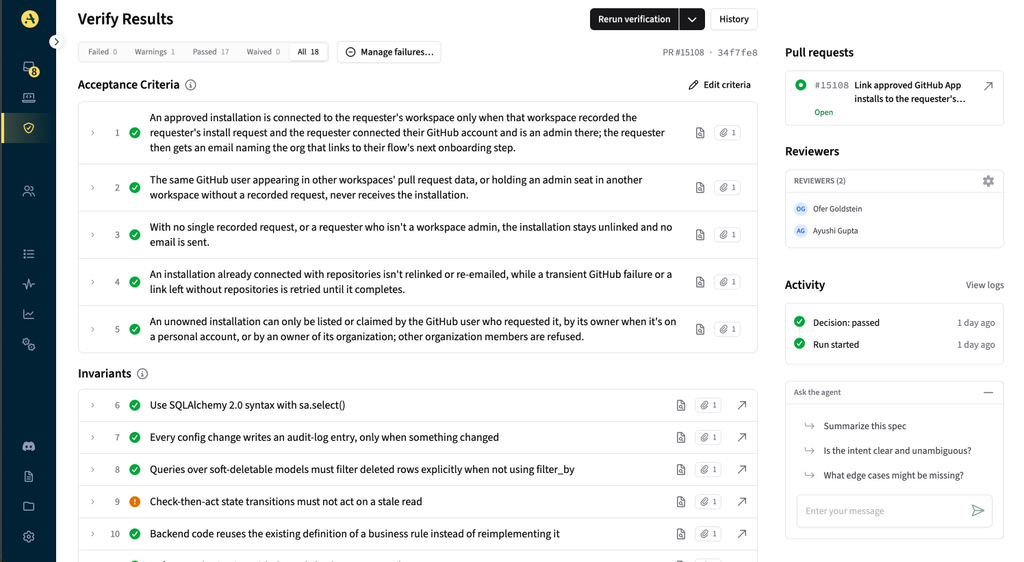
传统上,这些规则靠人工在审查时“凭经验”检查,而AI可以将它们编码为可执行的检查项。一旦定义好不变量,AI就能在提交代码时自动验证,并在违反时给出具体修复建议。
如何逐步实施:三步走
第一步:盘点现有审查痛点
先列出团队当前逐行审查中最常发现的问题类型。比如:空指针异常、资源未关闭、日志缺失、异常被吞掉等。将这些高频问题转化为候选不变量。建议从安全类和资源管理类开始,因为它们对系统稳定性影响最大。
第二步:将不变量集成到CI流水线
为每个不变量编写自动化检查脚本,或使用现成的静态分析工具(如ESLint、Pylint、SonarQube)扩展规则。将这些检查接入CI,确保每次提交都自动运行。初始阶段可设为“警告”级别,让团队熟悉规则;稳定后再提升为“错误”级别,强制阻止合并。
第三步:逐步扩大AI审查范围
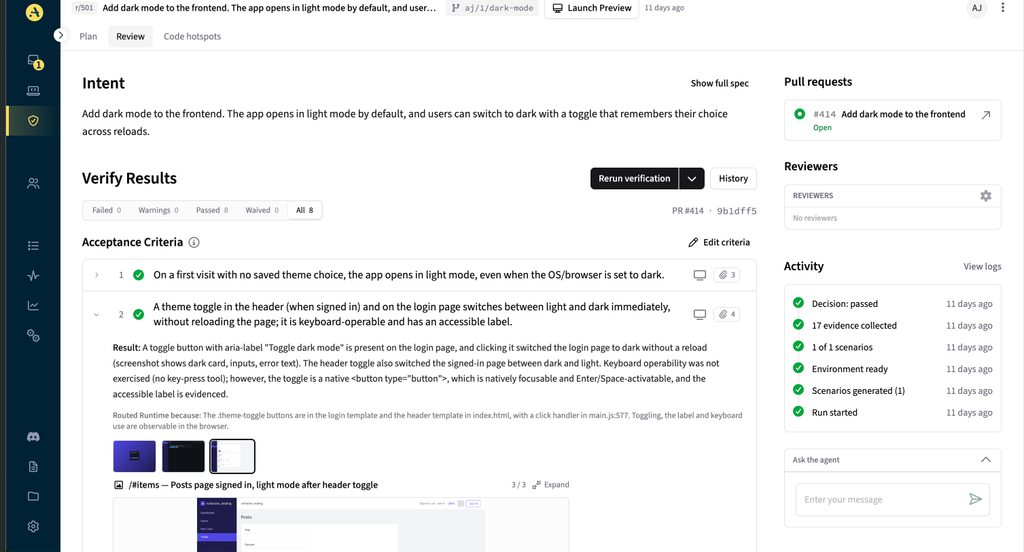
当基础不变量稳定运行后,引入AI代码审查助手。让AI基于不变量库进行语义级审查,例如:判断一个改动是否破坏了模块边界、是否引入了未处理的异常路径。AI的输出应包含:违反的不变量、违反位置、修复建议。此时,人工审查只需关注AI无法判定的设计意图,而不再逐行查找低级错误。
对开发者的实用建议
- 从规则到不变量:不要只写“禁止这样做”,而要定义“必须这样做”的正面约束,这样AI更容易理解和执行。
- 定期更新不变量:代码库演进后,不变量也要随之调整。建议每季度评审一次,删除过时规则,新增新出现的风险模式。
- 保留人工审查的“最后一公里”:AI擅长识别模式,但无法完全理解业务上下文。对于核心算法、支付逻辑等关键改动,仍需人工参与设计评审。
- 记录审查数据:对比引入不变量前后的缺陷率、审查时长和返工次数,用数据证明“逐行审查”确实被有效替代。
结语
杀死逐行代码审查,不是消灭人工审查,而是将重复性、规则性的工作交给AI,让人工专注于更高价值的架构与业务决策。通过逐步建立AI代码审查不变量体系,团队可以在不牺牲质量的前提下,显著提升交付效率。
本文目录(8 节)
本文基于 The New Stack 的公开内容,由 AI 辅助整理改写后发布。
原标题:A step-by-step guide for how to kill the line-by-line code review
阅读原文