快手商业落地:如何平衡Agent的效果、时延与成本
智能互动 Agent 在快手商业场景的落地实践
随着大语言模型能力的持续演进,电商场景下的智能对话系统正从传统的 FAQ 问答,向具备规划、决策与工具调用能力的 Agent(智能体) 架构迁移。本文整理自快手大模型应用算法专家在 AICon 2026 深圳站的分享,旨在探讨在商业场景中,如何让一个对话 Agent 真正跑起来、跑得稳,并持续变好。
一、 商业场景下的“不可能三角”
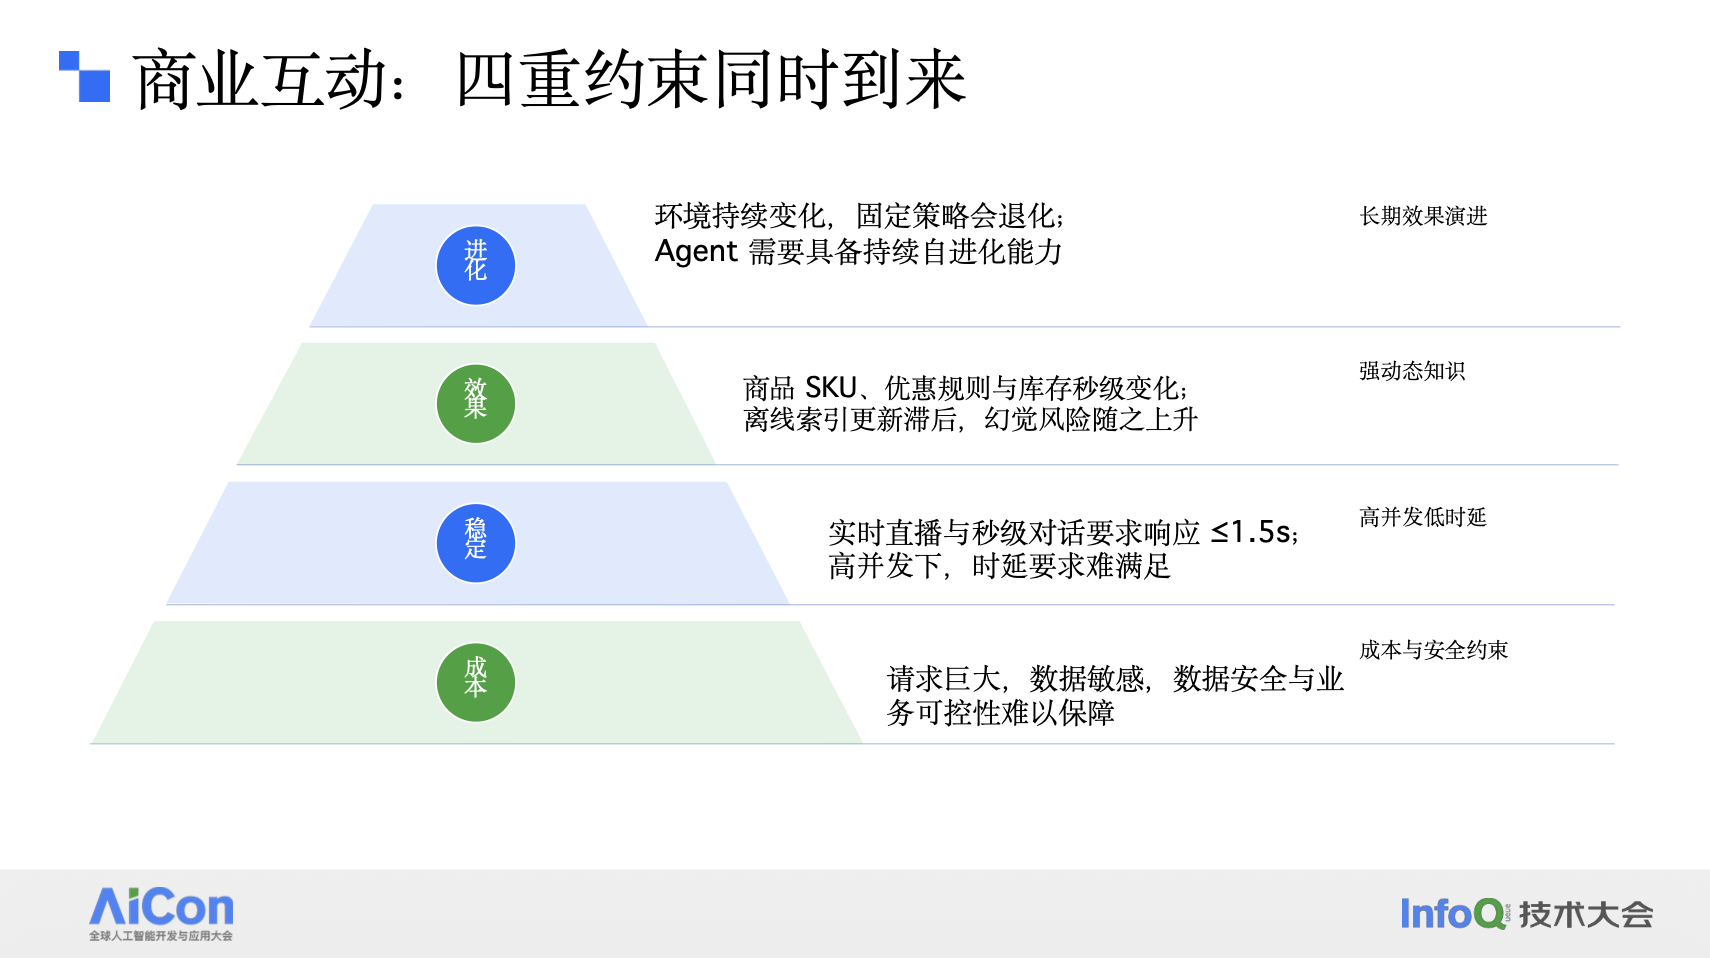
在端侧开发中,我们常听“不可能三角”理论;而在商业场景下,Agent 落地的核心挑战同样可以概括为 效果、时延、成本 的平衡。
- 效果:需要大模型和思考过程,但会增加开销。
- 时延:商业场景 QPS(每秒查询率)极高,且对响应速度敏感(通常要求 1-2 秒内返回)。开源大模型若开启思考模式极易超时。
- 成本:海量请求下,API 调用成本和硬件成本难以控制。
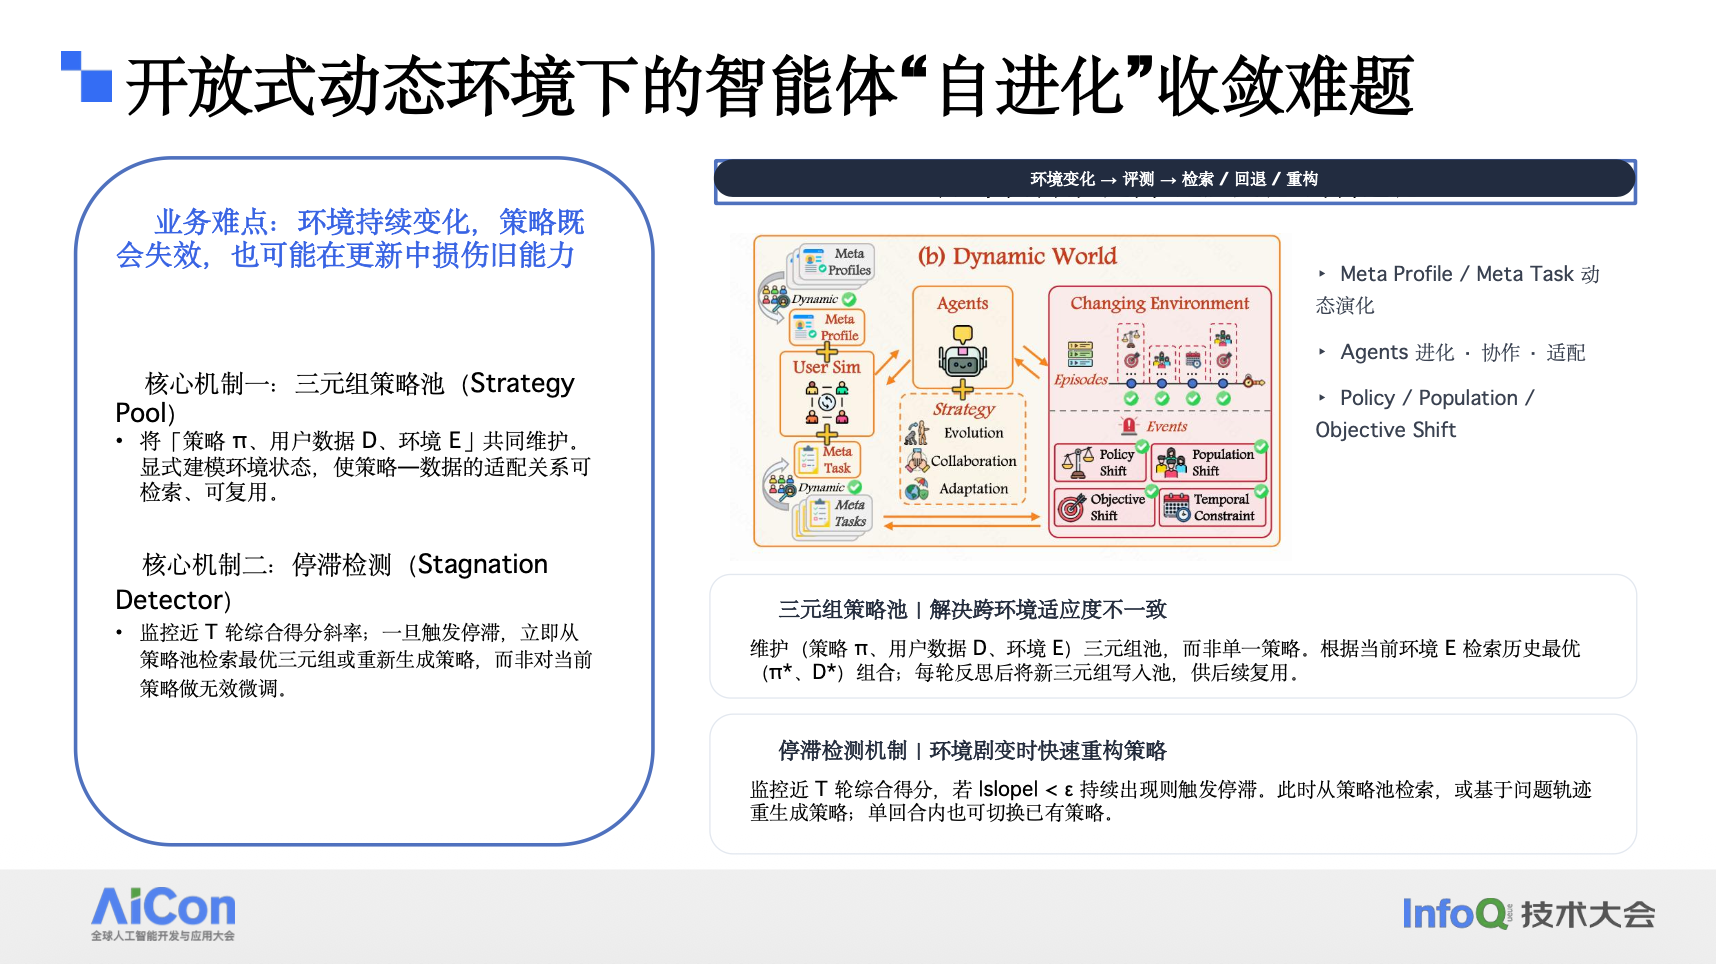
此外,商业 Agent 还面临 稳定性、知识时效性(如直播活动分钟级变更)和 进化(模型越用越退化)四重约束。为了解决这些问题,快手选择了自研大模型,并构建了包含动态知识库、自进化策略和成交归因的闭环系统。
二、 核心技术路径一:构建动态知识库
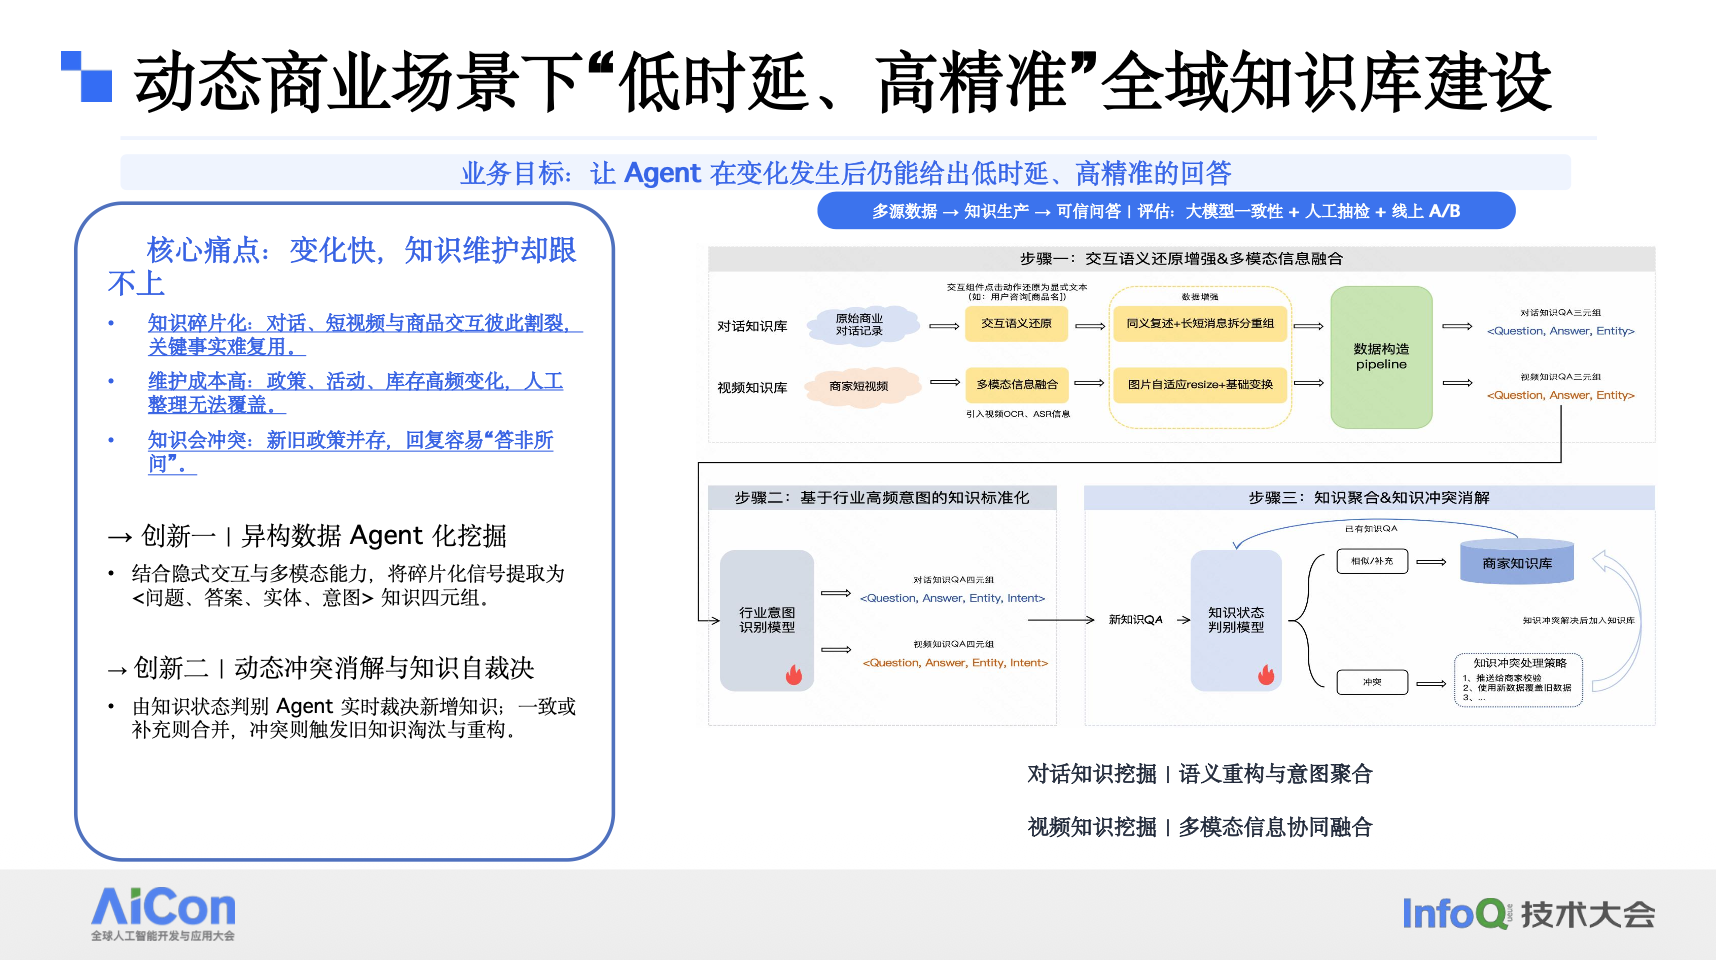
知识是 Agent 的基石。在快手,我们构建了一个全域知识库,旨在解决知识分布散乱、更新滞后及语义冲突等问题。
1. 全域知识整合与挂载
我们将知识来源分为两个维度:
- 对话维度:挖掘用户与人工客服的真实对话,沉淀为 QA 对。
- 视频维度:从商家上传的短视频和直播切片中提取知识。
提取后,我们会将知识挂载到具体的 Entity(实体) 上,例如将商品价格挂载在“商品维度”,店铺发货规则挂在“店铺维度”。同时,通过 Intent 标签进行分类,以便精准检索。
2. 图片知识的轻量级优化
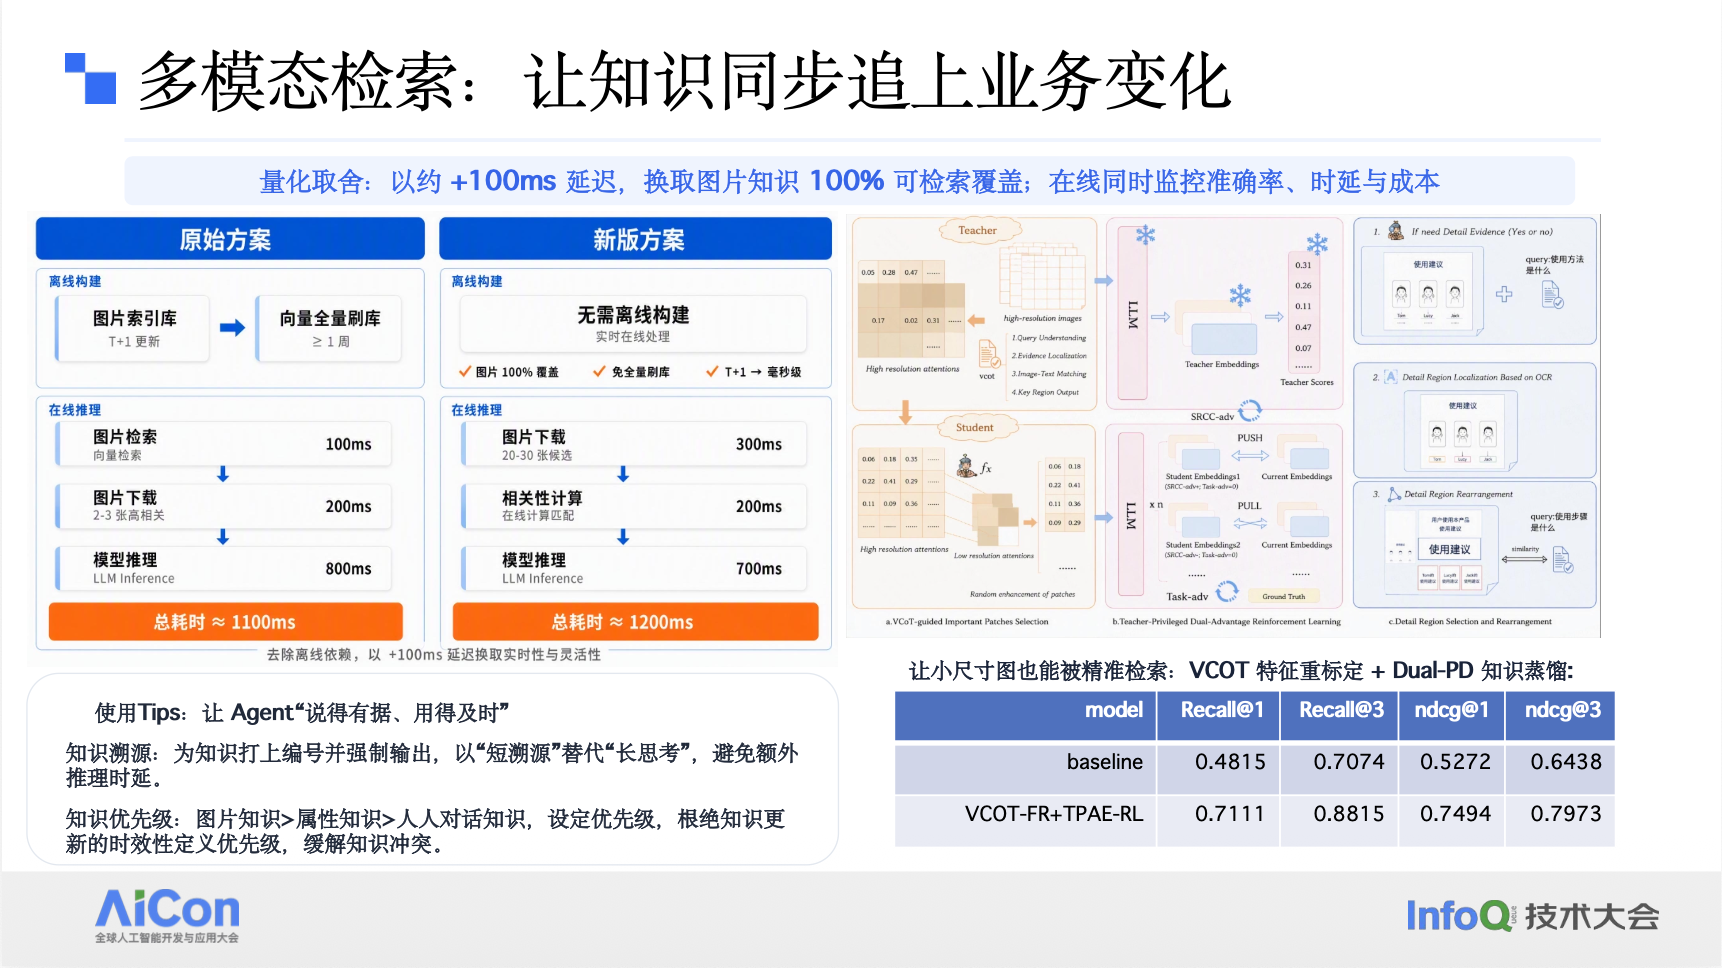
在直播场景下,商家活动变化极快,离线更新(如天级别)已无法满足实时问答需求。针对图片这一核心知识载体,我们采用了在线检索策略,而非传统的全量索引。
- 粗排与精排结合:用户提问时,实时拉取商品下约 20-30 张图片,在线计算相关性,筛选出 1-2 张最相关的图片。
- Token 限制与 VCoT:为了控制时延,我们将图片 Resize 至 224×224,Token 数控制在 1800-2000 左右,检索耗时控制在 200ms。为了解决 Resize 导致的语义变形和文字丢失问题,我们采用了 VCoT(视觉思维链) 技术:在大图上训练 Teacher 模型,提取讲解和知识;在 224×224 小图上训练 Student 模型,使其输出向量对齐 Teacher。推理阶段,我们还利用连通区域检测算法提取图片文字,保留关键信息。
3. 实用落地技巧
- 知识编号:为了防止模型“胡说八道”,我们强制模型输出知识编号。这几乎不增加耗时,却能有效控制幻觉,用短溯源代替长思考。
- 冲突消减:通过模型对比现有知识库,自动处理冲突和去重,形成数据飞轮。
三、 核心技术路径二:解决进化与奖励问题
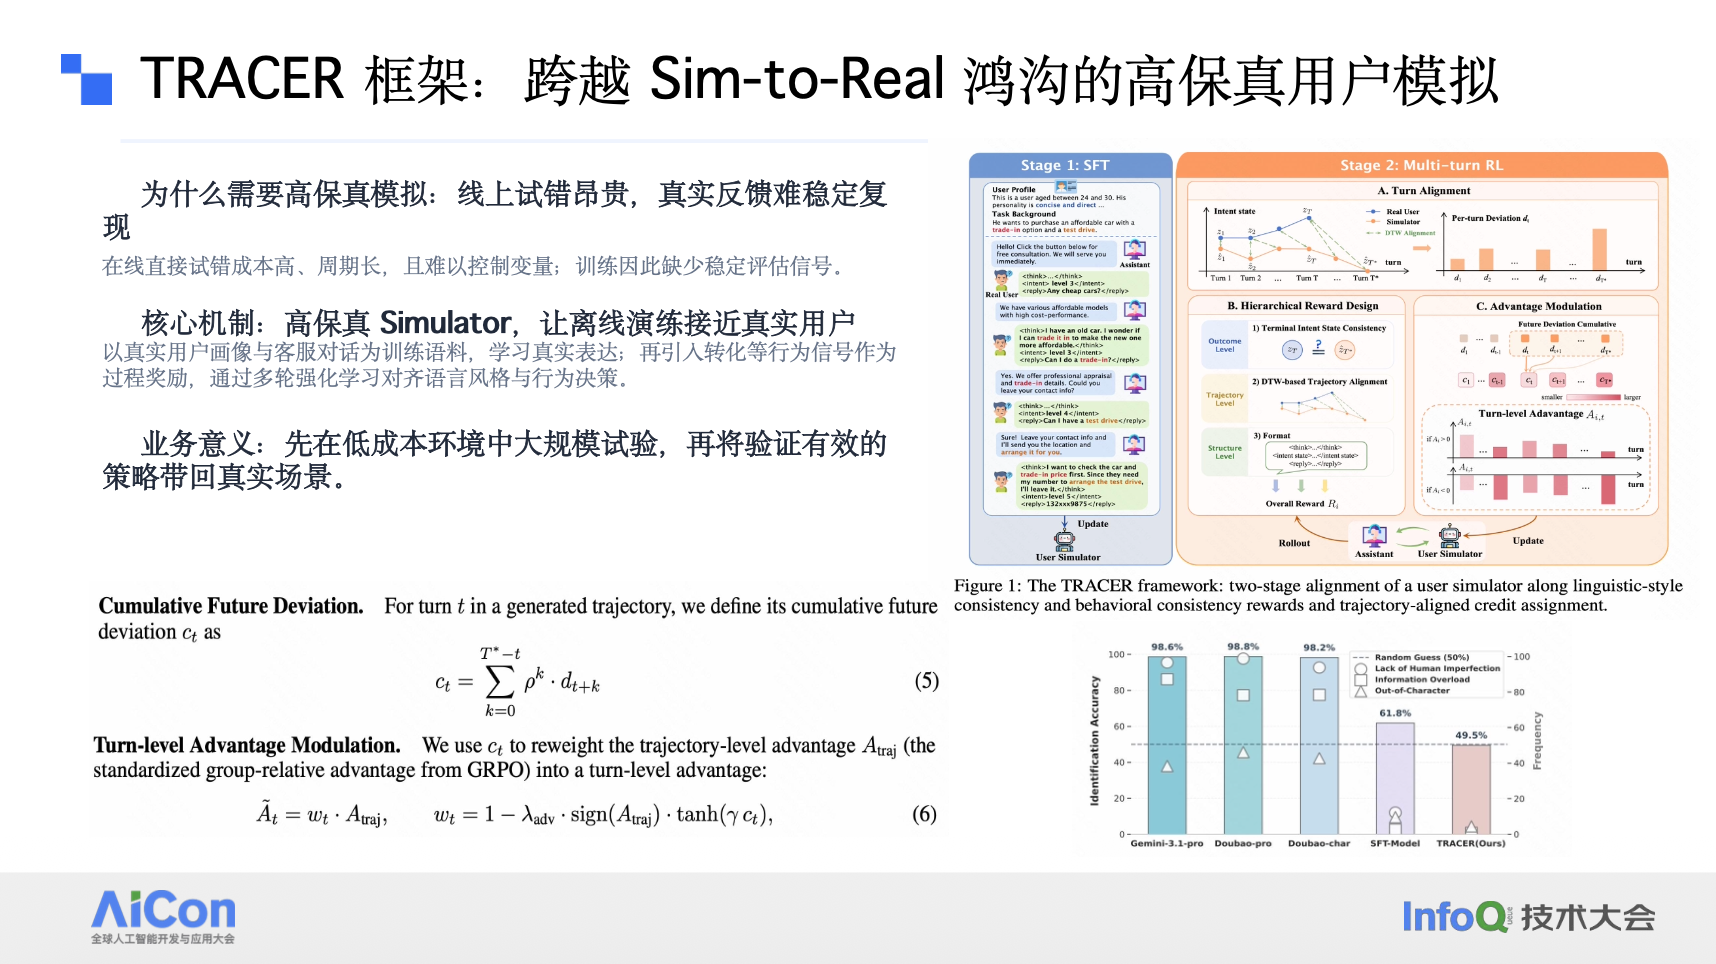
Agent 如何避免越用越退化?如何学会复杂的交易策略?我们需要解决 用户模拟 和 成交归因 两大难题。
1. 用户模拟与自进化
我们构建了用户模拟器,在业务场景下进行真实训练,确保 Agent 能应对各种复杂追问和工具调用需求。通过模拟用户反馈和模型自进化策略,让 Agent 在真实对话中不断优化。
2. 成交归因与稀疏奖励
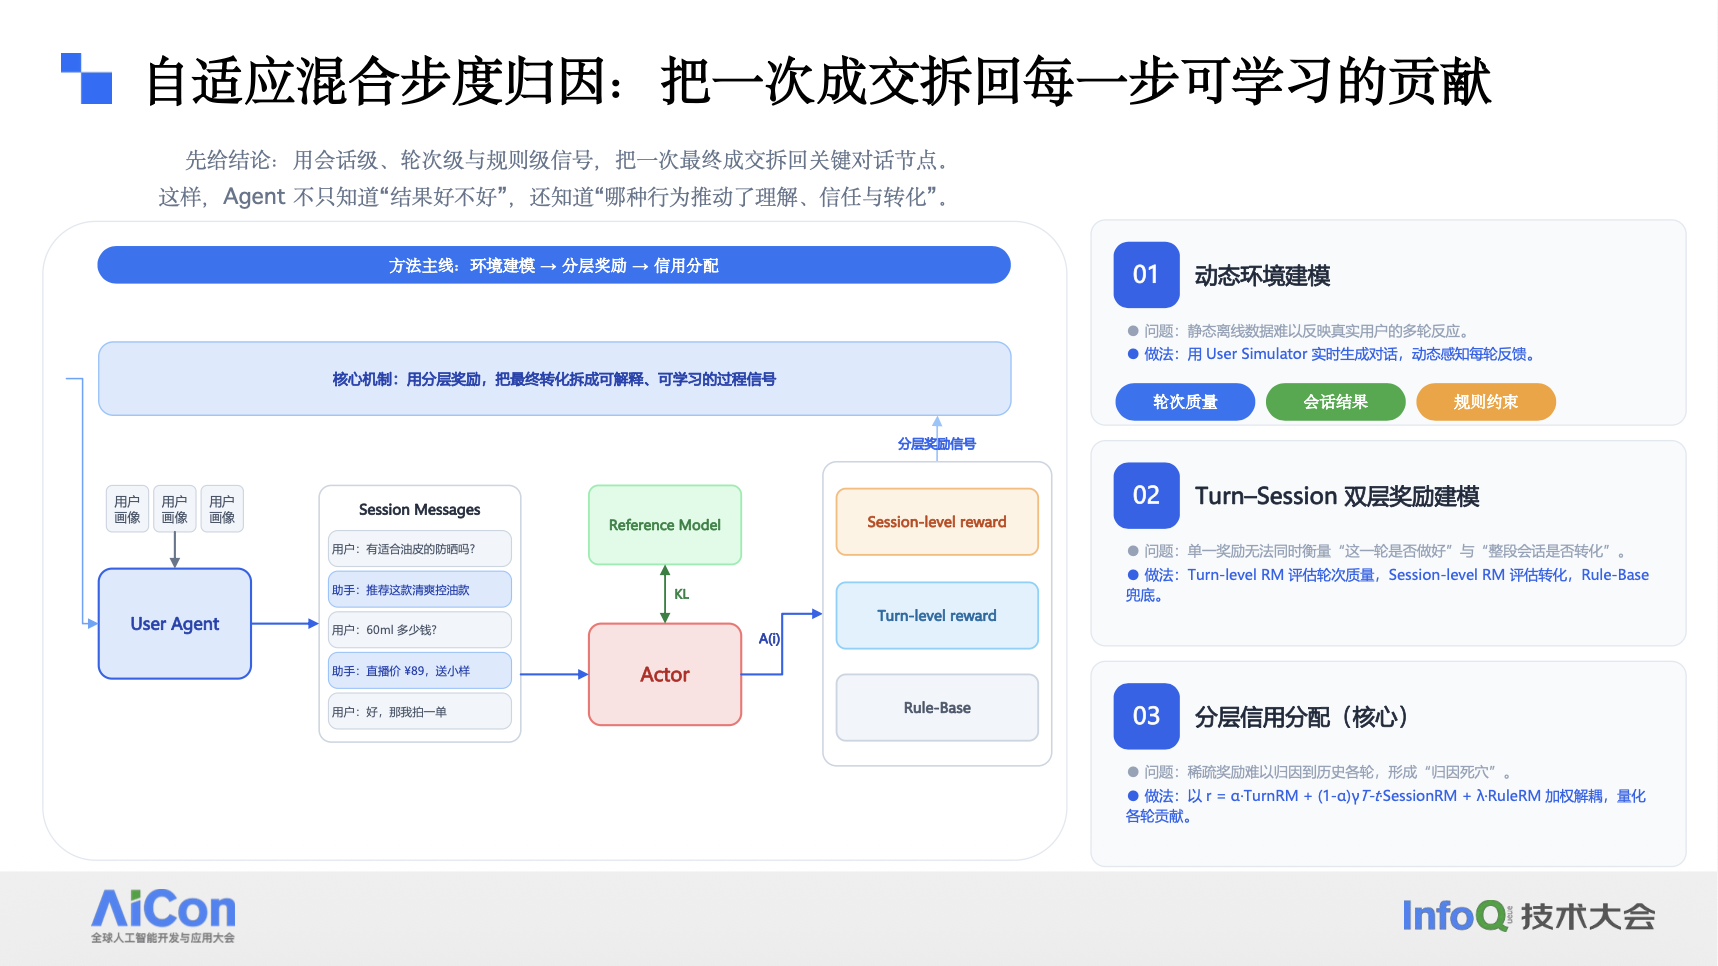
在对话场景中,最终有没有成交或解决问题,往往要到最后一轮才能拿到信号。这种 奖励稀疏 问题导致中间过程的优化信号不足。
为此,我们设计了 分层奖励 和 信用分配 机制。通过在对话的各个阶段给予合理的中间奖励信号,引导模型学会正确的交易策略和对话流程,从而在最终成交时拿到更高的奖励。
总结
快手商业 Agent 的落地实践表明,自研模型结合动态知识库和精细的工程化策略,是平衡效果、时延与成本的最佳路径。通过 VCoT 对齐、在线检索和知识编号等技巧,我们成功构建了一个既懂业务又能实时响应的智能体系统,为电商行业提供了极具价值的参考范式。