警惕标签陷阱:评估AI检索时为何“错”得这么对?
警惕标签陷阱:评估AI检索时为何“错”得这么对?
在人工智能检索领域,我们常常面临一个看似矛盾的现象:模型检索出的结果,在标签上是“错误”的,但在语义上却是“正确”的。
引言:当“正确”变得荒谬
想象这样一个场景:你中彩票了,决定购买一辆梦寐以求的法拉利。你访问一个豪华汽车网站,找到一辆完美的法拉利跑车,点击“寻找相似车辆”。
系统返回了结果:四辆法拉利(很好!),一辆兰博基尼(很酷!),以及一辆法拉利SUV(等等,这是什么?)。
你可能会对兰博基尼的推荐感到惊喜,因为它拥有低趴的车身、流畅的曲线和运动的设计,与法拉利在视觉上非常相似。然而,法拉利SUV虽然品牌相同,但造型完全不同,显然不符合你的需求。
然而,如果检索系统的评估标准仅基于品牌标签,那么兰博基尼会被判定为“错误”的结果,而法拉利SUV反而会被判定为“正确”的结果。
这就是语义相似性与类别一致性之间的经典冲突。检索系统发现了不同类别物体之间有意义的关系,却仅仅因为标签不匹配而受到惩罚。
核心矛盾:标签 vs. 语义
这一现象揭示了基于标签的检索评估存在一个巨大的局限性:
- 语义相似:物体在外观、功能或概念上接近(如法拉利与兰博基尼)。
- 标签一致:物体属于同一个预定义类别(如法拉利与法拉利SUV)。
这两者并不总是重合的。当检索系统试图打破类别限制,去发现更广泛的关联时,传统的评估标准往往会误判其价值。
实验验证:CLIP与建筑风格
为了深入研究这个问题,我们使用 CLIP(Contrastive Language–Image Pre-training) 模型进行实验。CLIP 是一种著名的视觉-语言模型,它能够在共享的嵌入空间中同时表示图像和文本。
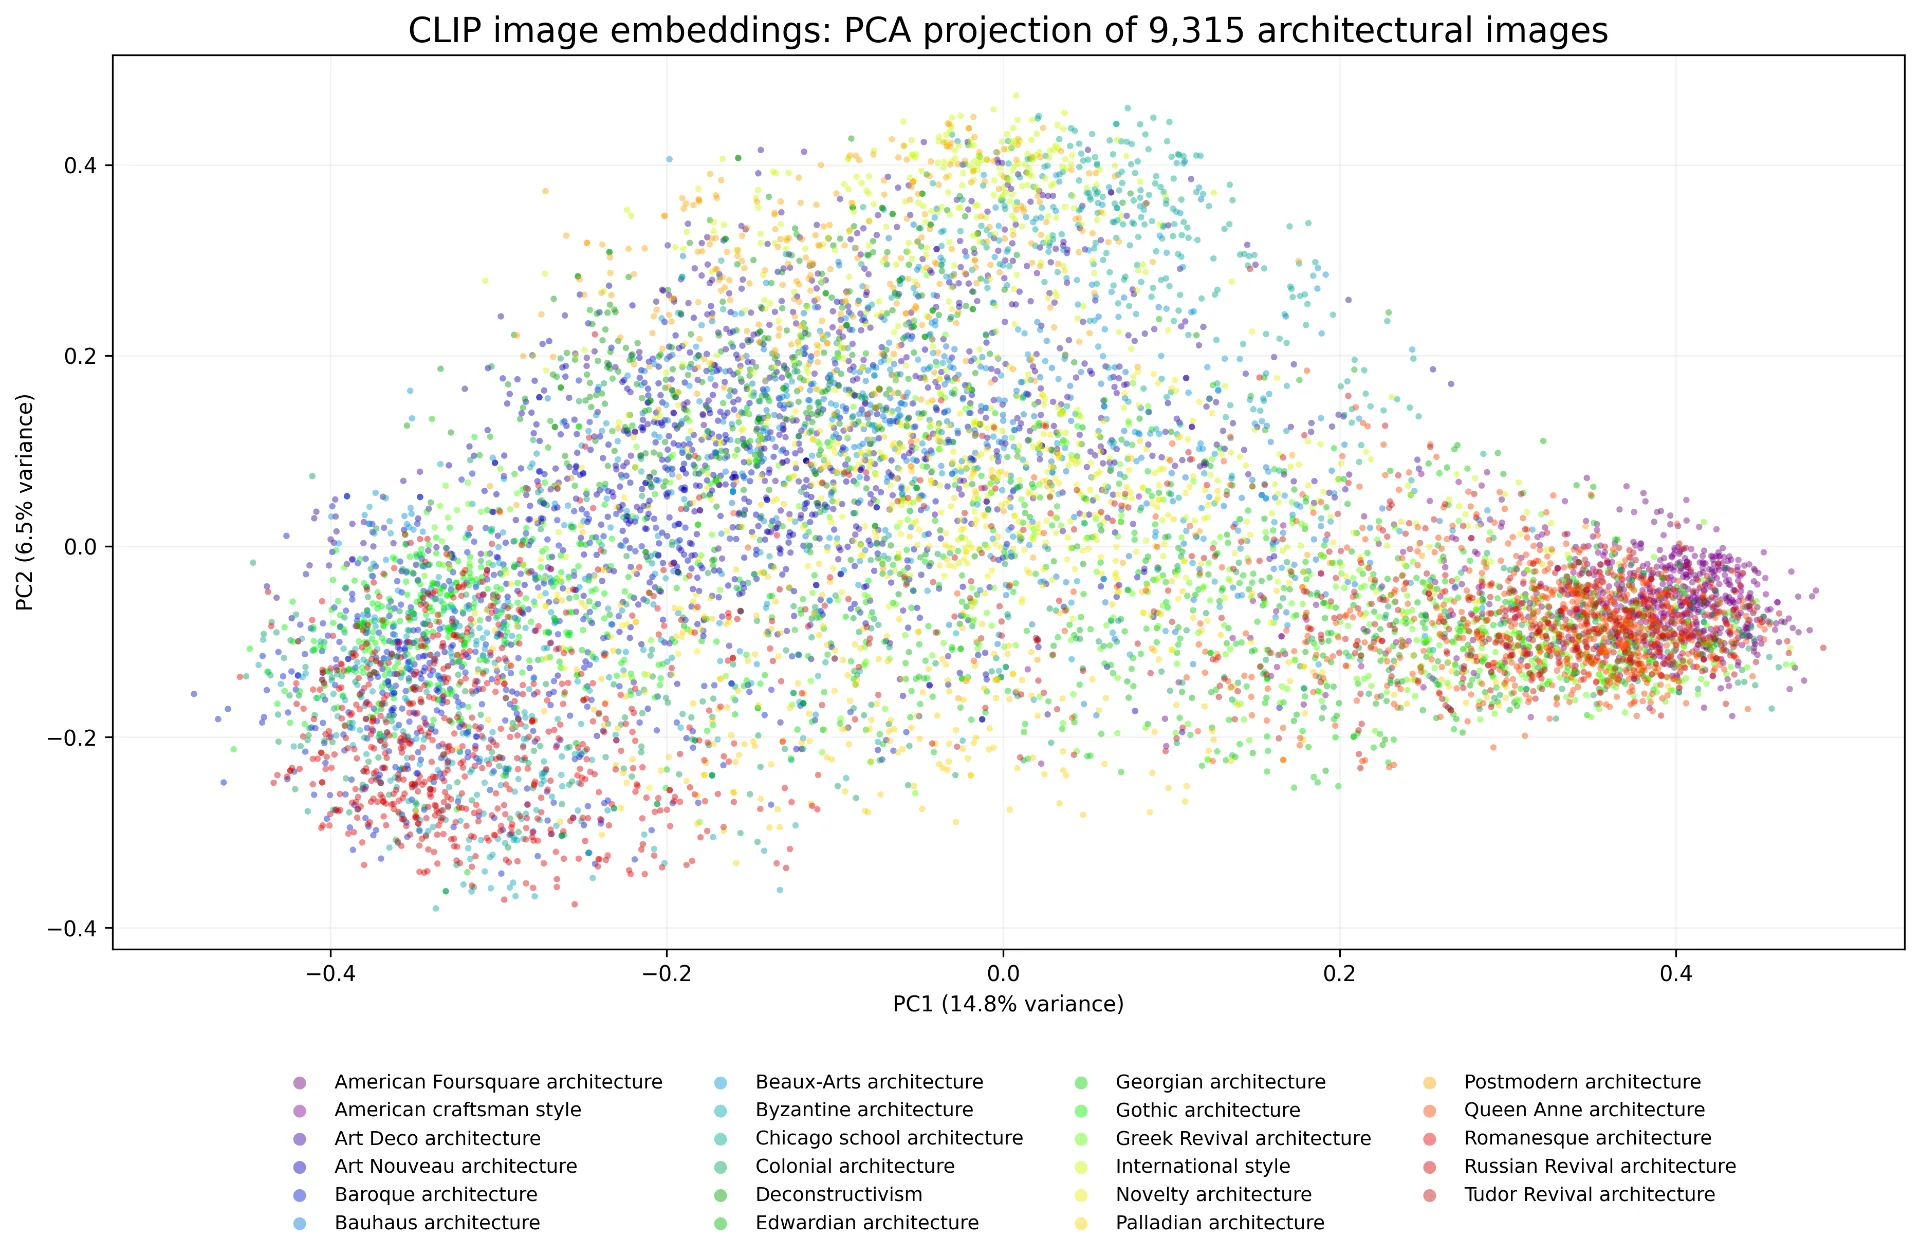
实验设计: 我们使用了一个包含 9,315 张图片和 23 种建筑风格的 Kaggle 数据集。
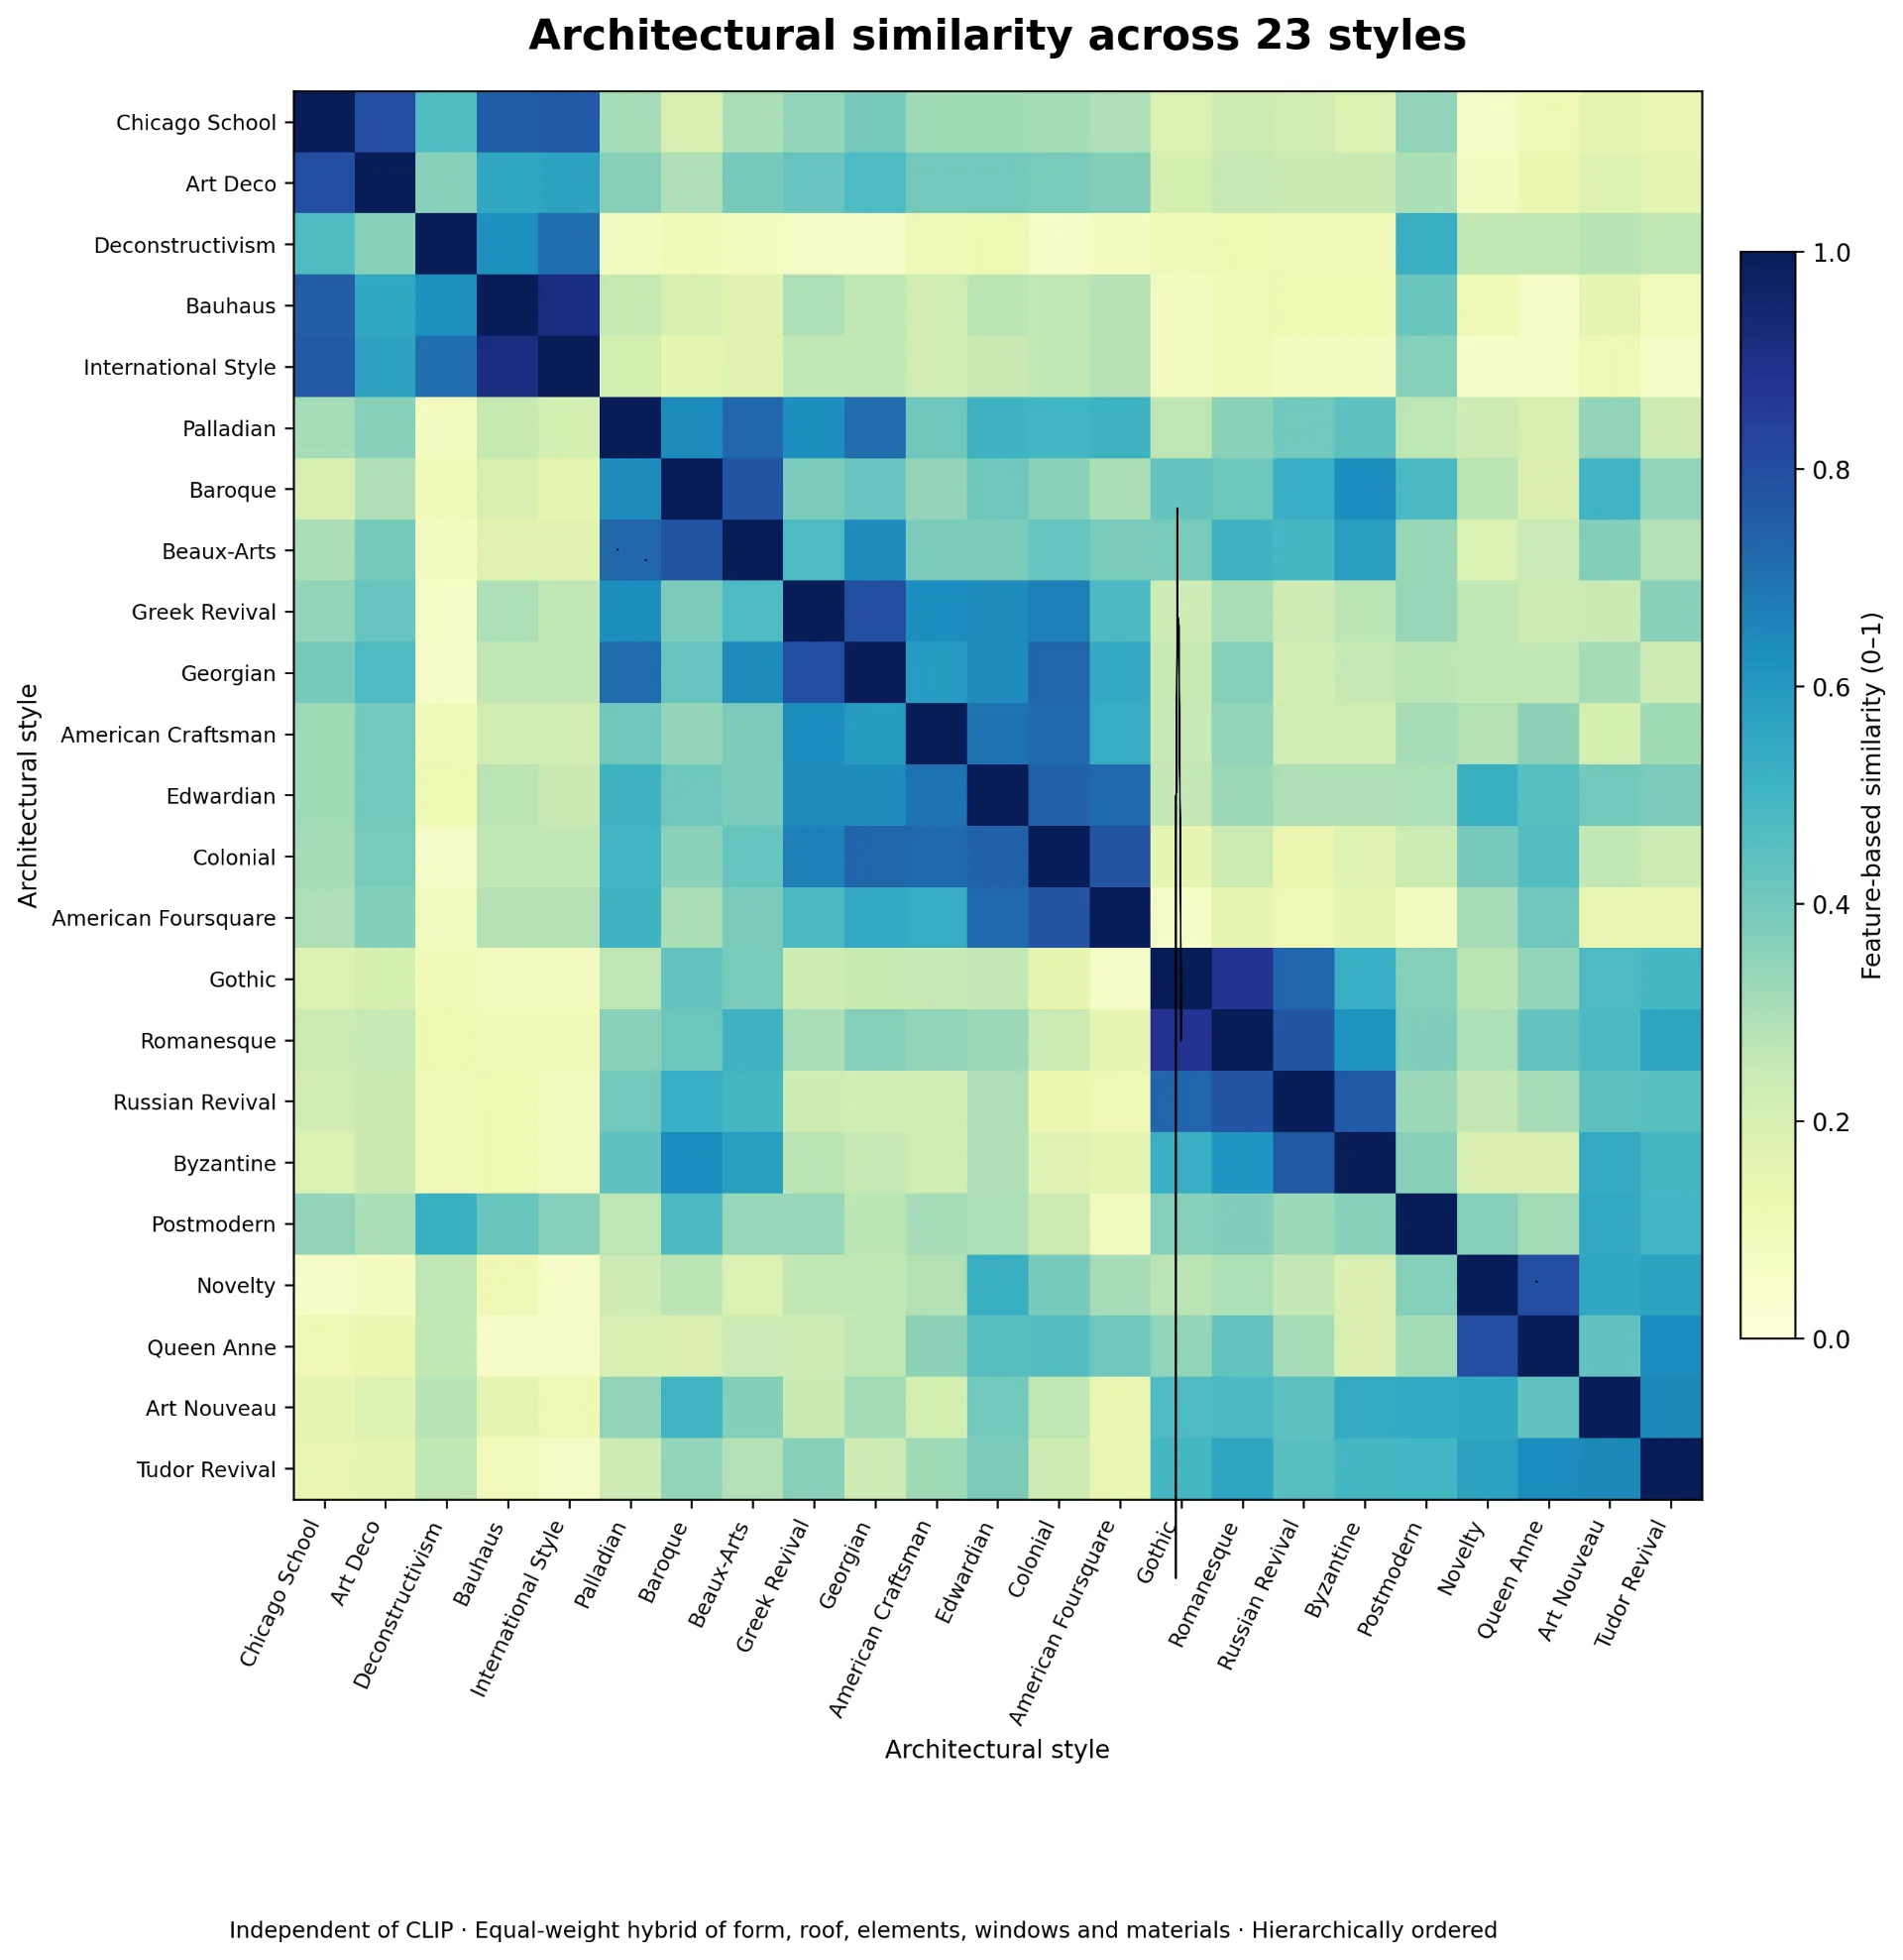
为什么选择建筑? 建筑是研究这一问题的完美案例。不同风格的建筑(例如哥特式与巴洛克式)往往拥有相似的屋顶类型、窗户设计、材料纹理、对称性和装饰细节。两栋建筑看起来可能非常相似,但它们的标签却完全不同。
评估指标:Precision@k
为了衡量模型表现,我们使用了 Precision@k (P@k) 指标。
- 定义:在检索返回的前 k 个结果中,有多少比例与查询图像的标签一致。
- 应用:例如,Precision@5 为 0.80,意味着前 5 个结果中有 4 个属于同一种建筑风格。
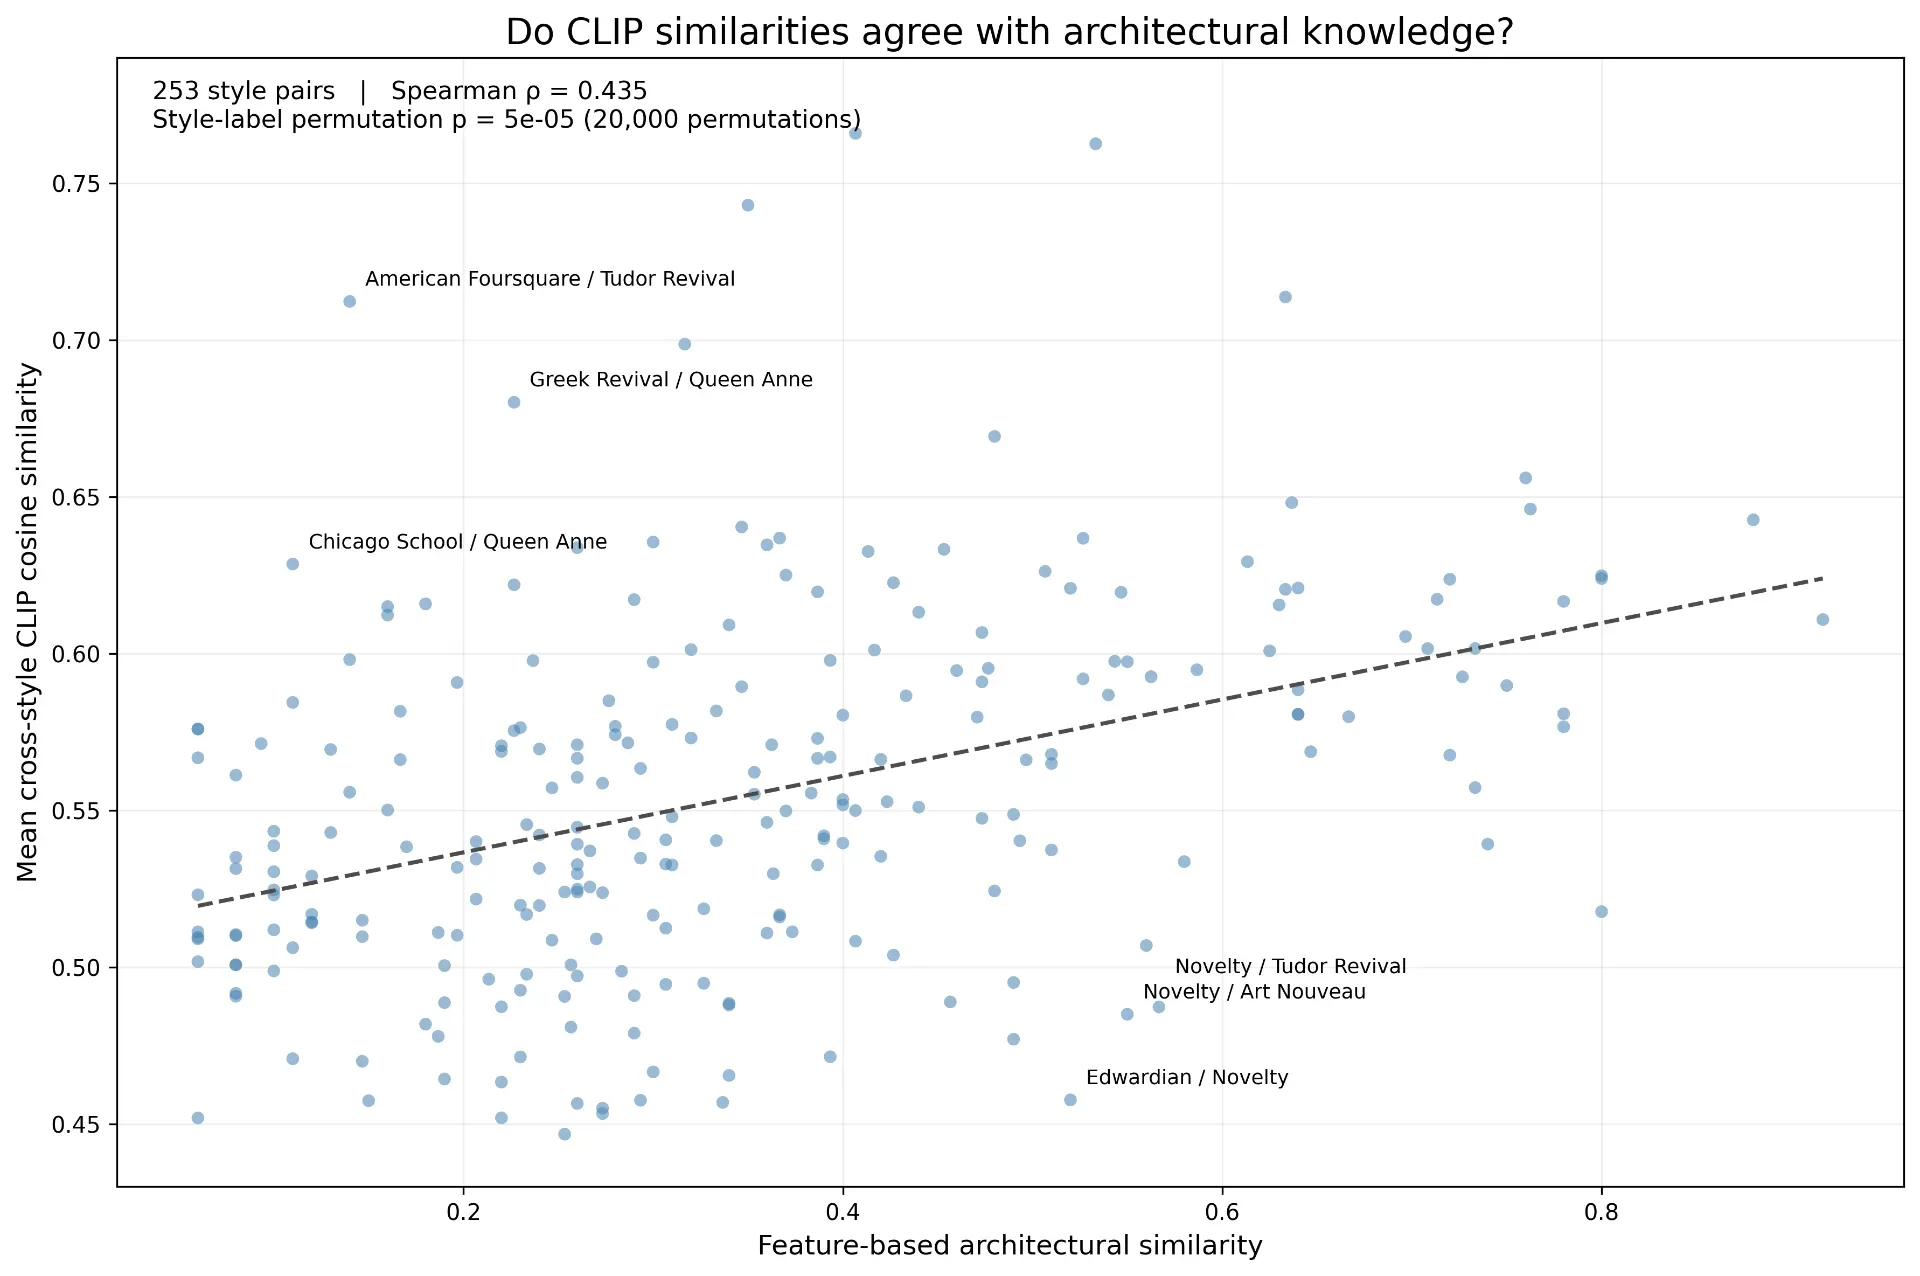
我们的目标不仅仅是看模型是否找到了同标签的图片,而是要看模型是否捕捉到了建筑风格的语义特征(如屋顶、结构等)。
深度解读:重新定义“错误”
通过分析 CLIP 的检索结果,我们发现了一些有趣的模式:
- “错误”往往是语义相关的:模型检索出的“错误”标签图片,往往在视觉特征上(如屋顶形状、建筑比例)与查询图片高度相关。
- 特征提取的深度:CLIP 似乎能够理解“风格”的抽象概念,而不仅仅是死记硬背标签。
这对开发者意味着什么?
传统的检索评估往往过于僵化,只看“是否命中标签”。然而,在实际应用中,用户往往更看重语义上的匹配度。
- 对开发者:在构建检索系统时,不要仅仅依赖准确率指标。对于视觉模型,应结合余弦相似度、语义特征匹配等更细粒度的指标来评估系统质量。
- 对AI使用者:理解模型的局限性。当模型给出的结果与标签不符时,不要立即认为是故障,它可能正在以一种更符合人类直觉的方式(基于视觉相似性)提供信息。
结语
“如果你想要一辆法拉利,却收到了一辆兰博基尼,你会真的抱怨吗?”
在语义检索的世界里,答案可能是否定的。评估AI系统时,我们需要超越简单的二元判断(是/否),去拥抱相似性的连续谱。有时候,打破标签的束缚,才是真正理解世界的开始。