解析 GPT-5.6 的“推理努力”模式:如何控制模型的思考深度
控制大模型的思考深度:解析“推理努力”模式
自 OpenAI 发布 o1 模型以来,基于大语言模型(LLM)的推理能力已成为 AI 研究的热点。紧接着,DeepSeek-R1 推出了使用强化学习进行训练的方案。最近,OpenAI 在 2026 年 7 月 18 日发布了 GPT-5.6 模型家族,其最大的亮点在于引入了**“推理努力”**的概念。本文将深入探讨这一机制,以及开发者如何利用它来优化模型性能。
什么是“推理努力”?
首先,我们需要明确什么是“推理模型”。在 AI 研究语境下,它并不指模型像人类一样进行生物意义上的思考,而是指模型能够输出中间的推理轨迹。
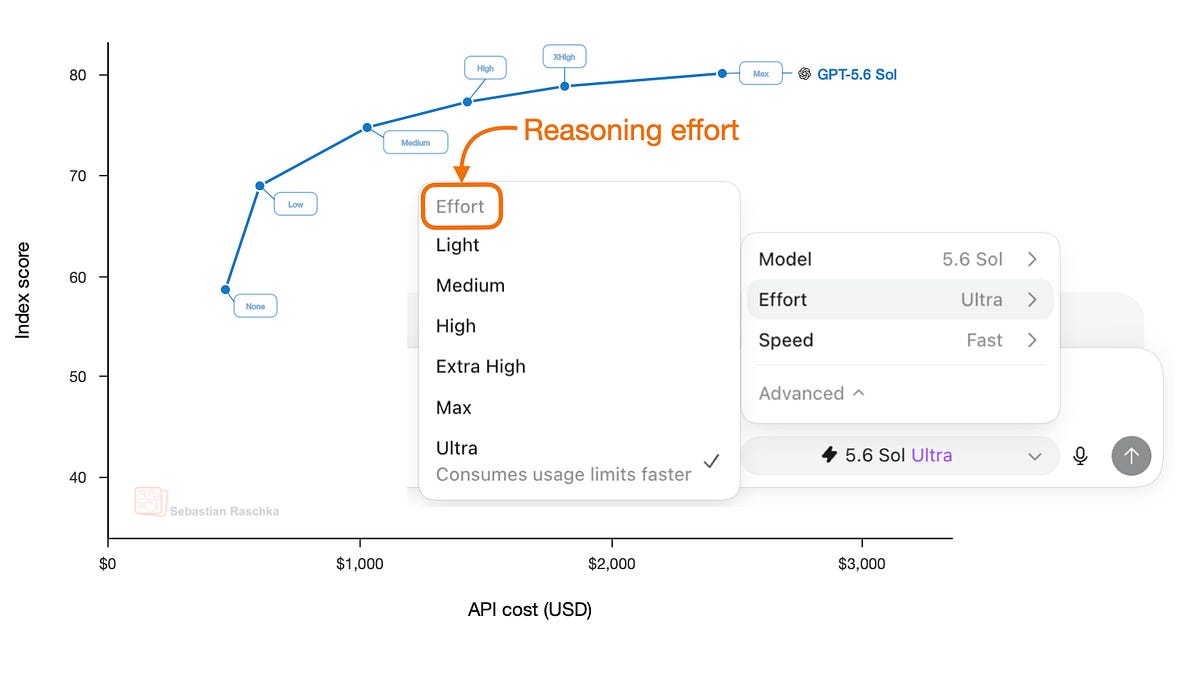
简单来说,当面对一个复杂问题时,传统模型会直接给出答案,而推理模型会像解题步骤一样,逐步分析问题,最后才输出结果(如上图所示)。GPT-5.6 的核心创新在于,它允许用户根据需求调整这种“思考”的强度,即推理努力。
GPT-5.6 的三种努力级别与实战价值
GPT-5.6 提供了三种不同的推理努力设置,这对开发者来说是极具实用性的功能:
- 低努力模式:模型快速给出答案,适合处理简单或常规任务,响应速度快。
- 中等努力模式:平衡了速度与准确性,适合大多数日常开发场景。
- 高努力模式:模型会进行更深入的思考,甚至使用多个子代理来加速复杂推理过程(如 GPT-5.6 Ultra 模型所示),适合解决高难度的数学或逻辑问题。
对开发者的启示:通过在代码中动态调整这个参数,你可以在成本和准确性之间找到最佳平衡点,避免在简单任务上浪费算力,或在复杂任务上因思考不足而失败。
技术核心:训练缩放与推理缩放
要深入理解如何控制推理努力,必须了解提升模型能力的两种核心途径:训练缩放与推理缩放。
1. 训练缩放:RLVR 的应用
训练缩放是指通过数据训练让模型本身变强。DeepSeek-R1 提出了一种名为 RLVR(带验证奖励的强化学习) 的技术。
- 验证机制:模型在数学和代码任务上尝试解题,系统使用工具(如 SymPy、编译器)来验证答案的对错。
- 奖励信号:模型根据验证结果获得 0(错误)或 1(正确)的奖励。
关键发现:在 DeepSeek-R1 的训练过程中,他们尝试利用中间的“推理轨迹”来更新模型,但发现这并不如直接使用最终答案的奖励信号有效。因此,目前的训练主要依赖最终结果的验证。
2. 推理缩放:在运行时发力
推理缩放则是在模型已经训练好的基础上,通过增加推理时间来提升性能。GPT-5.6 中的“推理努力”设置正是推理缩放的具体体现。通过让模型在生成过程中花费更多步骤或调用更多子代理,模型能够处理更复杂的逻辑链,从而在保持模型架构不变的情况下,通过“时间换空间”来换取更高的准确率。
总结
推理模型已经从实验室走向了生产环境,GPT-5.6 引入的“推理努力”设置标志着这一领域的成熟。对于开发者而言,理解 RLVR 的训练原理和推理缩放的机制,不仅能帮助你更好地使用像 GPT-5.6 这样的模型,还能为你开发下一代智能推理系统提供理论依据。