Jev:超越LLM的决策型AI模型
1来源:Towards Data Science
一种全新的AI决策模型
大语言模型(LLM)主导了AI领域好几年,但TypeSafe.AI最近发布的Jev模型提出了一个不同的思路——它自称是第一种"System One模型",从根本上区别于我们熟悉的LLM。它更适合分类、意图识别、LLM-as-a-judge等日常任务。本文梳理它的设计思路、输入输出机制,以及在客服意图分类场景下的实际表现。
与LLM的核心差异
LLM的训练目标是预测下一个token,擅长生成自然流畅的长文本和对话。而System One模型的目标是评估当前状态并输出结构化答案,不生成自由文本。
两者都能接受自然语言输入,但在后训练阶段分道扬镳:
- LLM 通常使用 RLHF(基于人类反馈的强化学习),让模型对齐人类偏好。但这容易导致"讨好型"回答和自信满满的幻觉。
- Jev 使用 RLCD(基于校准决策的强化学习),训练模型同时返回决策结果和概率分布。
这意味着Jev不仅能告诉你答案是什么,还能告诉你它有多确定——这正是决策场景中最需要的信息。
输入与输出机制
Jev的输入称为"state"(状态),用于定义上下文和要回答的问题。它支持三种格式:
- 单条消息:如"我能修改我的PIN码吗?"
- JSON对象:如
{"message": "我能修改我的PIN码吗?", "user_id": 123} - 消息数组:如
["你好!有什么可以帮您?", "我能修改我的PIN码吗?"]
最佳实践是使用带明确字段名的对象格式,便于模型推理上下文。
输出方面,由于System One模型不生成自由文本,需要通过预定义的原语指定答案类型:
| 原语 | 用途 | 示例 |
|---|---|---|
| Choice | 从多个预定义选项中选一个 | 请求类型:物流/账单/账户 |
| Score | 有序值集合中的评分 | 情感:负面/中性/正面 |
| Noul | 是/否判断 | 问题是否已解决? |
置信度:决策的关键
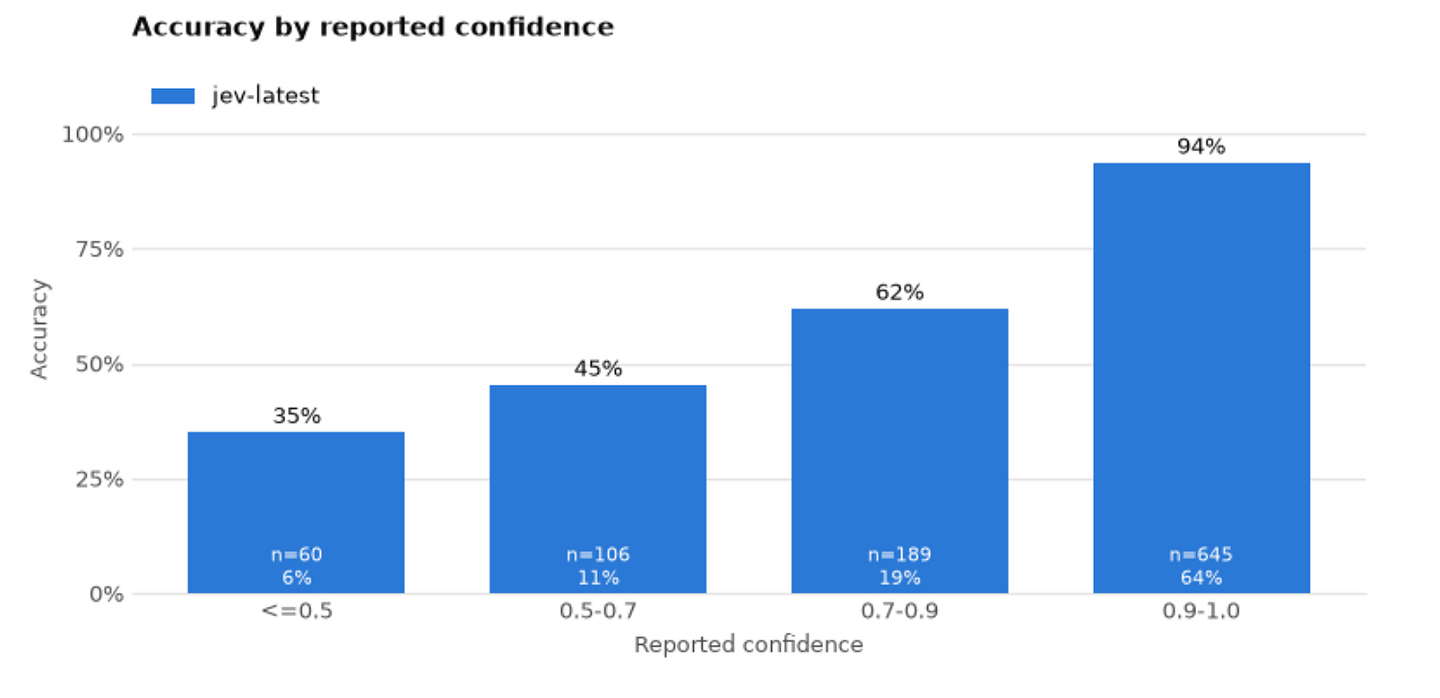
每次调用,Jev不仅返回答案,还返回所有可能取值的概率分布。这带来一个实用能力:
- 高置信度(概率集中在单一选项)→ 可自动执行决策,如自动回复客户
- 低置信度(多个选项概率接近)→ 应转人工处理
这种"知道自己不知道"的能力,是LLM在决策场景中最大的短板。
性能表现
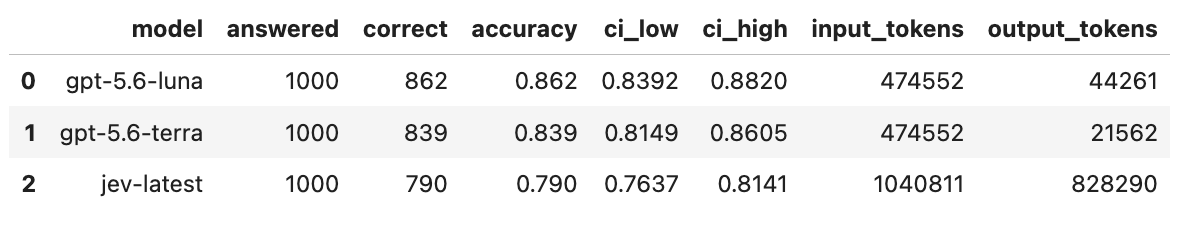
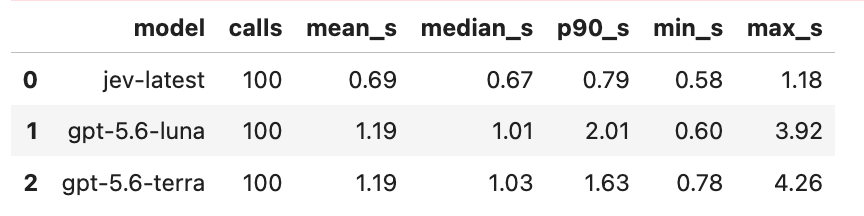
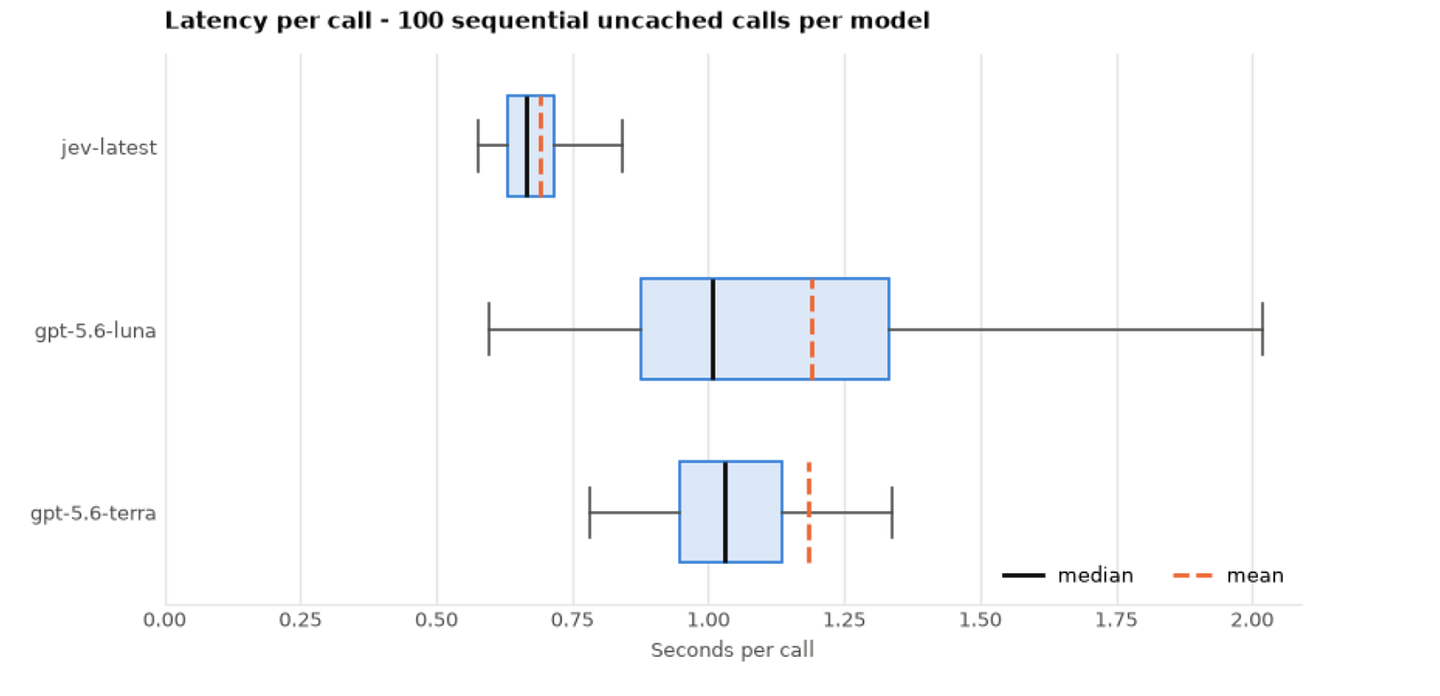
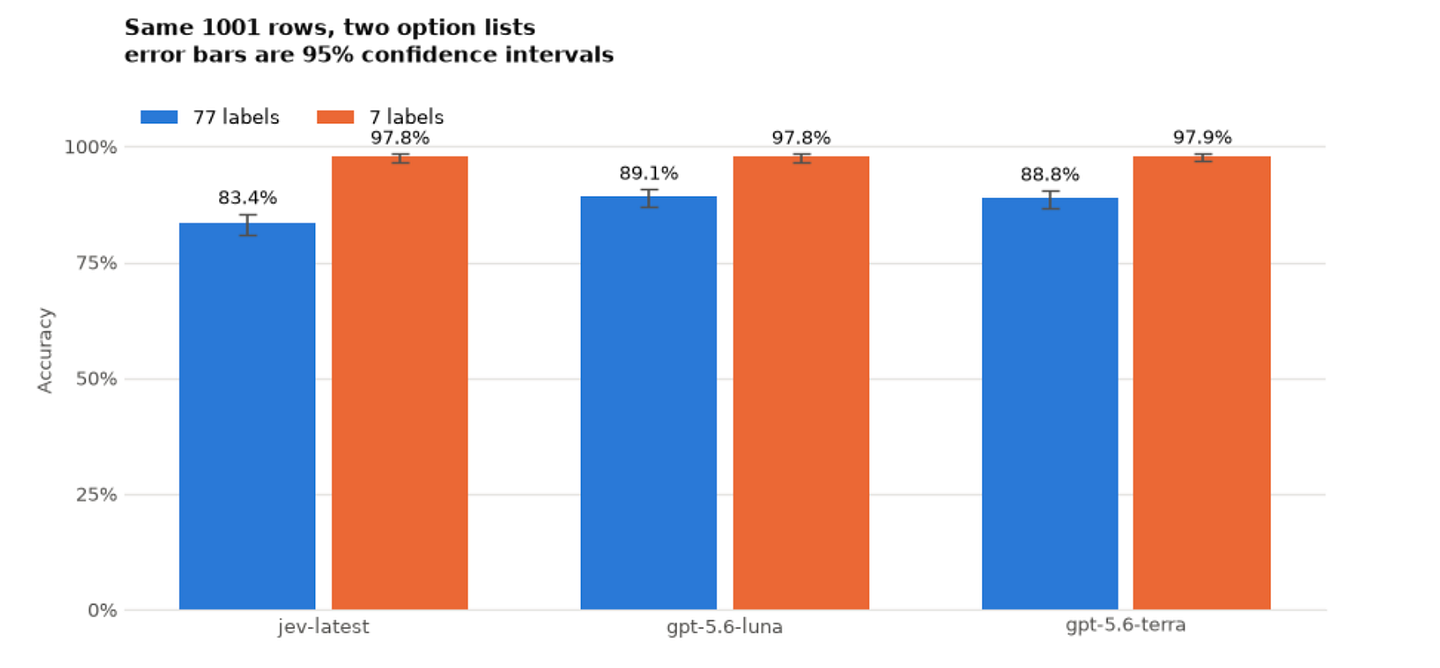
TypeSafe.AI宣称Jev相比LLM:
- 速度快 193.6 倍
- 成本低 444.6 倍
- 幻觉更少
虽然原文的对比实验部分未完整呈现,但这些数字如果成立,对高吞吐、低成本的生产场景极具吸引力。
适用场景
Jev特别适合以下任务:
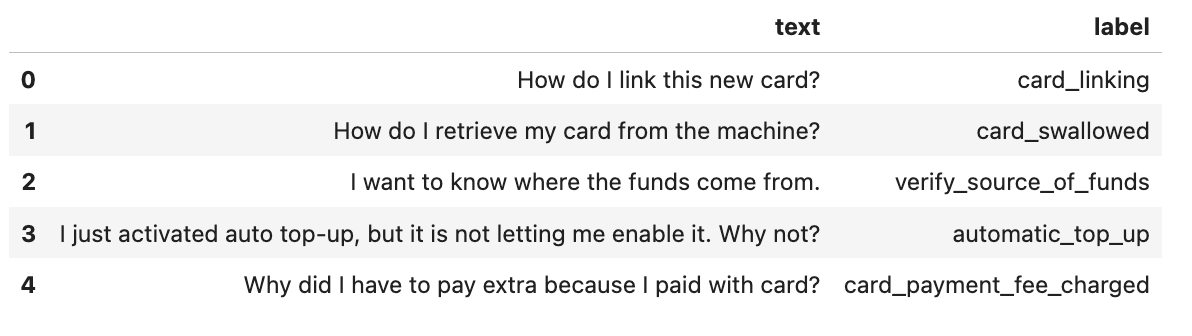
- 意图分类:客服请求归类(物流、账单、账户等)
- 情感分析:NPS评论、客户反馈打分
- LLM-as-a-judge:用模型评估另一个模型的输出质量
- 自动路由:根据置信度决定自动处理还是转人工
总结
Jev代表了一种务实的AI范式:不追求生成能力,而是专注于结构化决策和置信度评估。对于需要高速度、低成本、可解释概率的生产级分类任务,这类模型可能是比LLM更合适的选择。