构建经得起审计的 LLM 合规审查系统
面对误读:如何构建经得起审计的 LLM 合规审查系统
在反洗钱(AML)等监管工作中,一个残酷的真相是:不同类型的合规错误代价截然不同。误报可能只是浪费分析师一个下午的时间,但漏报违规行为却可能导致监管机构的严厉处罚。这种误差不对称性,是金融科技领域从传统自动化迈向 AI 驱动时的最大心理障碍。
作为拥有十年银行数据集成经验的从业者,我曾参与过从零构建 AI 驱动的 OCR 和 LLM 工作流。在将这些技术应用于合规审查时,我们发现许多团队虽然能做出漂亮的 Demo,却在生产环境中频频翻车。本文将结合实战经验,剖析 LLM 在合规审查中的隐形陷阱,并提供一套可落地的应对策略。
LLM 合规审查面临的三大核心挑战
1. 误差不对称性:整体准确率是最大的谎言
大多数团队在评估模型时,习惯关注整体准确率(例如 97%)。但在合规场景下,召回率才是生命线。
- 问题所在:一个 97% 准确率的系统,可能包含了 98% 的“简单通过”案例和 2% 的“复杂违规”案例。如果模型在这 2% 的关键违规上犯错,整体准确率依然很高,但合规风险却失控了。
- 实战解读:开发者必须针对每一条具体规则单独评估精确率和召回率。对于合规审查而言,**“宁可错杀一千,不可放过一个”**往往是必要的策略。
2. 决策的可解释性:审计师的灵魂拷问
在受监管行业,系统不仅要能做决定,还必须能解释决定。审计人员可以随时调取去年通过审查的任意一份文档,并质问:“为什么这个文档被放行了?”
- 要求:简单的“模型很自信”无法通过审计。系统必须具备可追溯性,能够展示模型决策所依赖的具体文本片段、系统版本号以及完整的推理链条。
- 实用建议:在模型输出中强制嵌入引用来源,确保每一个合规结论都有据可查。
3. 流程的“日历”问题:安全审查往往比开发更慢
工程师往往低估了合规流程的时间成本。在受监管公司,客户文档不能直接发送到任意端点,模型部署前的安全审查、日志处理和数据合规审查耗时可能远超原型开发时间。
- 风险:如果项目计划中没有预留足够的时间给这些流程,原型上线时往往会因为基础设施不合规而被迫返工。
原型阶段的常见陷阱
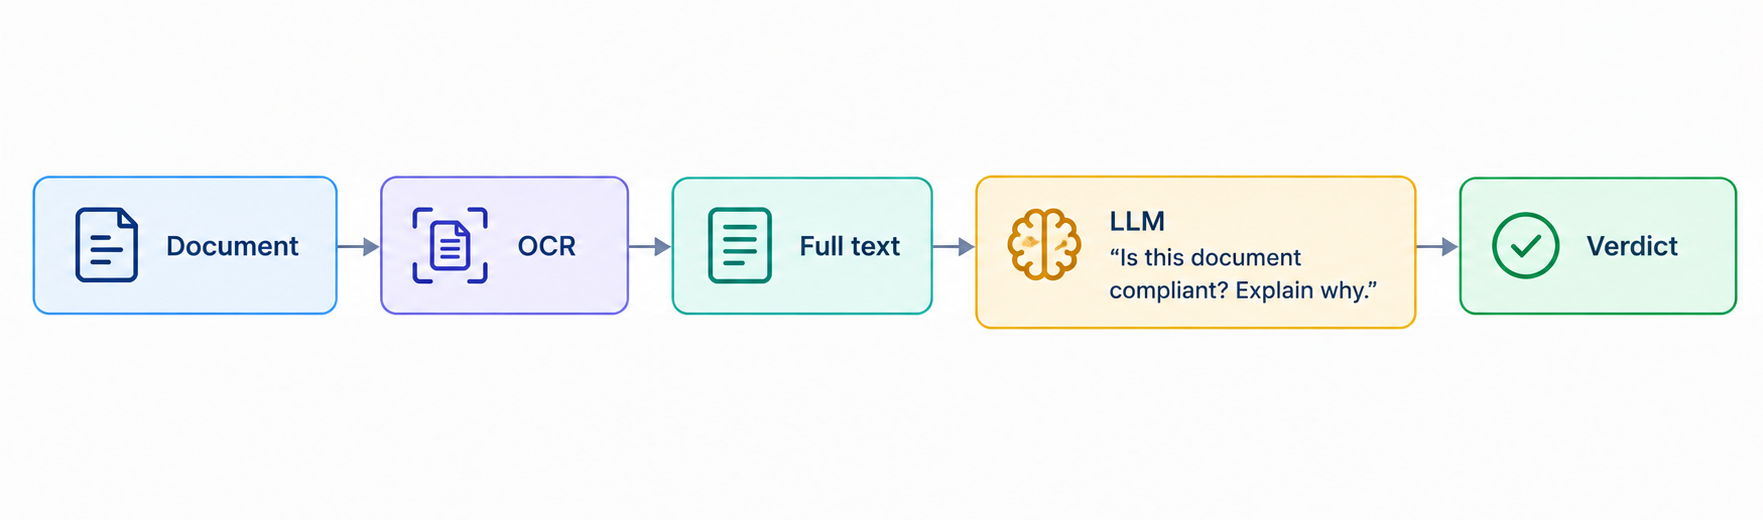
提取损失:OCR 错误如何误导模型
这是最隐蔽的陷阱。在 Demo 阶段,团队通常使用扫描质量极高的文档。但在生产环境中,合规文档往往充斥着印章、手写签名、页面倾斜、褪色打印和多栏布局。
- 现象:OCR 引擎通常不会报错,而是静默地“猜错”。例如,它可能把数字 1 识别成 7,或者合并了两列内容导致条款缺失。
- 后果:LLM 基于这些错误的文本进行推理。当它发现文档中缺少某个关键条款时,可能是因为 OCR 根本没读到,而不是因为文档真的缺失。如果下游系统没有质量信号反馈给 OCR,模型就会在错误的数据上继续犯错。
无法验证的推理
模型给出的理由往往听起来合乎逻辑,但审计人员难以验证其真实性。例如,模型可能给出一个模糊的结论,或者基于“广泛”的上下文而非文档中的具体细节做出判断。
实战指南:如何让模型经得起审计
为了解决上述问题,构建一个健壮的合规审查系统,建议遵循以下步骤:
启用“影子模式” 在部署上线前,必须让 LLM 系统与人类审查员并行运行。让模型先处理文档,人类对照检查。这能让你在真实数据上暴露模型对 OCR 错误的鲁棒性以及推理的准确性。
关注特定规则的召回率 不要只看总分。建立仪表盘,专门监控每一条高风险规则的召回率。如果发现某类文档(如扫描件)的召回率偏低,应立即针对该类数据进行专项优化。
将 OCR 质量作为输入特征 不要直接把 OCR 输出喂给 LLM。在输入中增加“置信度”或“质量评分”字段,帮助模型识别哪些文本可能是错误的,从而避免基于错误前提做出合规决策。
合规审查不仅是技术问题,更是风险管理问题。只有深刻理解了业务场景的残酷性,才能让 LLM 真正成为金融安全的守护者。


本文目录(8 节)
本文基于 Hacker Noon 的公开内容,由 AI 辅助整理改写后发布。
原标题:What Happens When the Model Reads It Wrong: Building LLM Compliance Review That Survives an Audit
阅读原文