GitHub 9月可用性报告:数据库与迁移
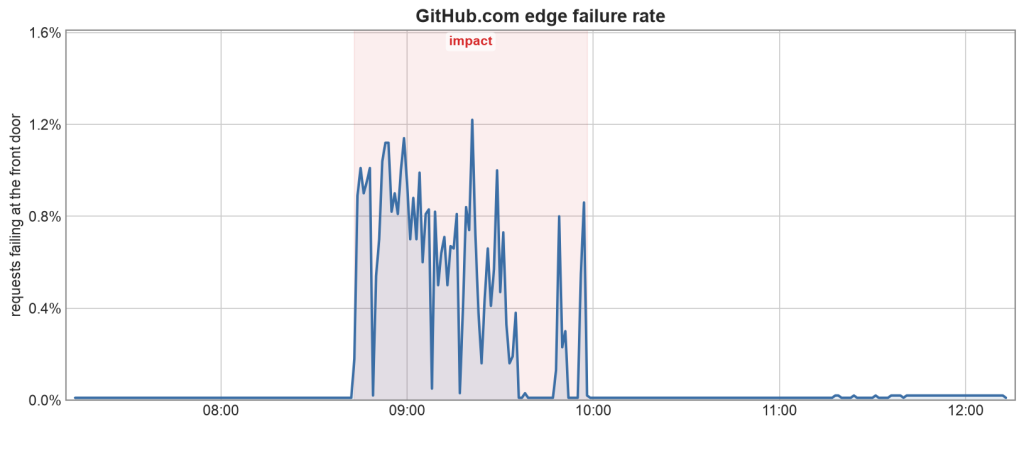
GitHub 发布了覆盖 8 月至 9 月的可用性报告。由于 9 月期间其他公开内容已对 8 月 17 日的故障进行了说明,本次报告重点展示了过去两个月的改进进展:减少共享数据库压力、增加过载控制、为 GitHub Actions 创造运行余量、扩大 PR 故障隔离范围,以及将更多生产工作负载迁移至 Azure。与此同时,重大事故、容量暂停和迁移目标未达成也表明工作尚未完成。
迁移进展与容量挑战
截至 10 月 7 日,GitHub 已将 120 个生产服务部署到美国中部(Central US)区域,占总数 160 个的 75%;51 个主 MySQL 数据库中已有 13 个完成迁移。在流量层面,Azure 现已处理 GitHub 核心应用 65.4% 的读取流量、48.3% 的 Git 读取流量,以及 80.2% 的流处理流量——这些指标针对不同工作负载,不应简单相加。
然而,迁移并非一帆风顺。由于各可用区容量不均,团队在 9 月 11 日暂停了中部区域的部署和流量增长,直到 9 月 18 日才恢复。原定于 9 月 30 日完成全部生产服务部署的目标未能达成,持久性的容量工作仍在继续,目标是在 10 月底前释放全部可用容量。
此外,在一次计划内的数据库故障切换中,一个自动化应急流程意外断开了中部区域的数据库副本,影响了该区域用户。团队已禁用该流程中的这一机制,并正在改进恢复能力。
数据库优化:从根源减负
在区域迁移之外,GitHub 对数据库进行了多项结构性优化:
- 认证核心表迁移:24 张认证核心表从 GitHub 最古老的共享数据库中移出,使其副本每秒减少约 100 万次查询。
- 编辑历史清理:支持 issue 和 PR 的数据库集群移除了约 9.8 亿条不必要的编辑历史记录,预计释放约 1.8 TB 可恢复存储空间。
- 死锁显著下降:每周死锁次数较 6 月峰值下降约 77%,持续清理机制可防止类似的无界增长再次出现。
故障隔离与过载控制
GitHub 在故障隔离方面也取得了进展。现在,约一半的采样 PR 流量在共享依赖故障时仍可继续运行,生产环境测试表明,在共享数据库事故期间,多个读操作依然可用。数据库流量路由还能在流量高峰时自动扩容——9 月 23 日 PR 活动激增期间,一个实例组从 14 个自动扩展至 19 个。
新的生产过载控制机制允许响应人员通过拒绝低优先级请求来保护高优先级的 API 和 Web 工作流,避免系统全面饱和。操作员文档和培训已完成。
GitHub Actions:缓存优化成效显著
GitHub Actions 也获得了更多的运行余量。生产变更将 Redis 操作量减少了约 28%,相对 CPU 使用率降低约 30%。独立的基础设施缓存进一步将 Redis 带宽消耗降低 84%,平均响应时间缩短 66%,主库存请求的中位响应时间缩短 96%,排队请求减少 95%。
9 月 13 日事故复盘
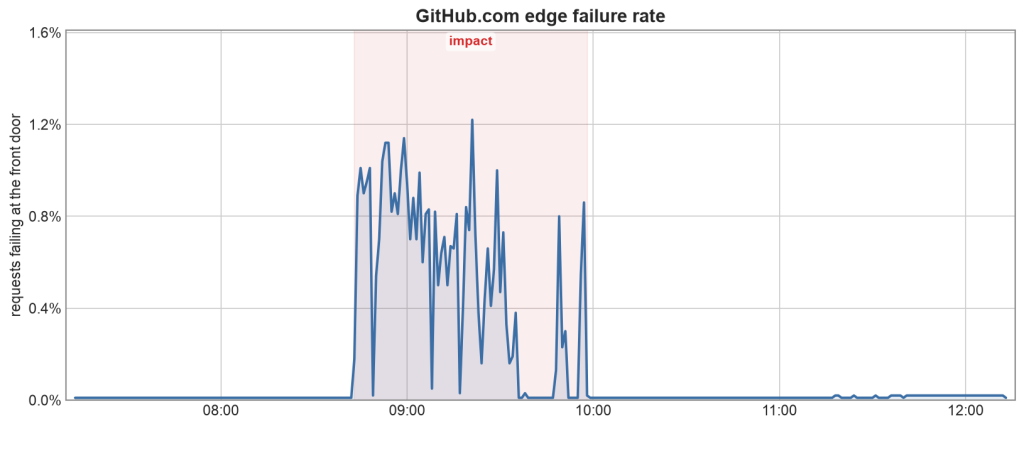
9 月 13 日 09:16 UTC 起,GitHub 经历了一次持续 1 小时 28 分钟的事故。起因是一个后台数据清理任务增加了共享数据库的负载。该任务本应通过保护机制在副本落后时自动减慢写入,但这一机制未能考虑主数据库服务器上的传入负载。结果,任务持续运行,直到主数据库达到连接数上限。连接耗尽后,依赖该数据库的请求无法可靠完成。
数据库调用缺乏快速超时是加剧影响的重要因素——请求处理器在数据库停滞时只能等待,无法及时释放资源。团队正在改进相关机制。
总结:可用性优先
8 月 6 日的 Actions 事故、8 月 17 日的 github.com 事故、9 月的故障切换干扰以及有控制的容量暂停,都在提醒我们:只有当改进能在真实条件下降低客户风险时,量化指标才有意义。GitHub 的原则始终不变——可用性优先,容量其次,功能再次。