FlagOS 2.2:打通模型迭代与多芯算力的“任督二脉”
1来源:InfoQ 中文
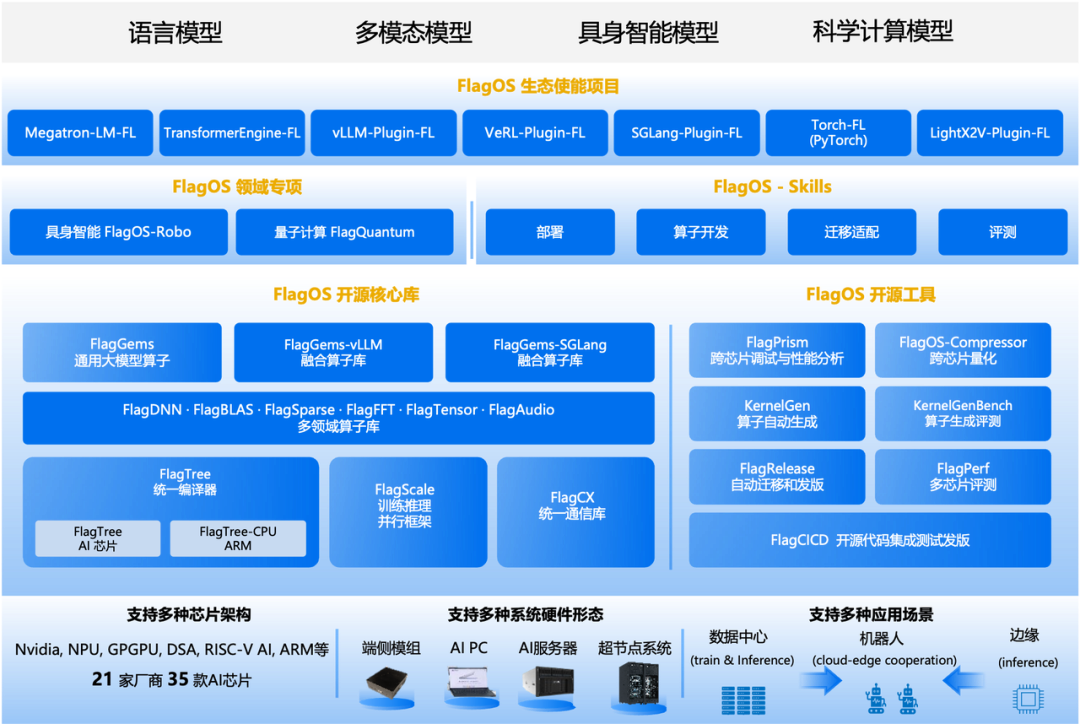
在 AI 领域,模型更新换代的速度极快(如 GPT-4 级别模型),而算力基础设施往往需要长期服役。这种“模型快、硬件慢”的剪刀差,给工程实践带来了巨大挑战。智源众智发布的 FlagOS 2.2,旨在通过软件栈的深度优化,让算力基础设施能够持续支撑每一代新模型,其核心价值在于从“支持哪些芯片”转向“能否持续优化每一种算力”。
算子库大扩容:从“能用”到“好用”的跨越
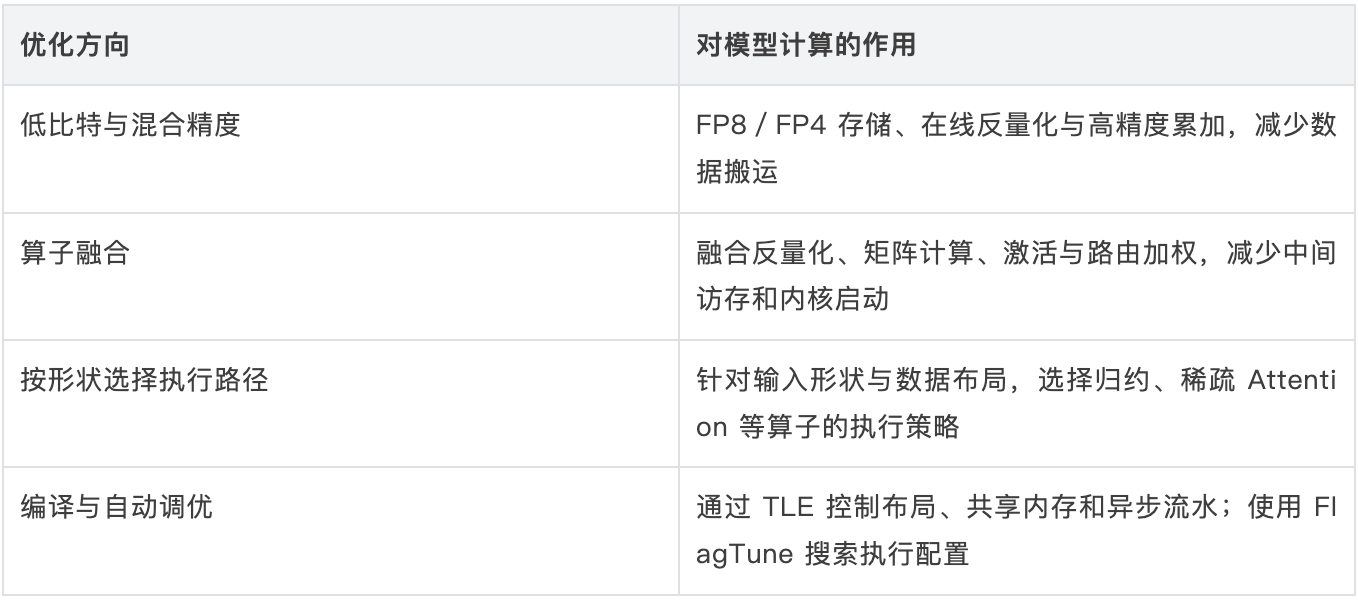
FlagOS 2.2 的底层基石是算子库的全面升级。传统的跨平台开发不仅代码量大,而且难以保证性能。
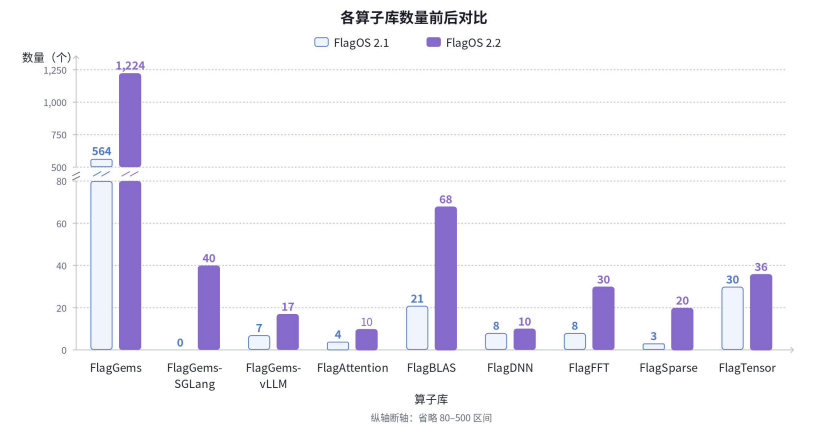
- 算子库规模突破: 新版本中,FlagGems 等公开算子库由 564 个激增至 1454 个,新增 890 个。这意味着覆盖了更广泛的线性代数、归约、训练反向接口以及推理专用算子(如 Attention、Mamba 等)。
- 自动化工具链加持: 为了解决人工调优的瓶颈,FlagOS 引入了 KernelGen 自动算子生成工具和 FlagPrism 跨芯统一调试工具。
- KernelGen:支持九款 AI 芯片,将代码生成、验证和调优自动化,显著降低了开发门槛。
- FlagPrism:将编译器信息与硬件执行关联,开发者无需深入底层,即可调试数值问题并定位性能瓶颈。
对开发者的价值: 这套工具链让算子开发从“专家手工优化”走向“规模化生产”。开发者可以更专注于算法创新,而将繁琐的底层适配工作交给工具链。
Day0 交付:新模型一天内适配多款芯片
新模型发布时,如何在多种芯片上快速部署是最大的痛点。FlagOS 2.2 提供了一套“即插即用”的解决方案。
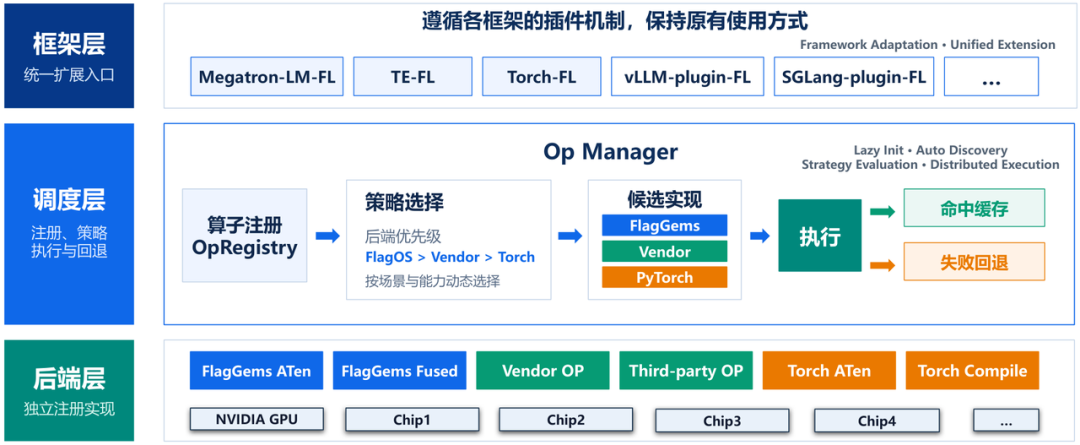
- 统一插件系统: FlagOS 提供了类似“插座”的插件接口,能无缝接入 vLLM、SGLang、Megatron-LM 等主流框架。开发者只需调用标准算子接口,系统会自动选择最优实现路径,无需修改核心代码。
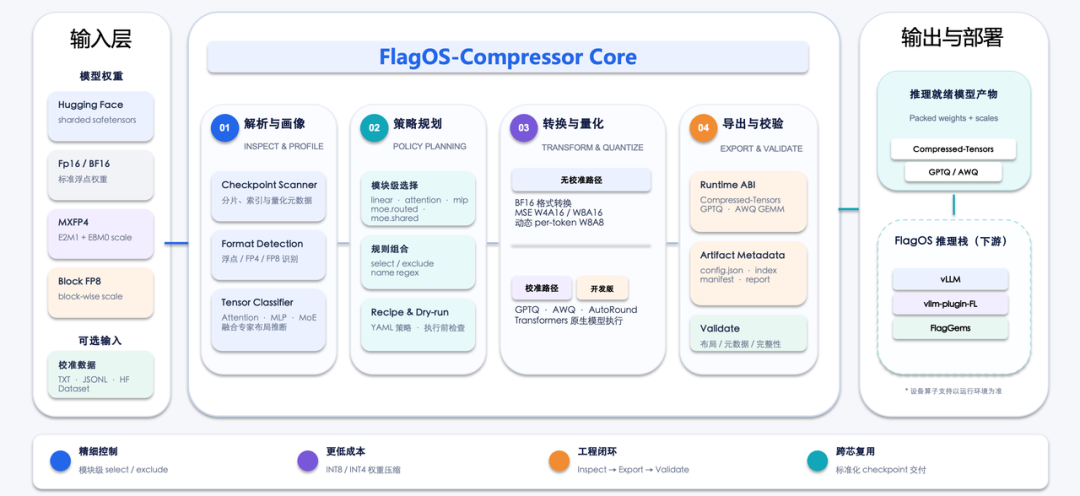
- 智能量化工具: 针对显存或低精度支持不足的硬件,FlagOS-Compressor 提供了一键转换和量化能力,例如将 Qwen3.5 模型从 FP16 压缩至 W8A8,显存占用减少近一半,同时保持精度。
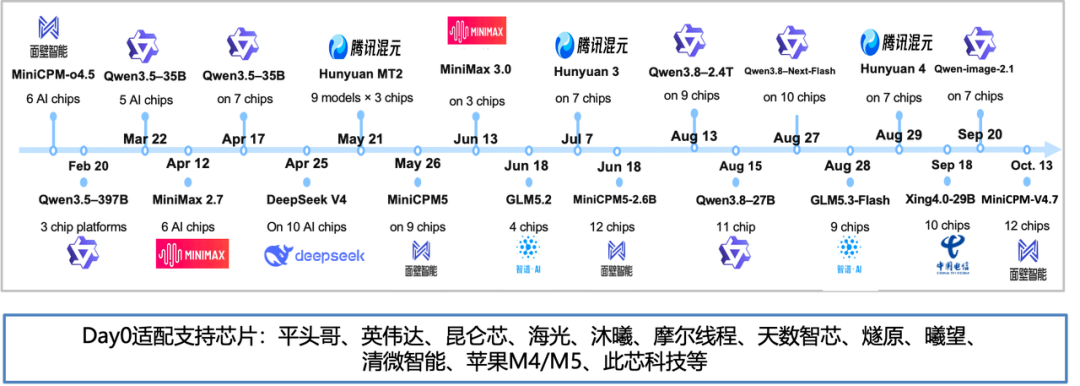
实战案例: 中国电信的“星辰”大模型在适配中,仅用一天时间就完成了 10 款芯片的部署,并通过 FlagGems 替换原生算子,实现了首 Token 时延降低近 20% 和解码速度提升 26% 的成绩。
生产环境优化:算力成本与效率的双重提升
除了部署速度,FlagOS 2.2 更关注模型上线后的实际运行效果。
- DeepSeek V4.1 Flash 优化: 在平头哥 810E 芯片上,通过跨平台优化,解码速度相比原生路径提升了 83.1% 以上,显著缩小了与英伟达 H100 的性能差距。
- GLM-5.3-Flash 成本优势: 在存量昇腾 910B 算力上,逻辑服务吞吐量翻倍。根据场景测算,其算力成本较商业 API 参考价格降低了 19.4% 到 27.6%。
总结: FlagOS 2.2 通过算子级、模型级和系统级的协同优化,为 AI 开发者和企业提供了一个强大的“软硬适配”平台。它不仅解决了“能不能跑”的问题,更解决了“跑得快不快、贵不贵”的问题,是国产算力生态中极具参考价值的工程实践。