当直线不够用:鲁棒曲线回归的实战技巧
当直线不够用:鲁棒曲线回归的实战技巧
线性回归模型因其简单、快速且易于解释,长期以来一直是数据科学领域的首选工具。然而,现实世界的数据往往并不“听话”。在处理刹车距离、作物产量、风力涡轮机功率等场景时,变量之间的关系并非总是直来直去,而是呈现出弯曲、平坦或分段变化的特性。
如果在这些非线性关系中强行使用直线拟合,不仅会降低模型的预测精度,还可能掩盖真实的数据规律。本文将探讨如何在模型中加入灵活性以适应曲线,同时保持对噪声数据的鲁棒性。
从直线到曲线:模型的进阶之路
从数学角度看,从直线扩展到曲线主要面临两个核心挑战:信任与形状。
- 信任问题:在存在噪声的情况下,模型应该信任哪些观测值?这是通过鲁棒估计器(如 Huber 回归、RANSAC 等)来解决的,它们能自动剔除或降低异常值的影响。
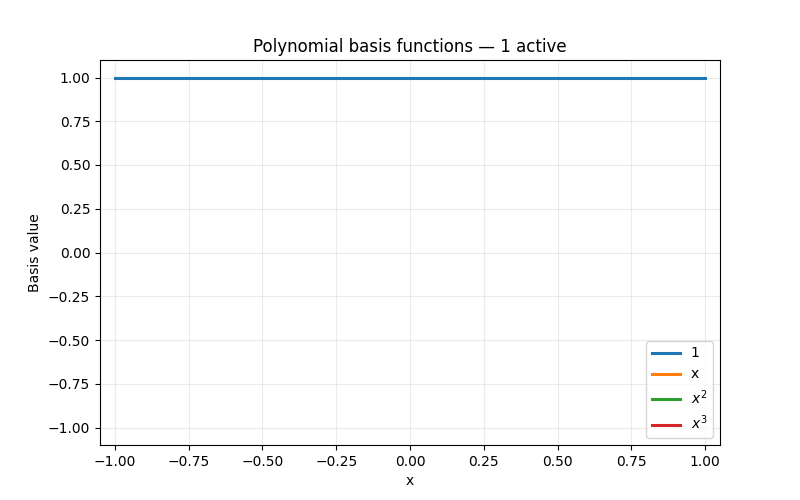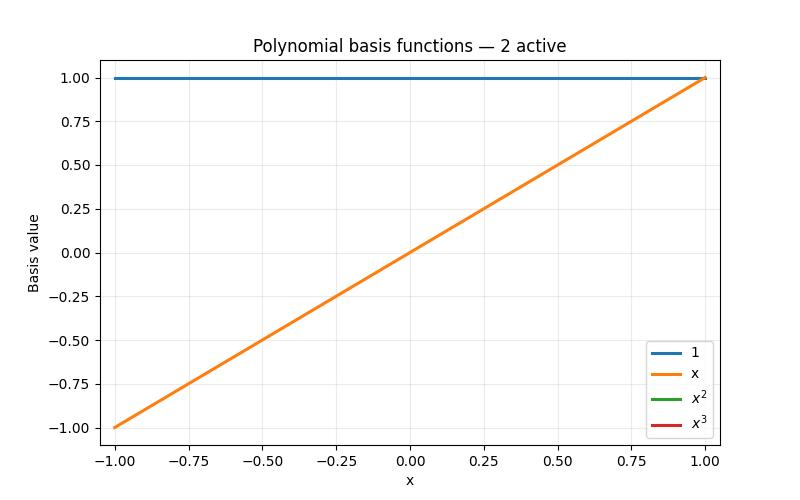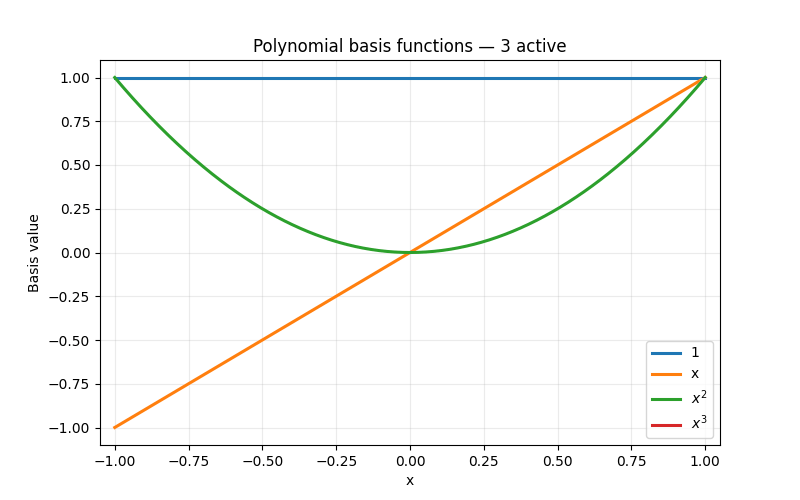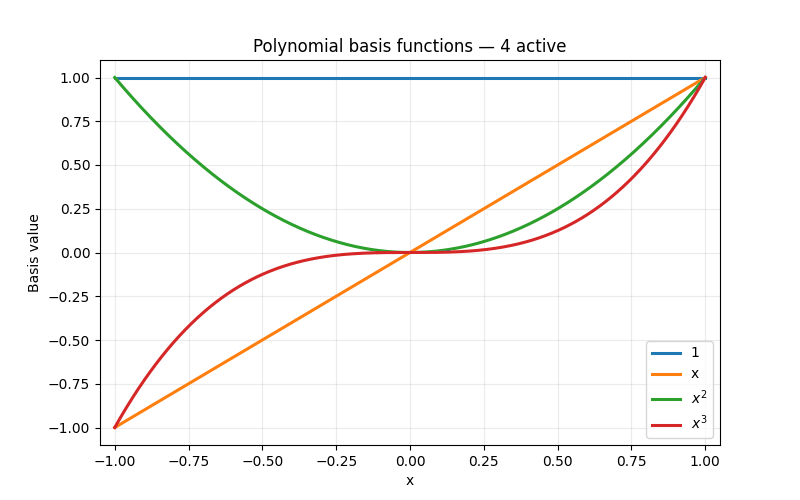
- 形状问题:模型需要具备多大的灵活性才能描述真实的关系?这通常通过引入基函数来实现,如多项式特征。
视觉化理解:干净数据 vs. 噪声数据
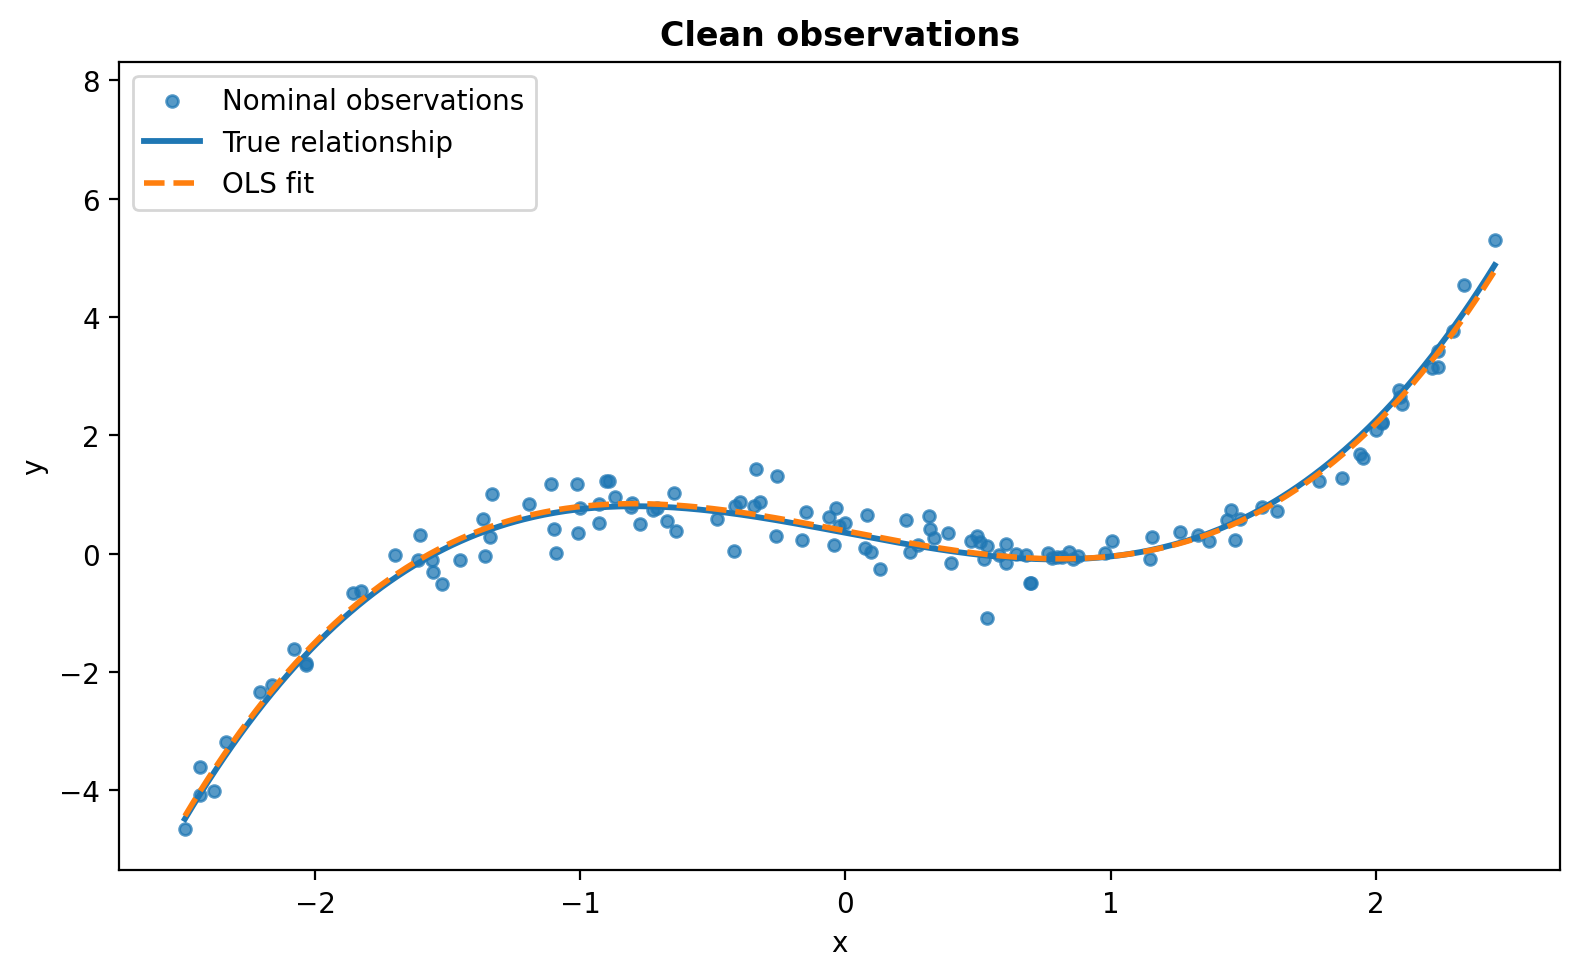
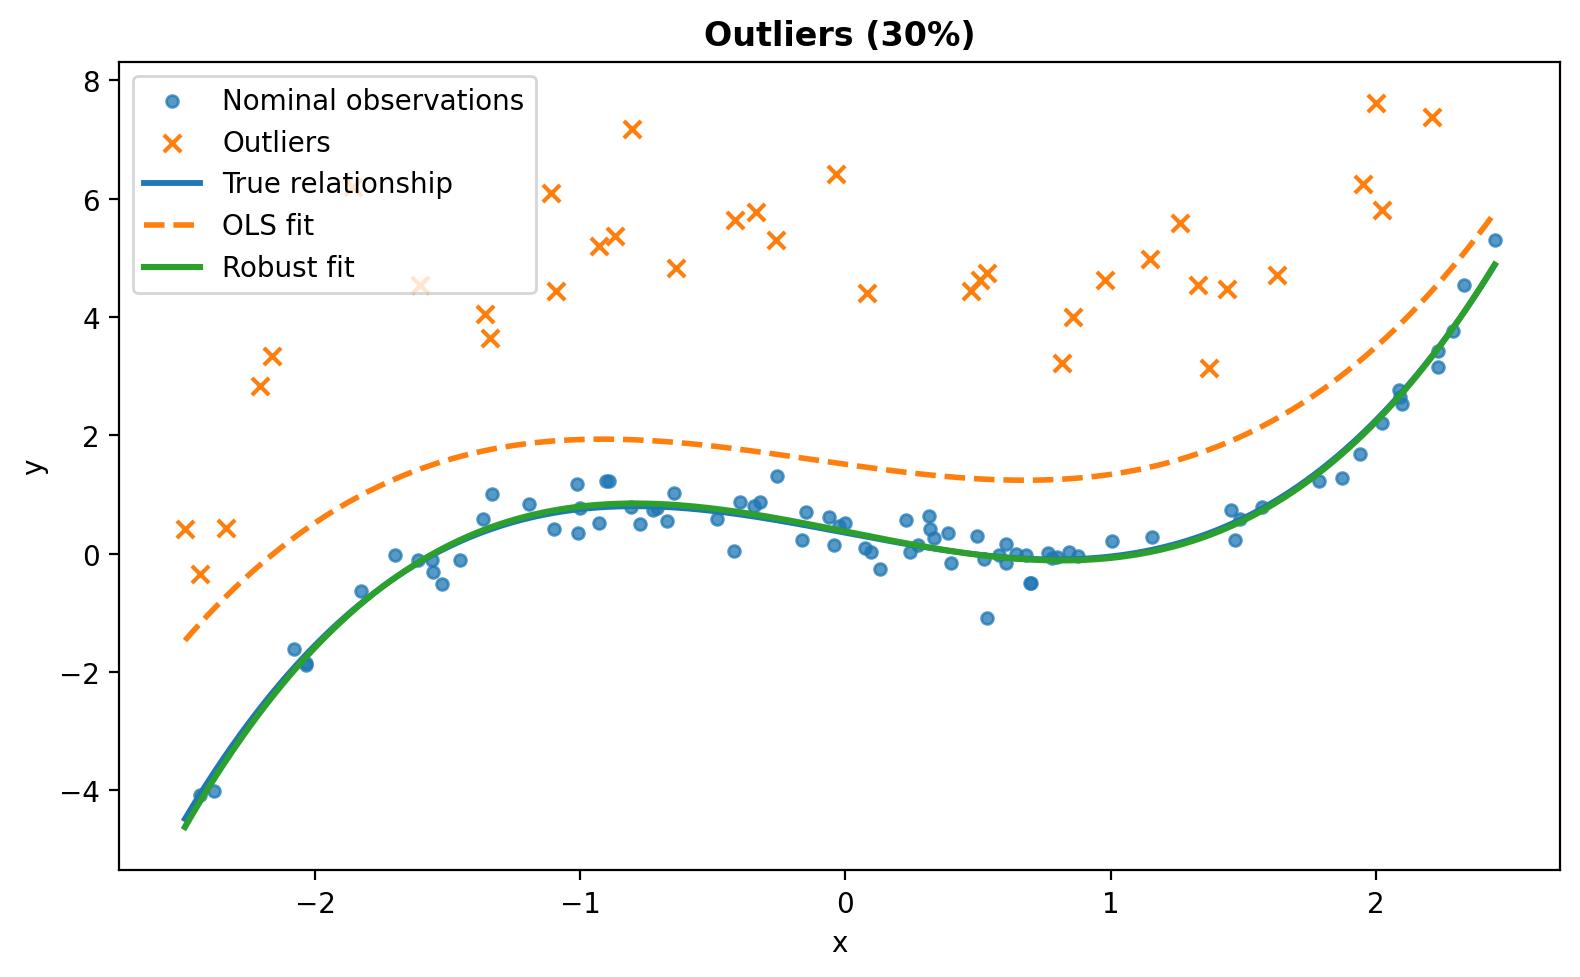
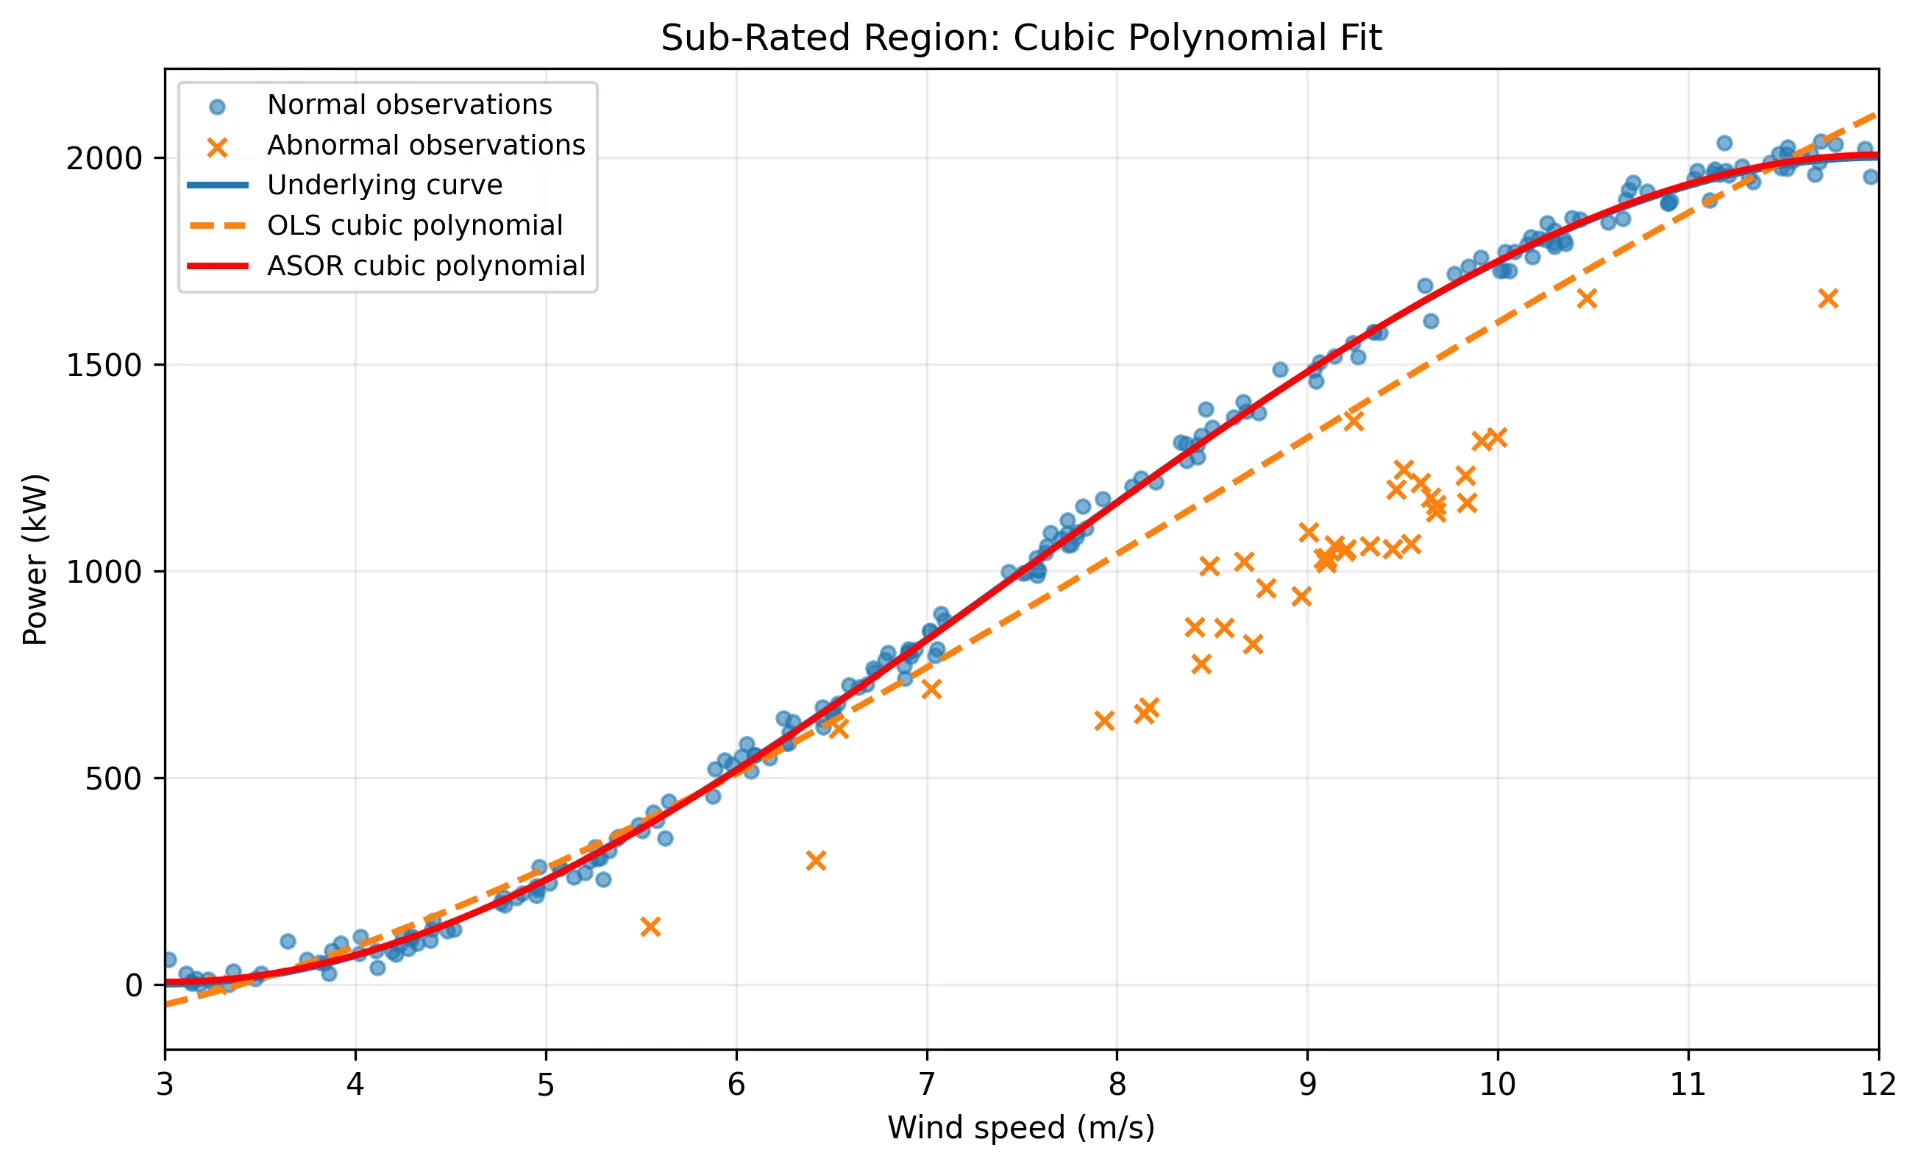
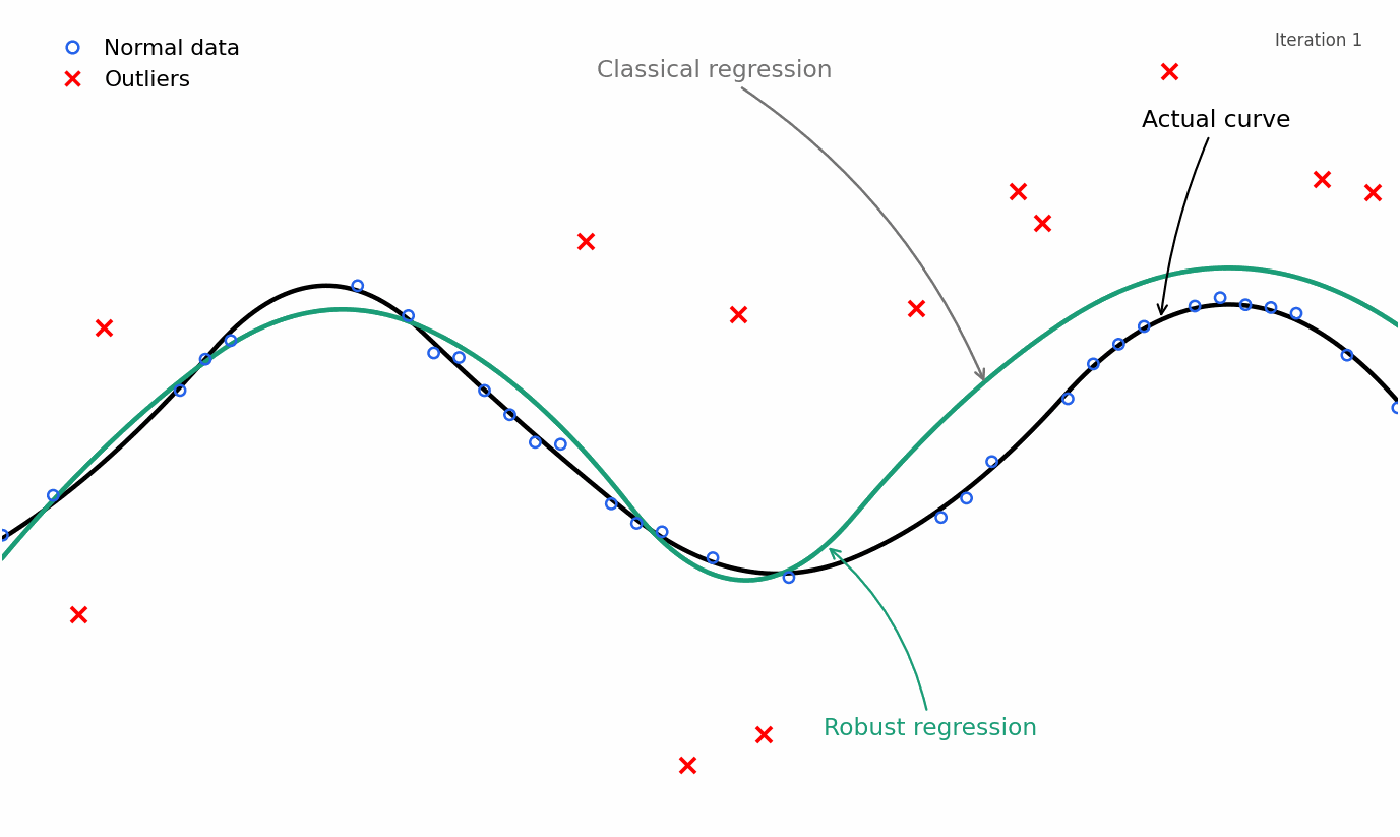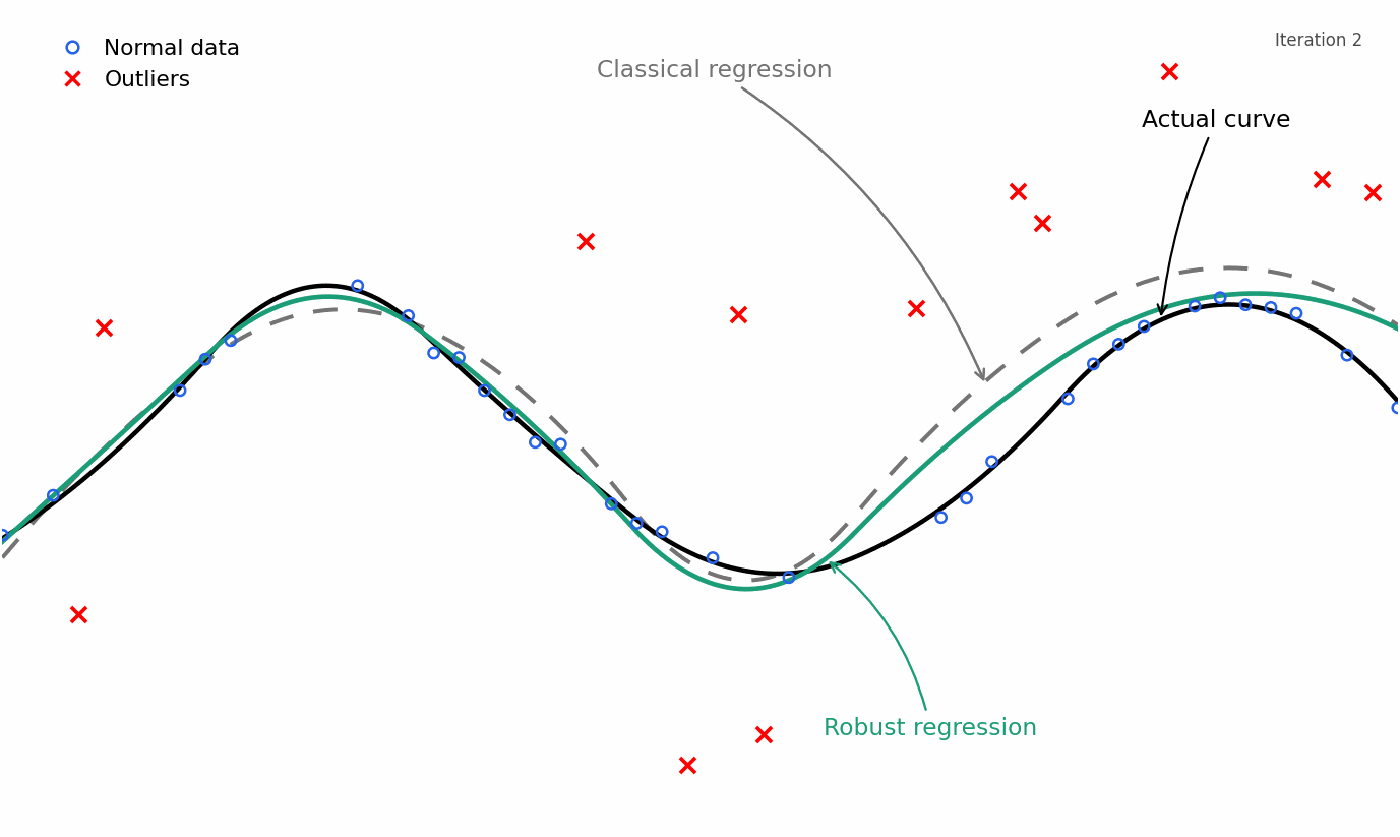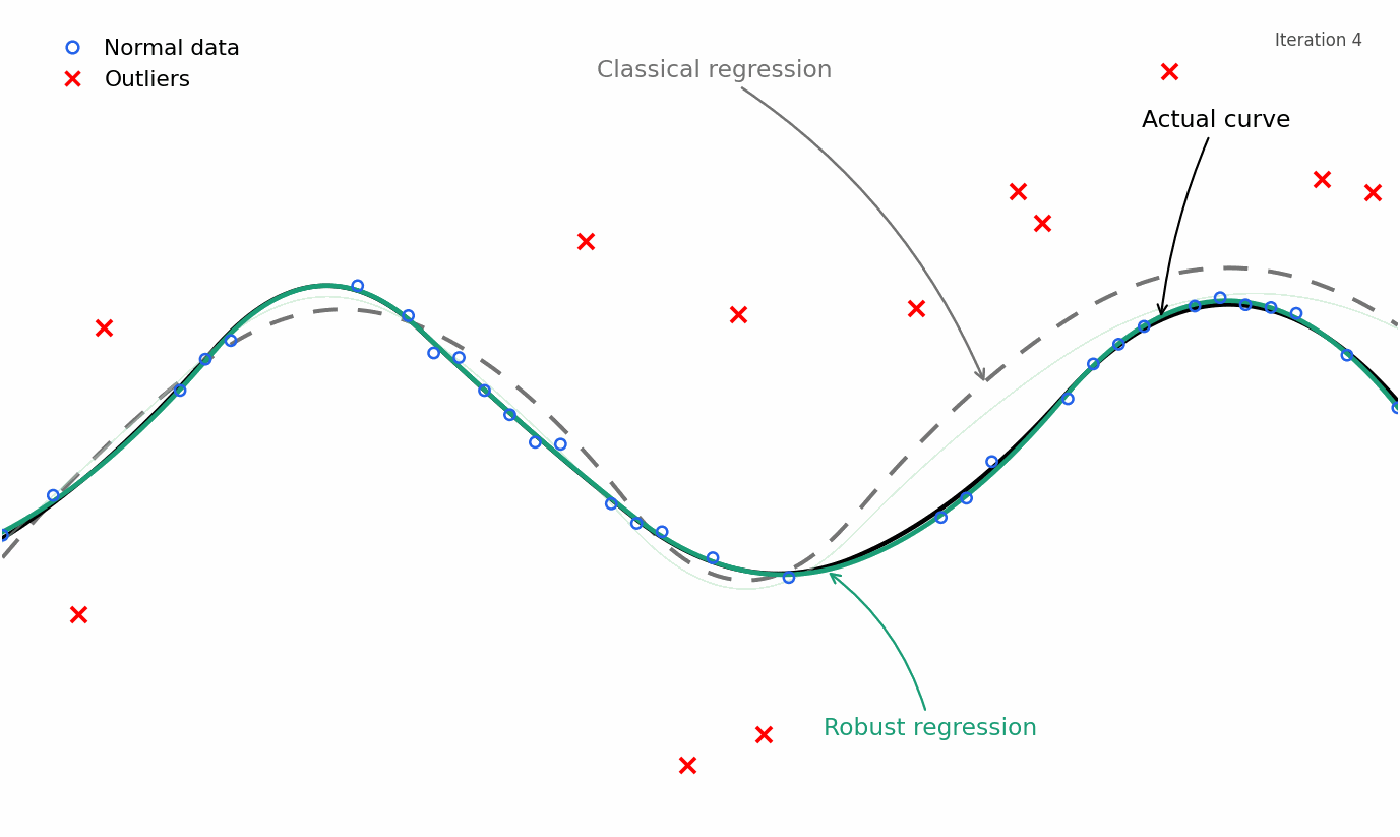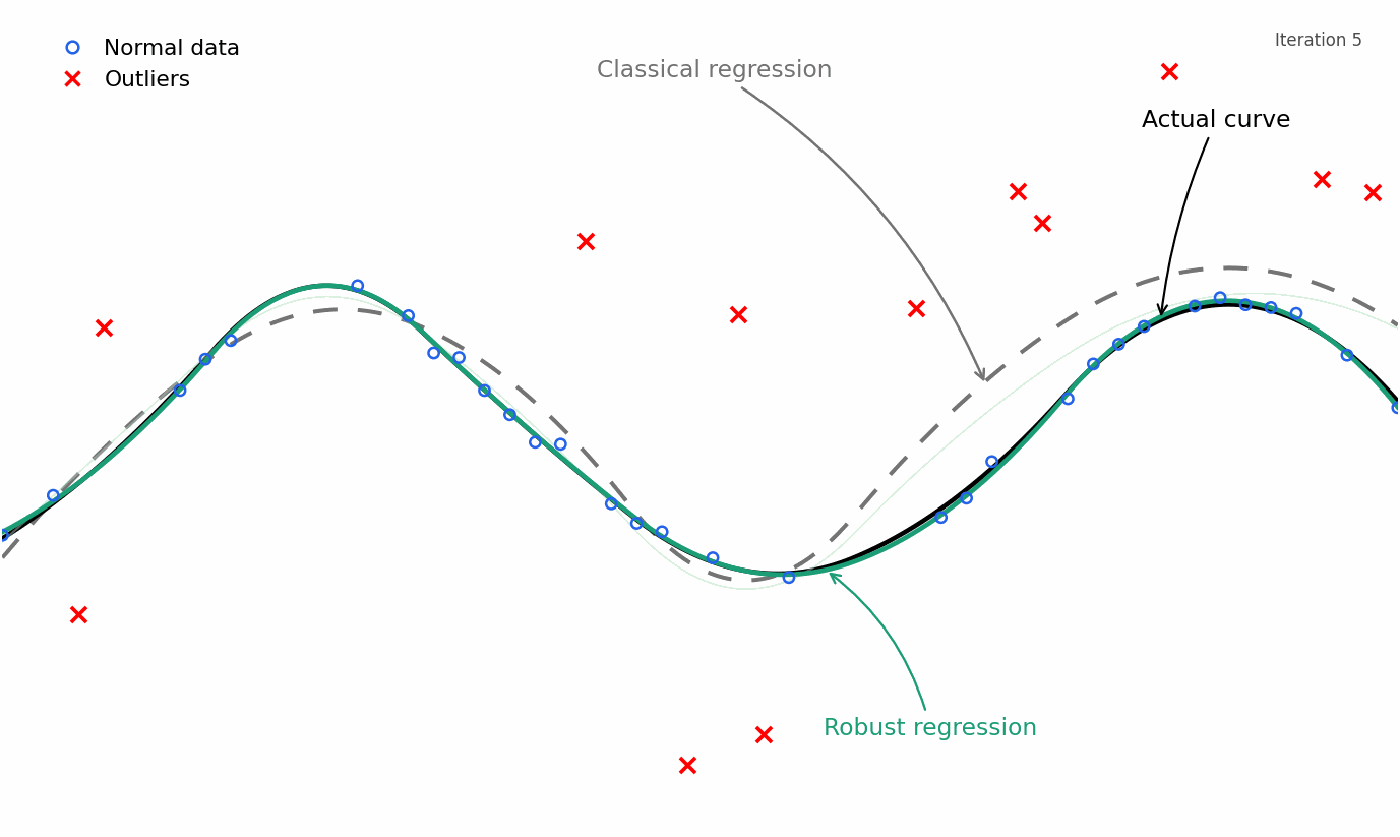
让我们通过一个直观的例子来理解这两种方法的区别。假设我们有一个真实的非线性关系,但数据中混入了 30% 的噪声。
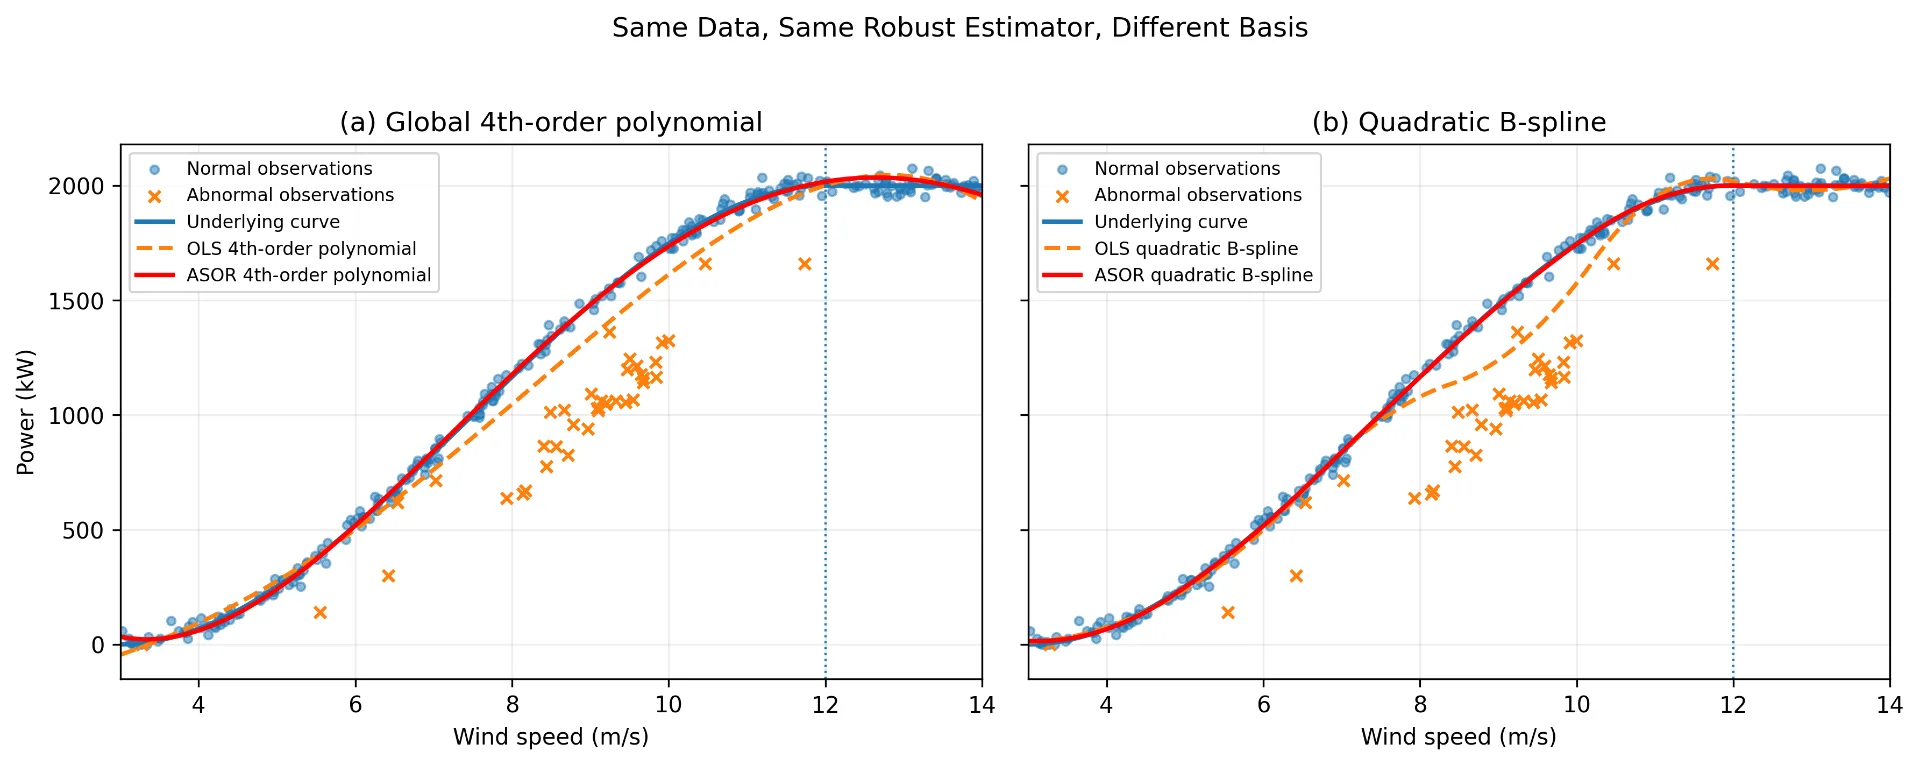
- 普通 OLS(最小二乘法):在没有噪声时,OLS 能完美贴合真实曲线。但在混入 30% 噪声后,OLS 的拟合线会被异常值显著拉偏,导致预测失效。
- 鲁棒估计器:即使在数据严重污染的情况下,鲁棒算法依然能保持拟合线接近真实的非线性关系。
对于开发者而言,这意味着在构建模型前,必须评估数据的污染程度。如果数据质量不高,直接使用标准线性回归可能会导致严重的偏差。
多项式回归:线性模型的视角
解决“形状问题”最常用的方法之一是多项式回归。很多人误以为多项式回归属于“非线性模型”,但实际上,从参数估计的角度看,它依然属于线性模型。
数学原理
考虑一个简单的二次模型: $$y_i = \beta_0 + \beta_1 x_i + \beta_2 x_i^2 + \epsilon_i$$
虽然 $y$ 与 $x$ 呈现非线性关系,但 $y$ 关于未知参数 $\beta$ 仍然是线性的。这允许我们沿用线性代数的强大工具来求解参数。
在矩阵形式下,这可以表示为: $$\mathbf{y} = \boldsymbol{\Phi}\boldsymbol{\beta} + \boldsymbol{\epsilon}$$
其中:
- $\mathbf{y}$ 是观测向量。
- $\boldsymbol{\beta}$ 是包含所有系数($\beta_0, \beta_1, \beta_2$)的参数向量。
- $\boldsymbol{\Phi}$ (Phi) 是设计矩阵,它包含了原始特征 $x$ 及其变换特征($x^2$ 等)。
- $\epsilon$ 是误差项。
通过构建这个矩阵,我们实际上是在一个高维的特征空间中寻找最佳的超平面。标准的最小二乘解法(OLS)仍然是求解 $\beta$ 的有效手段: $$\widehat{\boldsymbol{\beta}} = \arg\min_{\boldsymbol{\beta}} | \mathbf{y} - \boldsymbol{\Phi}\boldsymbol{\beta} |_2^2$$
实战建议:开发者如何操作
理解了原理后,开发者在实际项目中应如何应用这些知识?
- 特征工程是关键:不要害怕在数据预处理阶段引入 $x^2, x^3$ 或对数变换。这能将复杂的非线性问题转化为线性问题,极大简化求解过程。
- 警惕过拟合:虽然多项式能弯曲曲线,但过高的阶数会导致模型在训练集上表现完美,却在测试集上表现糟糕。务必使用交叉验证来控制模型复杂度。
- 结合鲁棒性:在工业数据中,异常值往往难以避免。在拟合多项式曲线时,建议结合 Huber Loss 或 RANSAC 等鲁棒算法,确保模型不会因为个别坏点而发生剧烈扭曲。
总结来说,不要让杂乱的数据弯曲你的曲线。通过引入多项式特征增加模型的表达能力,同时利用鲁棒估计器过滤噪声,你就能在复杂的现实世界中构建出既准确又可靠的预测模型。