从零构建 AI 文本检测器:原理、训练与应用实战
从零构建 AI 文本检测器:原理、训练与应用实战
在 AI 生成内容日益泛滥的今天,如何区分人类创作与机器生成已成为开发者与内容创作者关注的焦点。近期,Substack 平台在其 UI 中集成了 AI 检测功能,引发了广泛关注。与此同时,许多开发者也在寻求有趣的本地 LLM 项目,以展示小语言模型(SLM)的潜力。
为了满足这一需求,我们决定将这两者结合,从零开始构建一个端到端的 AI 文本检测器。这不仅是一个技术演示,更是一个关于如何构建“验证器”型 LLM 应用的绝佳案例研究。
项目背景与应用场景
为什么现在要做检测器?
AI 检测器不仅仅是为了“抓出” AI 写的内容,它在实际内容管理中有着广泛的用途,例如过滤垃圾信息。但对于普通用户而言,它还有更深层的价值——辅助写作优化。
举个例子,当你撰写一篇长文时,可能希望利用工具修复拼写和语法错误,以提高可读性。虽然像 ChatGPT 这样的通用 LLM 很好用,但它们生成的修改往往会让文章变得过于“完美”,从而失去人类的独特语气,甚至被误判为 AI 内容而被标记为垃圾信息。
通过构建一个检测器,我们可以设定一个目标:“修复语法的同时,保持文本 0% 的 AI 生成概率”。这种思路将检测器从一个简单的过滤器,转变为写作过程中的智能顾问。
技术实现:基于概率的分类模型
在技术层面,我们借鉴了类似 Pangram 模型的思路,这也是目前许多主流检测服务背后的逻辑。
核心原理
不同于复杂的规则匹配,我们的目标是构建一个基于概率的分类器。该模型将返回一个 0-100 的分数,表示文本是“AI 生成”的概率。虽然这个分数并非绝对的真理,但它反映了模型在训练分布下对文本特征的学习结果。
模型选择
为了在保持精度的同时兼顾推理效率,我们将对轻量级的 DistilBERT 模型进行微调。这种模型结构非常适合部署在本地,既满足了开发者对隐私和数据安全的需求,又能提供实时、快速的检测结果。
局限性与挑战:猫鼠游戏
在深入项目之前,必须清醒地认识到 AI 检测器的本质:它是一场猫鼠游戏。
- 模式识别与对抗:检测器通过学习 AI 生成的特定模式来识别内容。然而,随着模型迭代,新的 AI 生成器可能会刻意避开这些模式,导致检测器失效。反之,检测器更新后又能再次捕捉到这些模式。这是一个动态的博弈过程。
- 误报问题:任何基于统计模型的检测器都不可避免地会遇到误报,即把人类写的真实内容错误地标记为 AI 生成。在实际应用中,我们需要权衡灵敏度与特异度。
项目目标与成果
本项目的最终产出将包括两部分:
- 后端 API:一个功能完备的检测接口,可供人类用户或智能体调用,返回整段文本的 AI 评分。
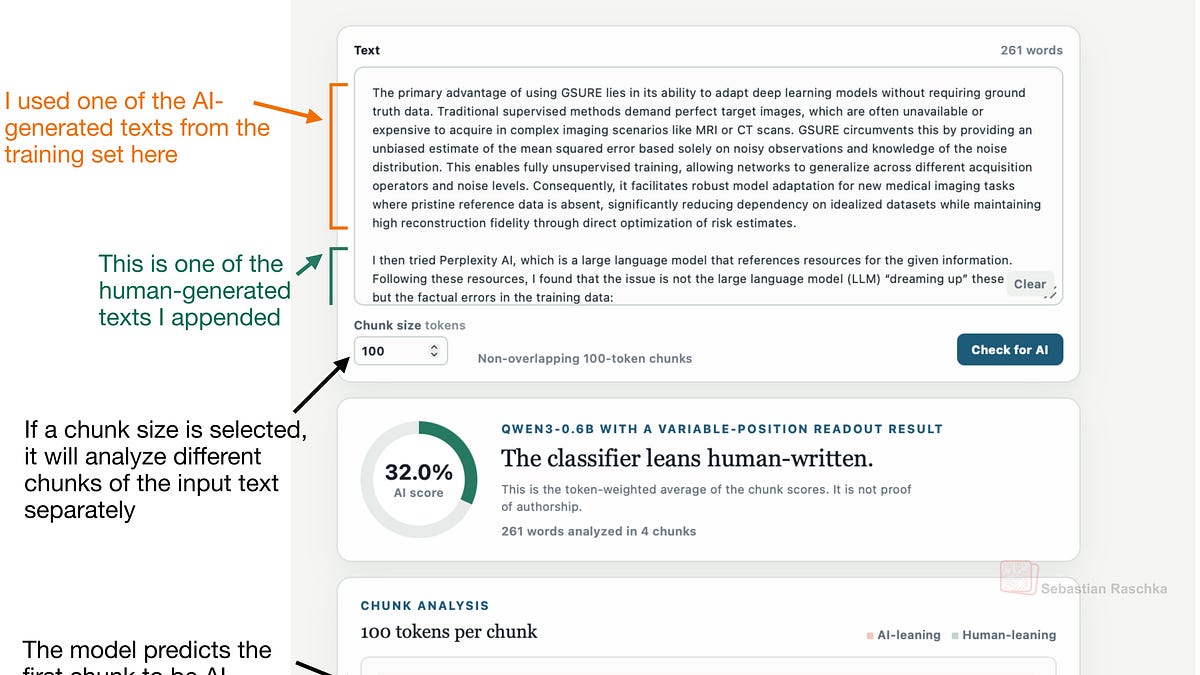
- 用户界面 (UI):一个基于浏览器的本地界面,不仅显示整体评分,还能高亮显示文本中不同片段的 AI 检测分数,帮助用户直观地了解哪里可能被标记。
通过这个项目,我们将深入理解 AI 检测背后的原理,并掌握如何构建一个可用的本地验证器,为未来的 LLM 应用开发提供新的思路。