Agent如何读懂企业数据?腾讯云TDSQL Nexa给出新解
1来源:InfoQ 中文
Agent如何读懂企业数据?腾讯云TDSQL Nexa给出新解
如果说2025年是Agent元年,那么2026年无疑是Agent大规模落地的爆发期。当Agent从辅助工具变为直接的数据使用者,传统数据库架构正面临前所未有的挑战:如何让Agent不仅“找得到”数据,还能“懂”数据背后的业务含义?
腾讯云推出的 AI原生多模数据库 TDSQL Nexa Lakebase,正是为了解决这一痛点。它通过整合多引擎协同、AI计算能力以及企业语义管理,试图构建一套全新的数据底座。
1. Agent时代的数据痛点:找得到 vs 读得懂
在引入Agent之前,企业数据主要服务于人和业务系统,查询逻辑由开发者预设。如今,Agent直接介入,暴露出了两个核心问题:
- 数据孤岛加剧: Agent往往需要跨系统查询。订单数据可能在关系型数据库,而文档和图片在对象存储。如果缺乏统一架构,Agent需要处理大量繁琐的数据同步和结果拼接工作。
- 语义鸿沟明显: 数据库表名和字段名只能描述结构,无法表达业务规则。例如,多个名为“收入”的字段对应不同的业务口径。Agent仅凭字段名很难判断该用哪一个,导致查询结果偏差。
2. TDSQL Nexa 的核心解法
为了解决上述问题,TDSQL Nexa 从架构层面进行了深度重构,主要包含三个关键能力。
多引擎协同:减少数据搬运,统一访问入口
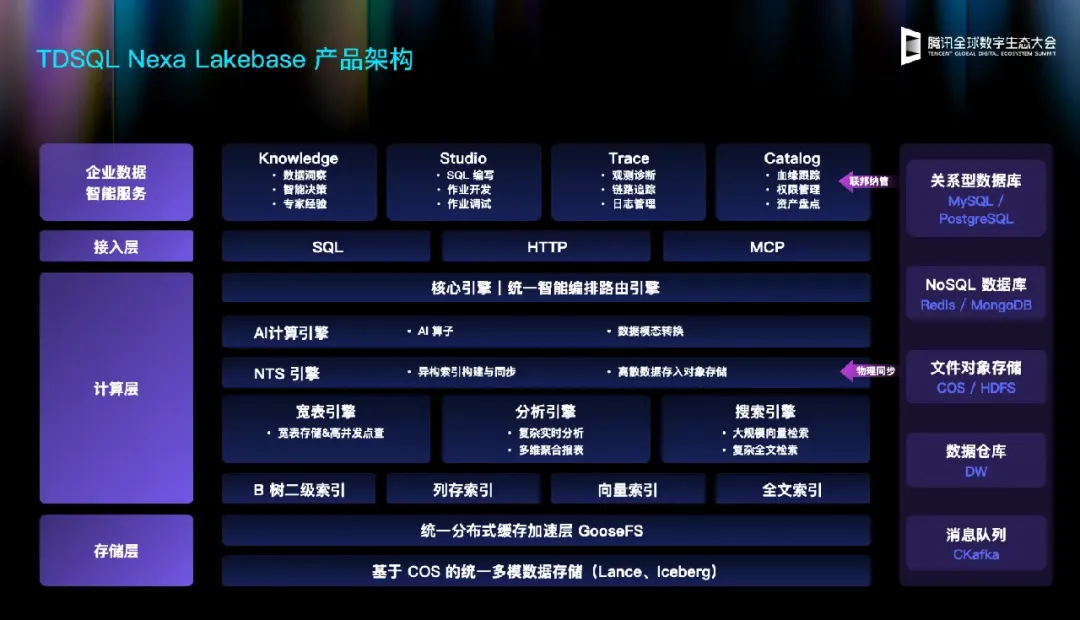
TDSQL Nexa 采用“计算引擎”与“存储引擎”分离的架构,通过 NTS(网络传输服务) 作为核心连接器,将不同引擎的能力融合。
- 统一底座与加速: 以对象存储(COS)为基础,结合 Iceberg、Lance 等开放表格式承载海量数据,利用 GooseFS 提供分布式缓存,提升湖上数据访问效率。
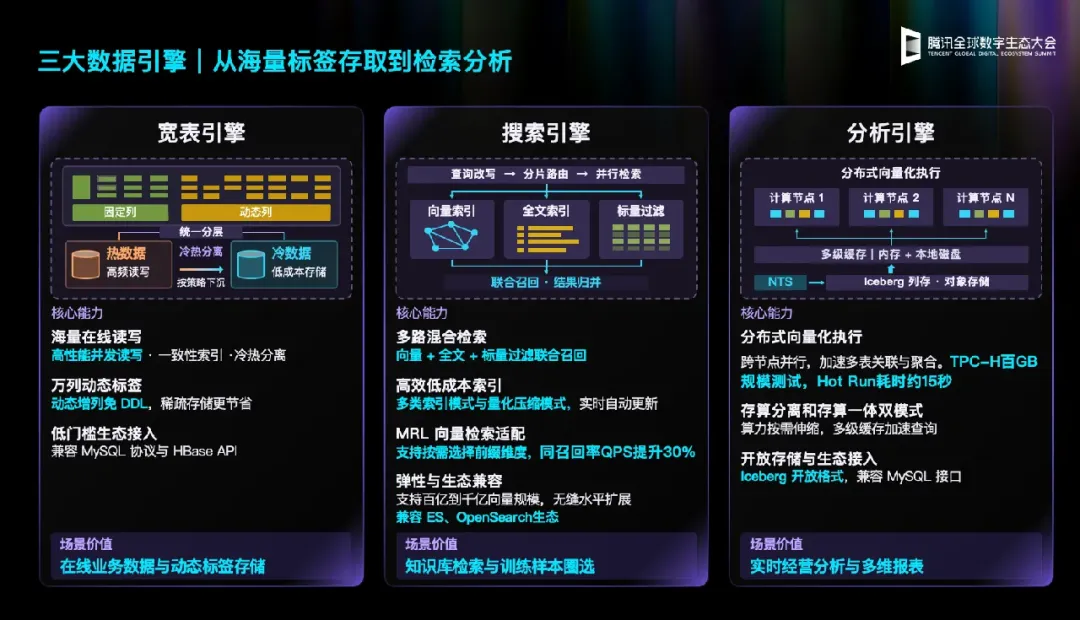
- 多引擎分工协作: 系统内置了多种引擎以应对不同需求:
- 宽表引擎: 负责海量特征和业务数据的存储查询。
- 搜索引擎: 支持向量检索、全文检索,处理复杂查询。
- 分析引擎: 采用 MPP 分布式框架,处理大规模分析。
- AI 计算引擎: 负责多模态数据的加工(见下文)。
- 灵活接入: 通过 NTS,宽表数据可同步给搜索和分析引擎,无需应用层反复拼接。同时,支持通过 ShortCut 联邦访问外部数据源,实现原地查询或同步纳管。
- 开发友好: 提供统一的智能编排路由引擎,支持 SQL、REST、MCP 等协议,兼容 MySQL/PostgreSQL/OpenSearch 生态,降低了开发者的接入成本。
AI 计算引擎:打通多模态数据链路
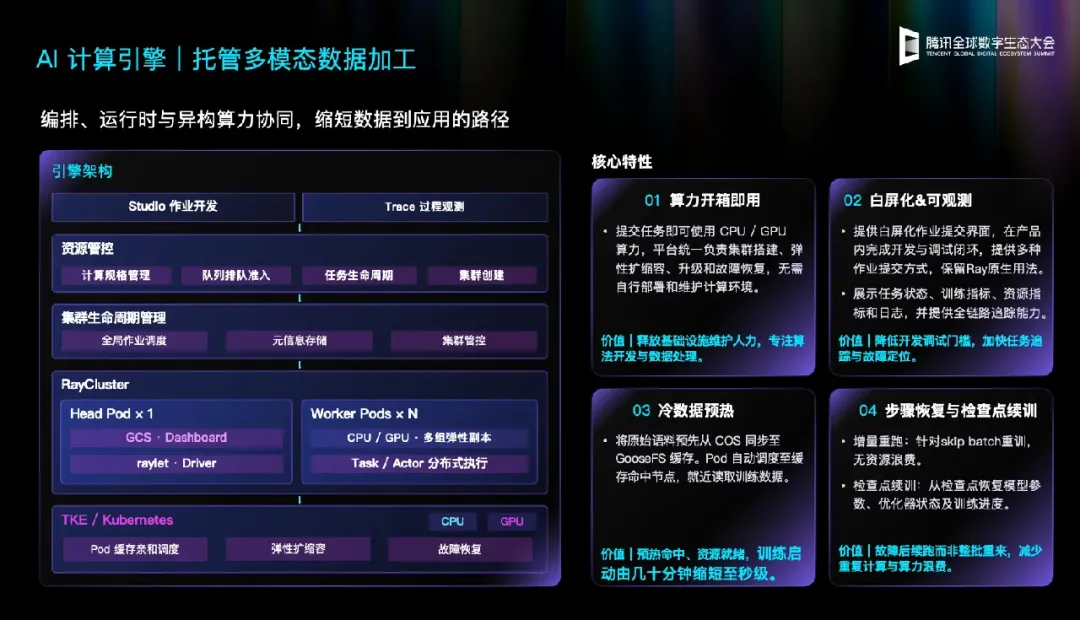
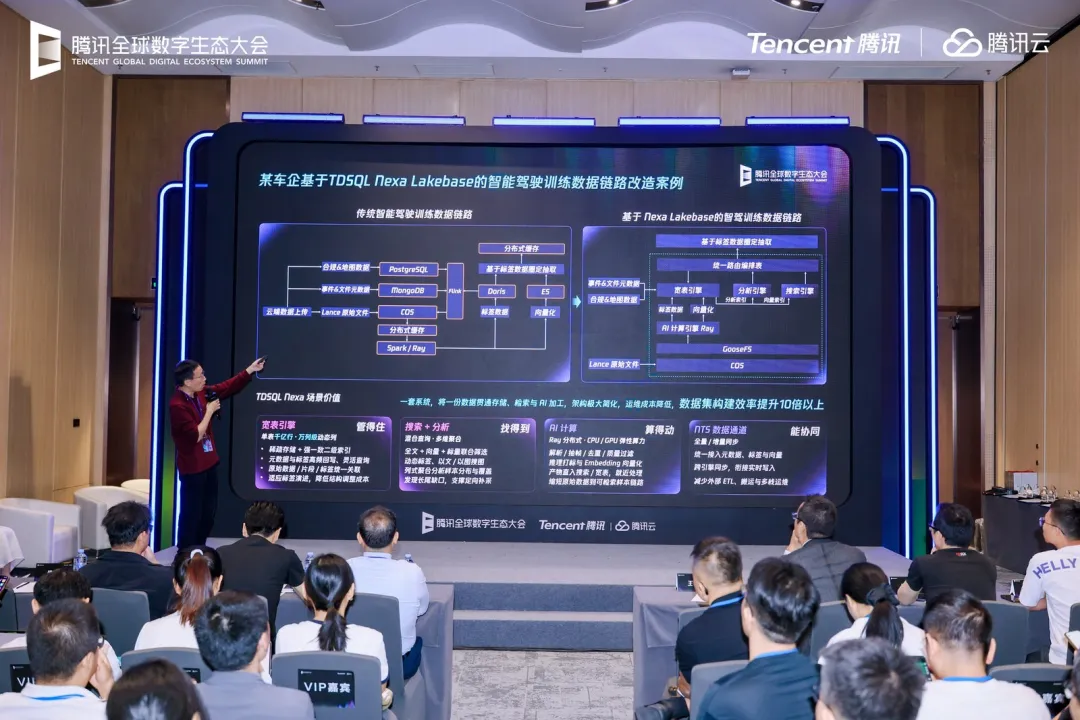
Agent 处理的任务往往包含图片、视频等多模态数据。TDSQL Nexa 将 AI 计算引擎纳入底层架构,实现了从“原始数据”到“可用资产”的端到端处理。
- 全流程处理: 系统统一纳管 CPU/GPU 算力,支持对图片、视频进行解析、抽帧、打标和向量化。
- 数据闭环: 加工后的向量、标签和元数据可直接接入宽表或搜索引擎,供后续检索和训练使用。这对于算法团队准备训练数据、筛选长尾样本(如智能驾驶场景)非常有价值,减少了不同系统间的数据搬运和重复加工。
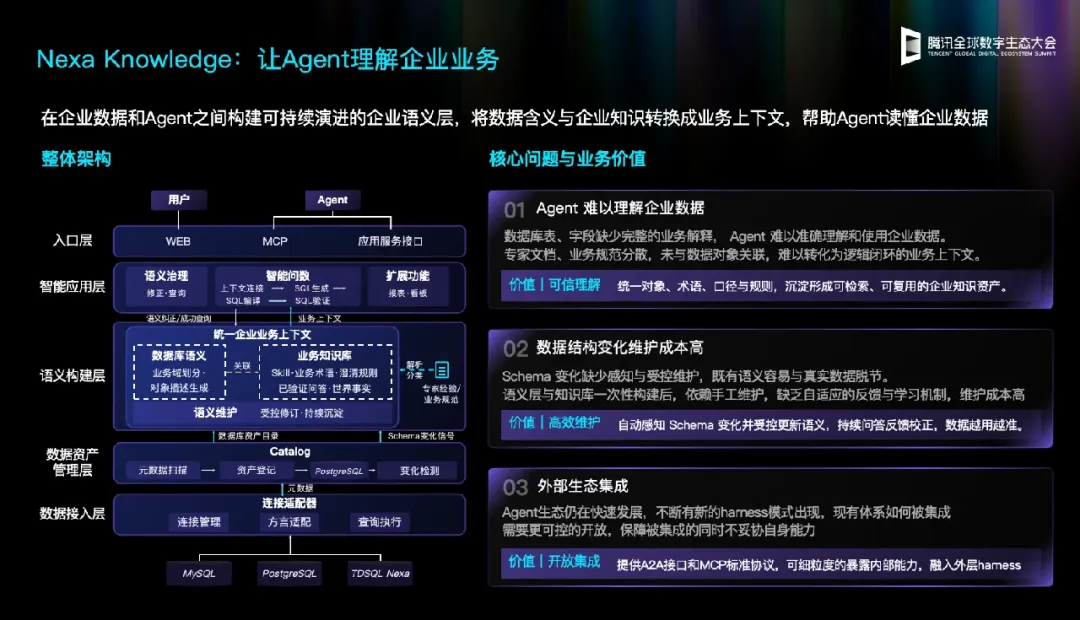
Nexa Knowledge:注入业务语义,让 Agent 会思考
这是 TDSQL Nexa 最具创新性的部分。它试图在数据结构之上,构建一套 “企业知识库”。
- 构建语义层: 系统自动从数据库中提取表、字段和关联关系,并允许企业补充指标定义、业务术语、专家经验等。
- 知识资产沉淀: 将这些信息整理为 Skill(技能)、术语、澄清规则、已验证问答和世界事实五类资产。
- 辅助决策: 当 Agent 接到查询任务时,可以检索这些知识,明确应遵循的指标口径和查询方法。这有效减少了模型仅凭猜测生成错误 SQL 的情况。
3. 实战价值与总结
从智能驾驶领域的长尾样本筛选,到教育行业的多模态数据管理,TDSQL Nexa 的架构展示了其强大的适应性。
对于开发者和 AI 使用者而言,这套架构的核心价值在于:
- 降本增效: 通过多引擎协同和联邦访问,大幅减少了数据同步和搬运的成本。
- 提升准确性: 通过 Nexa Knowledge 解决了“数据与业务脱节”的问题,让 Agent 的回答更符合企业实际规则。
- 简化开发: 统一的访问接口和编排逻辑,屏蔽了底层复杂的引擎差异。
TDSQL Nexa 不仅是一个数据库,更是一个面向 Agent 时代的“数据操作系统”。它正在重新定义数据库在企业智能应用中的角色。