AA v5 更新:AI 基准测试的困境与行业新风向
AI 基准测试的“登山”困境:解读 Artificial Analysis v5
提高分数很容易,但知道要攀登哪座山很难。在 AI 领域,独立评估机构面临着巨大的挑战:既要为模型打分,又要捕捉社区的情感和科学分析,同时还要确保这个单一数字在三个月内不会过时。
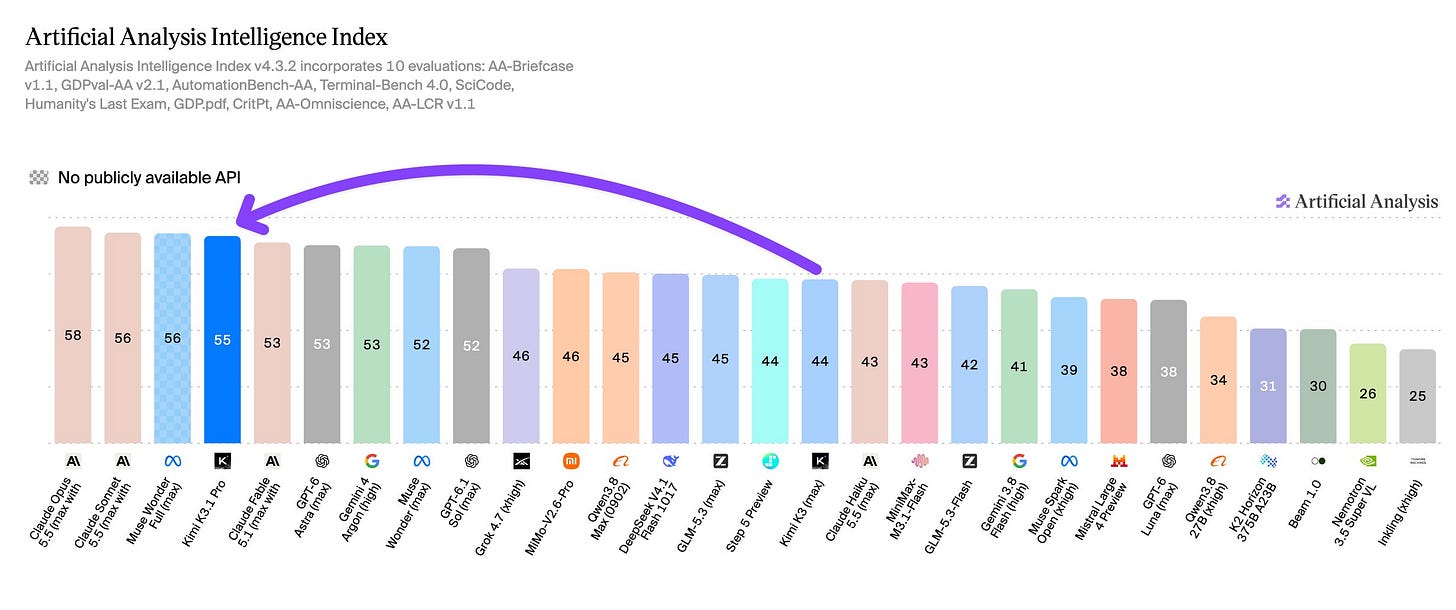
Artificial Analysis (AA) 作为目前最前沿的独立智能指标之一,刚刚发布了其 Intelligence Index 的 v5 版本。这次更新不仅反映了 AI 能力的演变,更揭示了当前基准测试行业的深层矛盾。
v5 版本的核心权重变化
AA v5 将评估维度细分为四个主要领域,各占 25% 的权重,旨在更贴近“现实世界的使用场景”:
- 知识工作 (25%):包含 AA-Briefcase (15%)、AutomationBench-AA (5%) 和 GDP.pdf (5%)。
- 编码能力 (25%):由 FrontierCode 2.0 (15%) 和 Terminal-Bench 4.0 (10%) 组成。
- 科学研究 (25%):涵盖 Terminal-Bench-Science (15%) 和 CritPt v2 硬核子集 (10%)。
- 通用能力 (25%):结合了 AA-Omniscience v1.1 (15%,侧重准确性和去幻觉) 和 HLE-Diamond (10%)。
基准测试的悖论与市场权力
建立基准测试本质上是一个悖论。为了方便讨论和报告,我们需要将复杂的多维度表现压缩成一个单一的数字,但任何聚合方法都会带来权衡和偏差。
对于评估机构而言,他们的分量极重。他们不仅决定了谁是 AI 市场的赢家,还在潜移默化中引导着模型开发的走向。因此,如何在“绝对前沿能力”和“重复性代理任务技能”之间找到平衡,是像 AA 这样的机构必须解决的难题。
开源模型在编码领域的突围
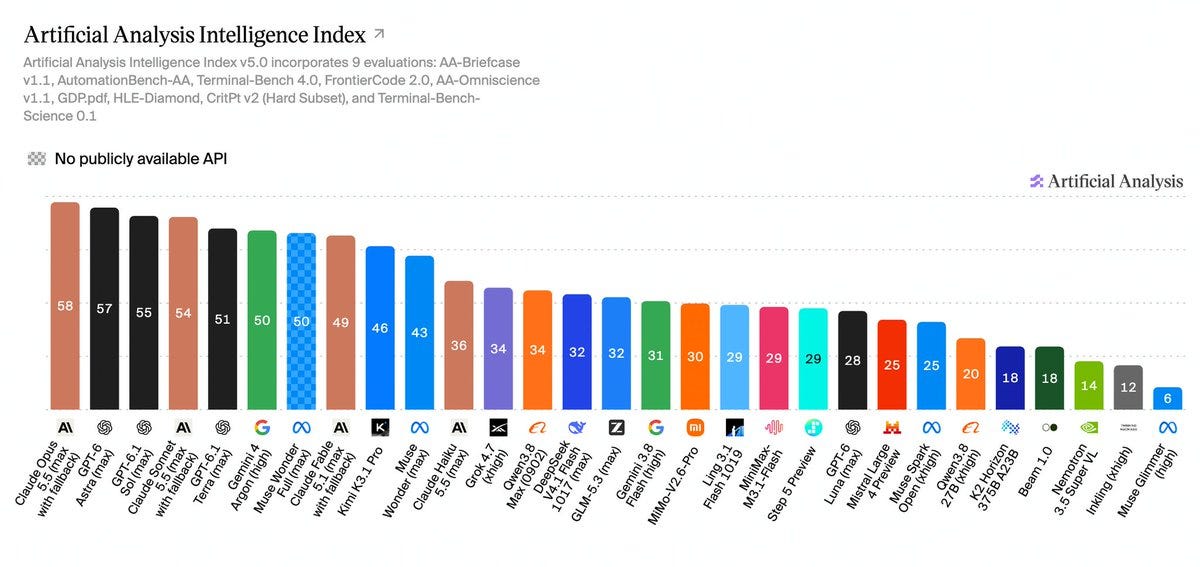
在最新的 AA v5 排名中,GPT-6.1 Terra 胜出了 Claude Fable 5.1,但这并不能完全代表所有场景。AI 现实世界的表现往往是“锯齿状”的,即在不同任务上表现差异巨大。
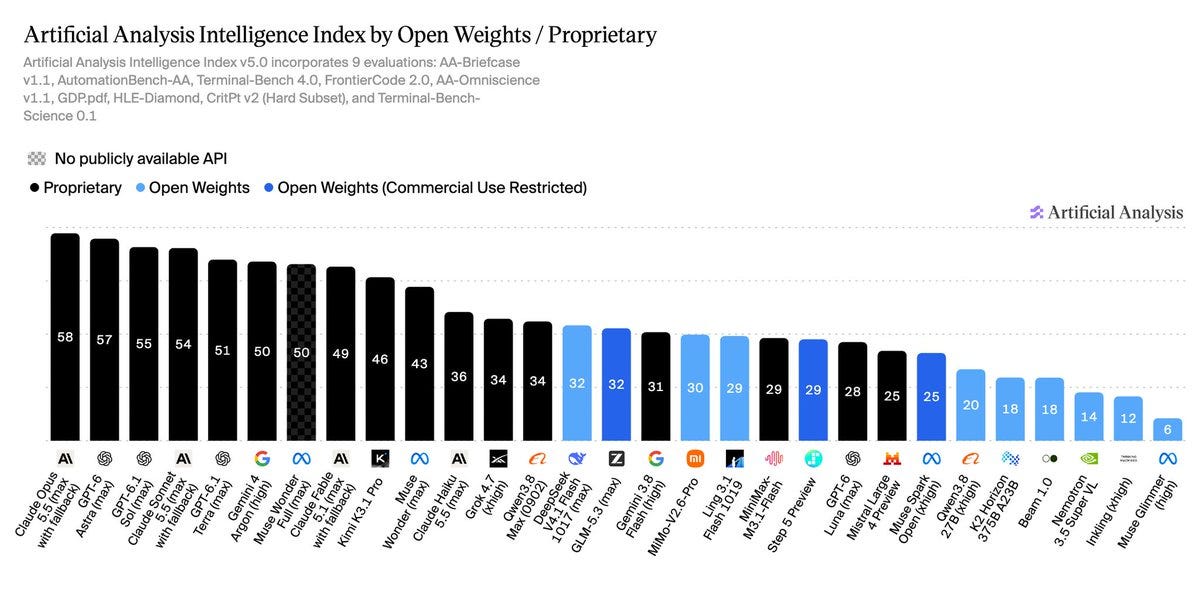
从实用角度看,编码是目前开源模型最有可能与闭源模型抗衡的领域。在 AA v5 的测试中,开源模型在编程任务上展现出了极强的竞争力。而在知识工作等更复杂的领域,闭源模型依然保持着优势。
总结与展望
AA v5 的更新展示了 AI 基准测试的复杂性。虽然它试图通过多元化的测试集来模拟真实世界,但单一排名依然存在局限性。
对于开发者而言,这意味着在选择模型时,不能仅看总分。如果你专注于代码生成,开源模型可能已经足够好;但如果涉及深度的知识工作或科学分析,闭源模型可能仍是首选。随着 AI 能力的快速扩张,我们或许需要告别单一的“智能指数”,转向更加多维度的评估体系。
本文目录(4 节)
本文基于 Interconnects 的公开内容,由 AI 辅助整理改写后发布。
原标题:Artificial Analysis v5 and the benchmarker's dilemma
阅读原文