2026上半年LLM必读论文清单
为什么要关注论文清单
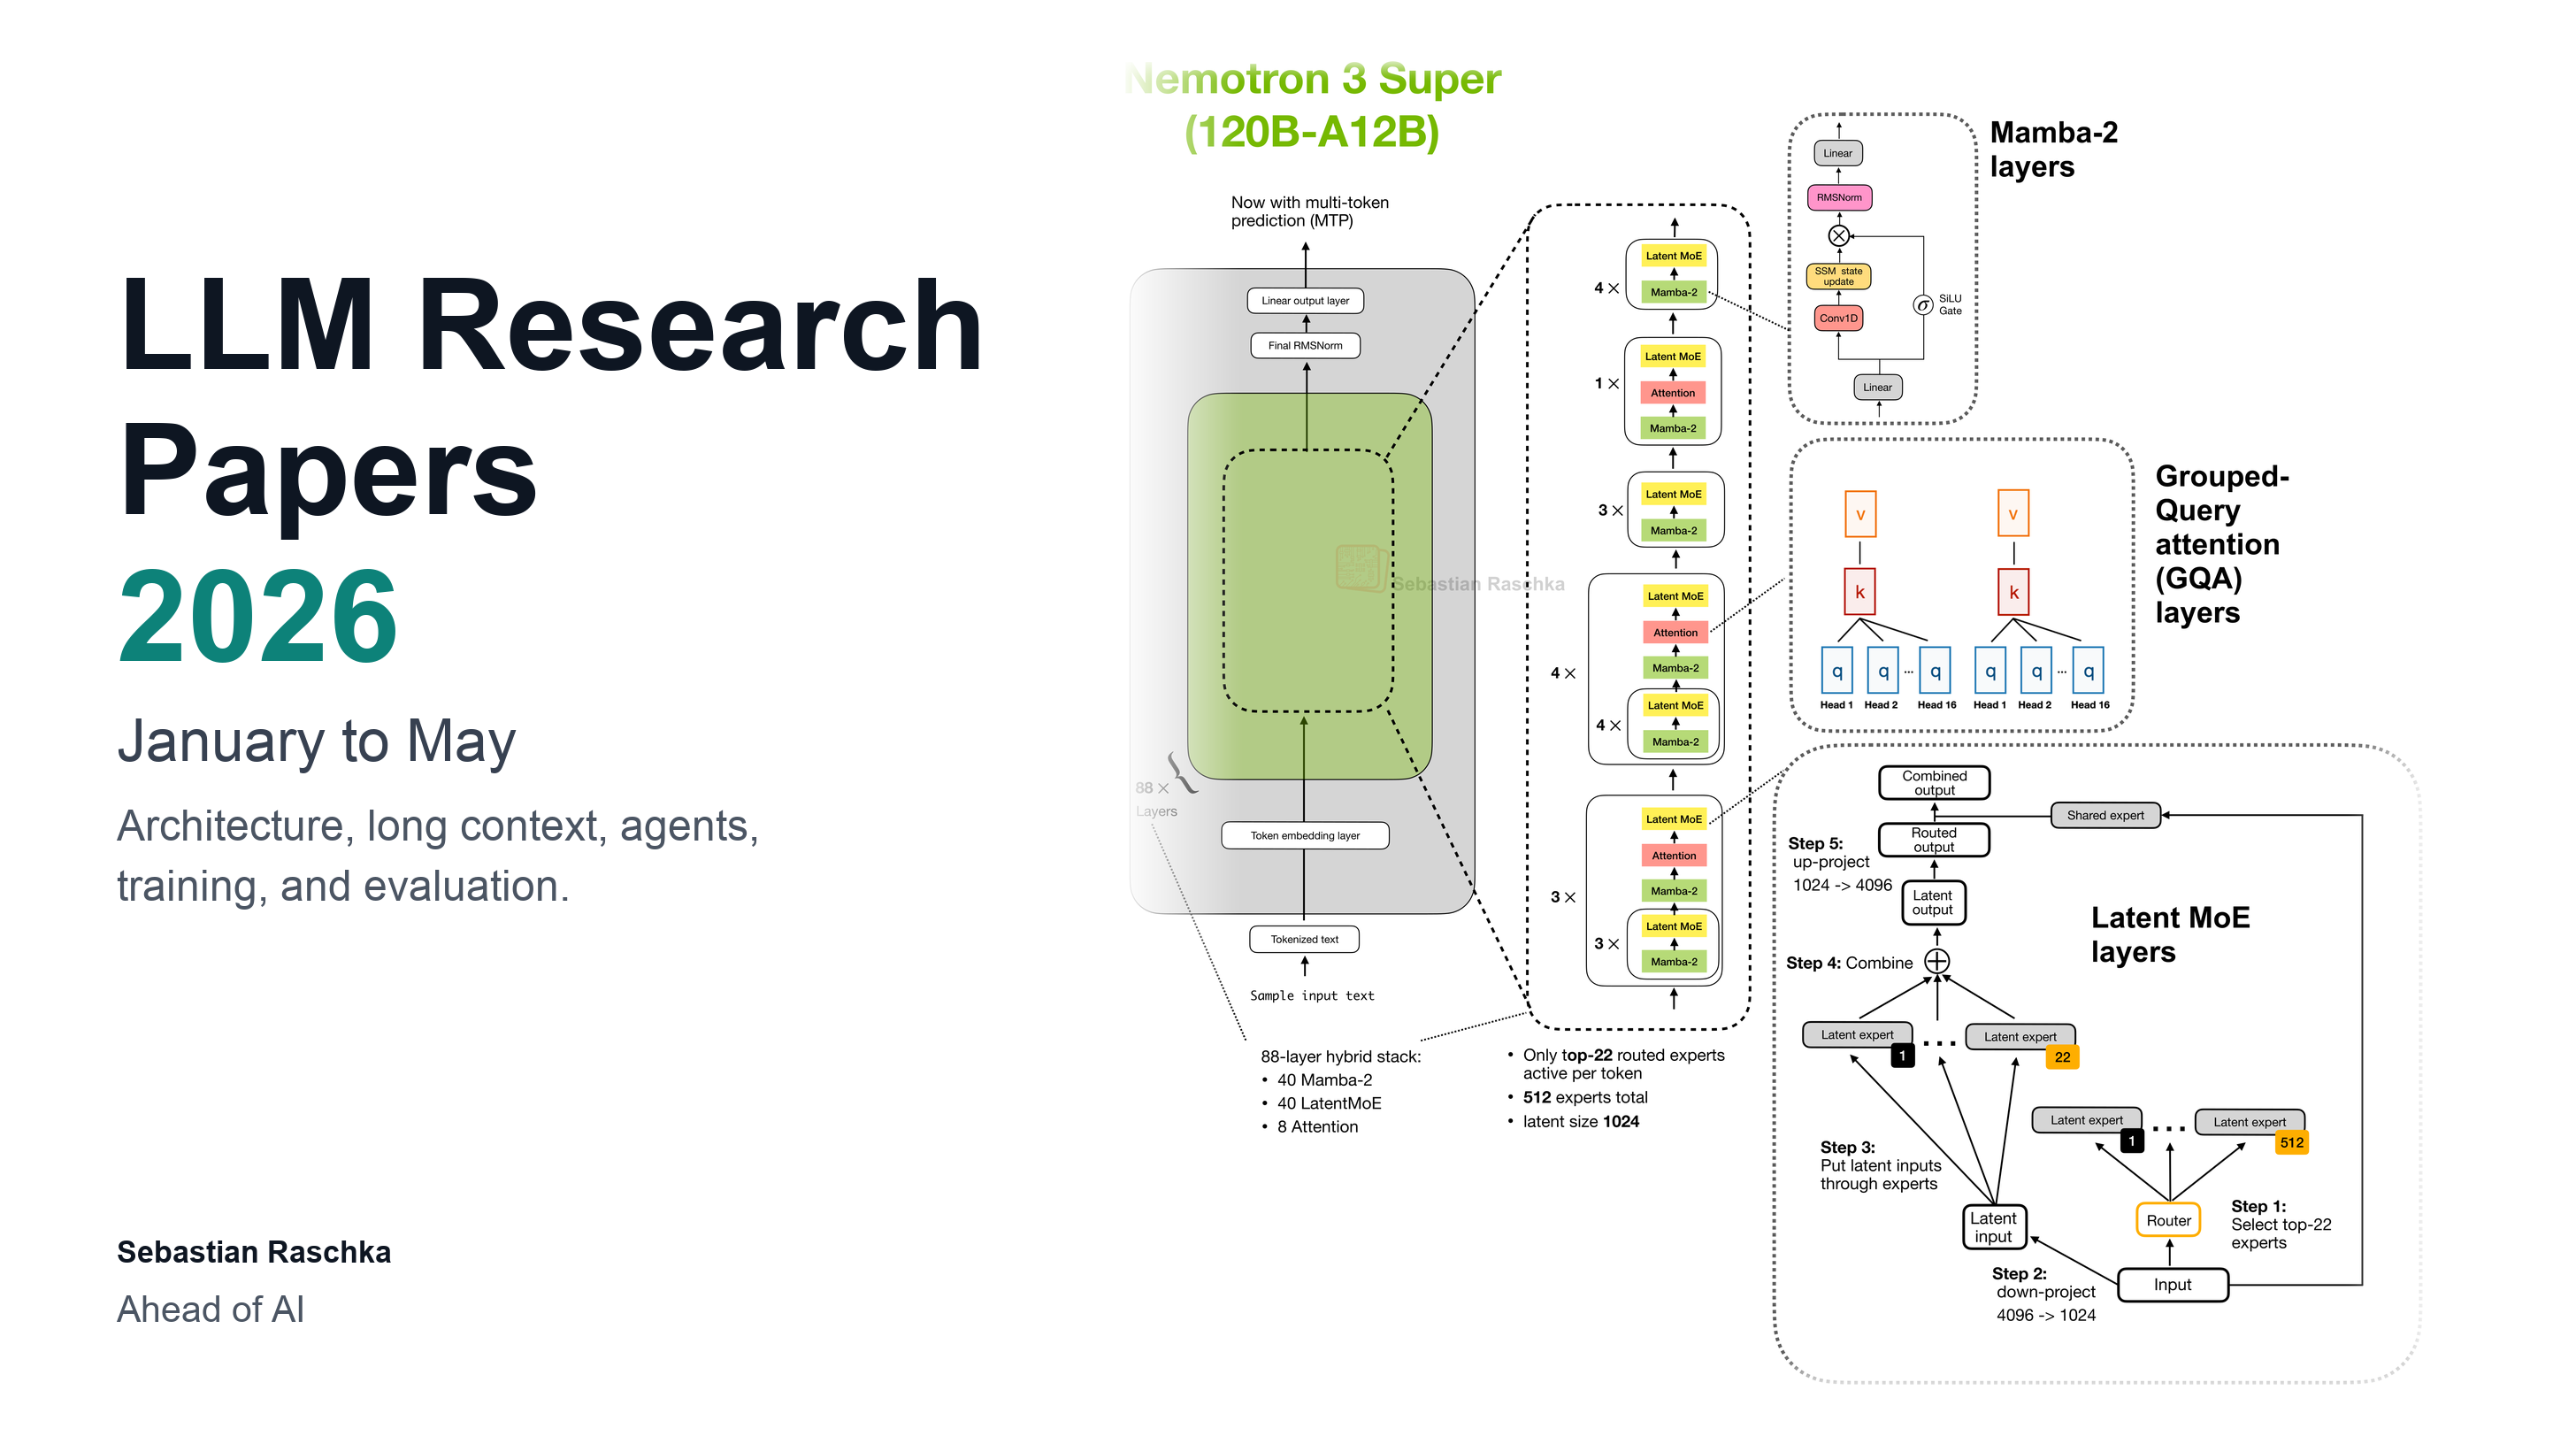
在 LLM 论文爆炸式增长的今天,每天新论文数量庞大到不可能全部阅读。Sebastian Raschka 延续往年习惯,整理了一份 2026 年 1 至 5 月的精选论文清单,覆盖架构设计、推理效率、强化学习、智能体系统等核心方向。这份清单并非穷举,而是基于作者个人研究方向的精选,但每一篇都值得开发者重点关注。
架构与模型设计:超越"更大"
2026 年的架构研究不再局限于堆叠更大的 Transformer 层。值得关注的工作包括:
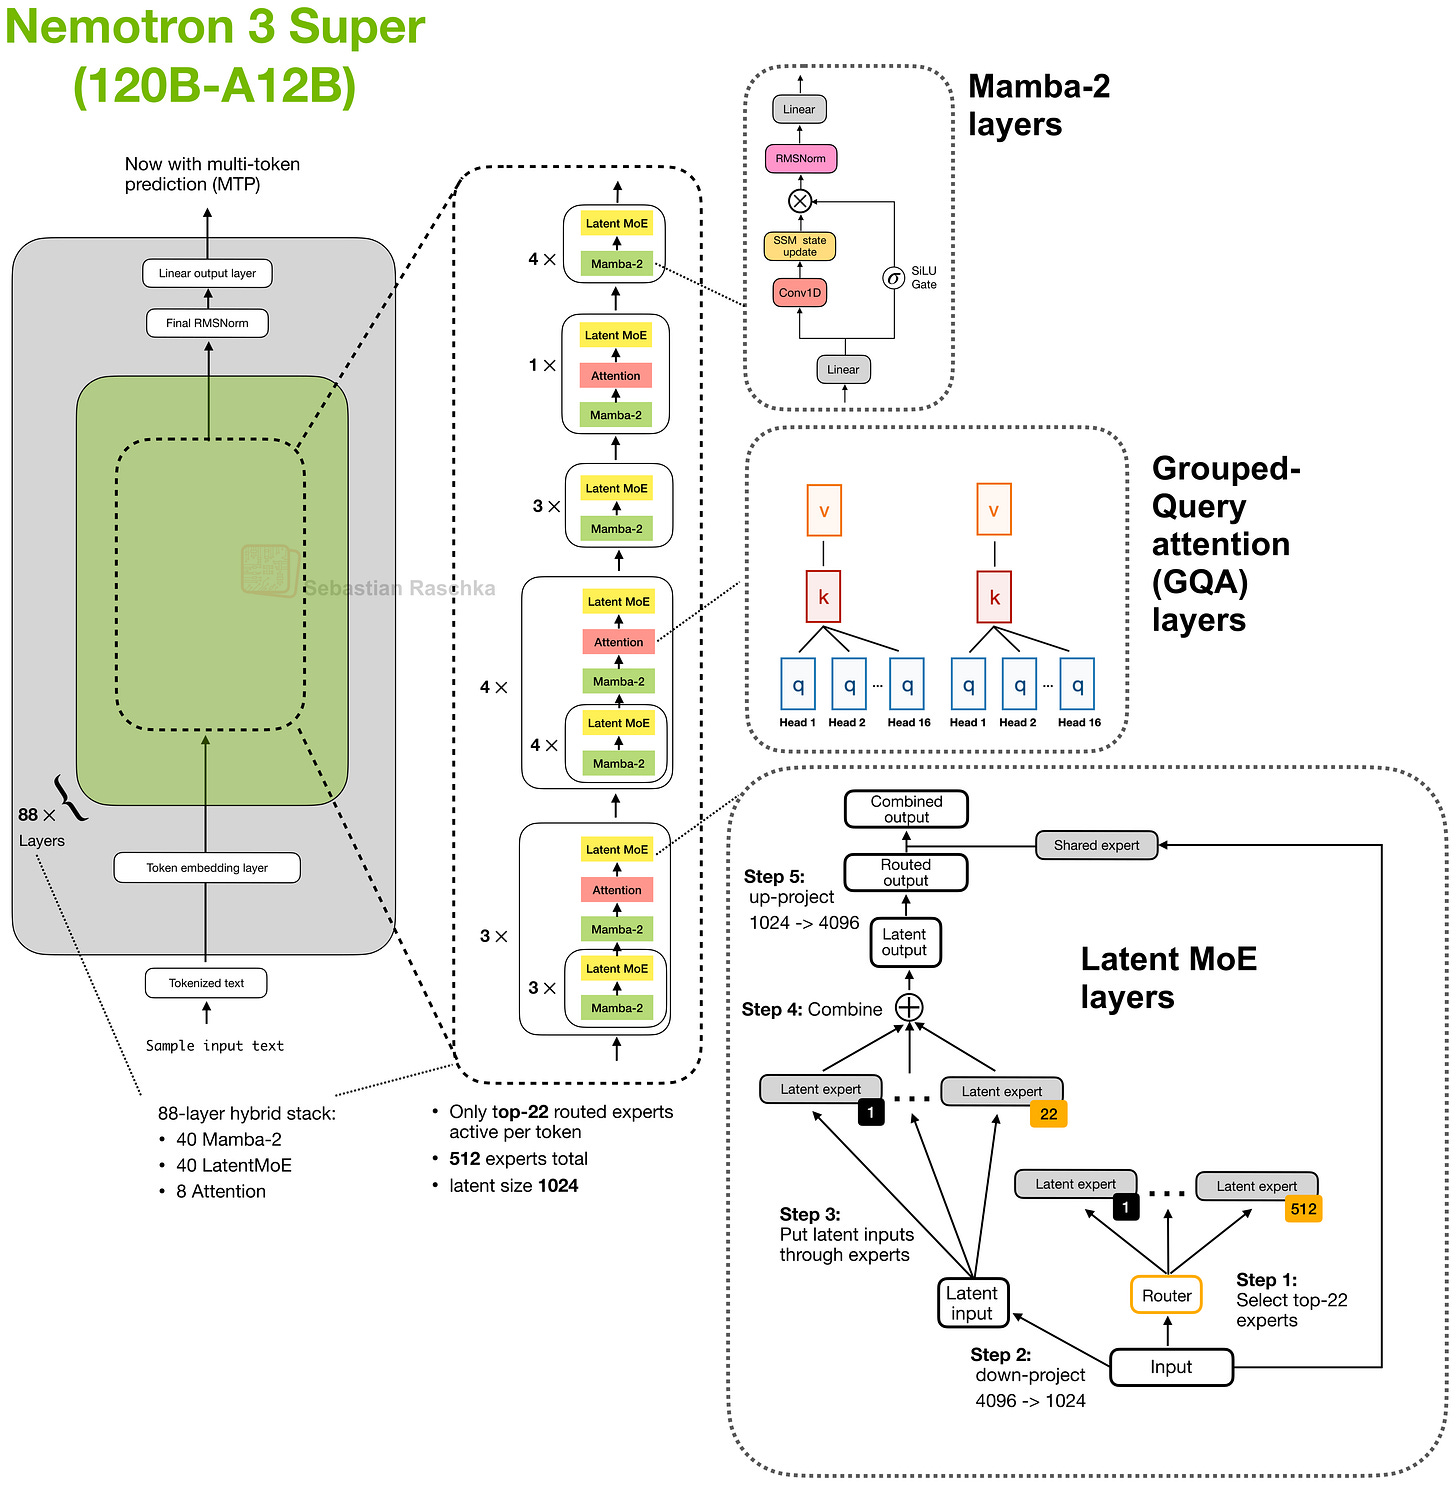
- 混合架构:Nemotron 3 和 Arcee Trinity 交替使用标准注意力层与 Mamba-2 状态空间层,在长上下文场景下效率显著提升
- MoE 容量分配:Scaling Embeddings Outperforms Scaling Experts 和 Step 3.5 Flash 探索了专家混合模型的容量优化
- 激活行为分析:The Spike, the Sparse and the Sink 揭示了模型激活的稀疏性规律
- 表示几何:Symmetry in Language Statistics Shapes the Geometry of Model Representations 从统计对称性角度解释模型表示结构
其中 Nemotron 3 Super 被作者列为必读,原因是它描述了已在生产环境中部署的模型技术,且是该规模级别的最佳模型之一。其 120B-A12B 参数配置对本地推理有较高硬件要求,但同系列也有更轻量版本可选。
推理效率与长上下文
随着 LLM 越来越多地被接入智能体框架(如 OpenClaw 等),长上下文效率成为核心竞争点。相关论文涵盖:
- KV Cache 优化与压缩
- 稀疏注意力机制(Sparse Attention)
- 长上下文下的推理加速
这些方向对实际部署场景(如代码助手、文档分析)具有直接工程价值。
推理与测试时计算
推理模型仍是今年论文的重头戏。测试时计算(Test-Time Compute)方向探索了如何在推理阶段通过更多计算换取更高准确率,这对需要高精度输出的应用场景(如数学推理、代码生成)尤为重要。
强化学习与 RLVR
强化学习在 LLM 训练中的应用持续深化,RLVR(Reinforcement Learning with Verifiable Rewards)方向通过可验证奖励信号提升模型可靠性,是提升模型实用性的关键技术路径。
智能体系统与工具使用
与 2025 年相比,2026 年上半年的论文明显增加了智能体框架、工具调用、软件工程智能体相关内容。这反映了行业趋势:LLM 正从"对话工具"向"自主执行任务的智能体"演进。相关论文对构建实际可用的 Agent 系统有直接参考价值。
扩散语言模型与评估基准
扩散语言模型(Diffusion Language Models)作为生成范式的新方向,今年开始获得更多关注。模型评估与基准测试方向则提供了衡量模型能力的标准化方法。
对开发者的实用建议
- 关注混合架构:Mamba 与 Transformer 的结合是长上下文效率的关键突破
- 重视智能体工程:工具调用和任务规划能力已成为 LLM 应用的核心竞争力
- 部署时考虑推理优化:KV Cache 压缩和稀疏注意力可显著降低推理成本
- 利用论文清单做技术选型:在引入新技术前,先查阅相关论文了解其原理和局限性
这份清单的价值在于,它帮你从海量论文中快速定位值得深入阅读的方向,节省大量筛选时间。